内存模型与规约优化
累加求和
- 两个数相加并行,如果需要进一步算子融合的话,那可以尝试累加求和,提高并行效率
- 把一个连续数组里的多个数字(这里是都是1)累加成一个数
template <typename T>
__global__ void sum_kernel(T *result, const T *input, size_t n) {
    size_t idx = blockIdx.x * blockDim.x + threadIdx.x;
    if (idx < n) {
        *result += input[idx];
    }
}

-
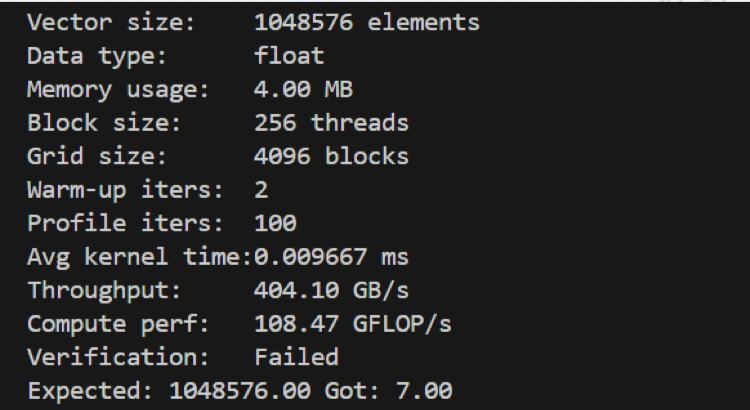
Failed:多线程同时写同一个内存地址导致的竞态条件(Race Condition)
- Thread0和Thread1同时读取result初始值——0,然后分别去input[0],input[1]上获取value,0+1=1,再先后写回result,result被赋值2次一样的结果
-
之前的加法是两个线程从两个数组,循环遍历取数,再相加填入result
-
解决方案:确保顺序执行,同时只能有一个写入操作
原子操作
原子操作(Atomic Operation):把代码改成 atomicAdd(result, input[idx]);不允许别的线程插队。
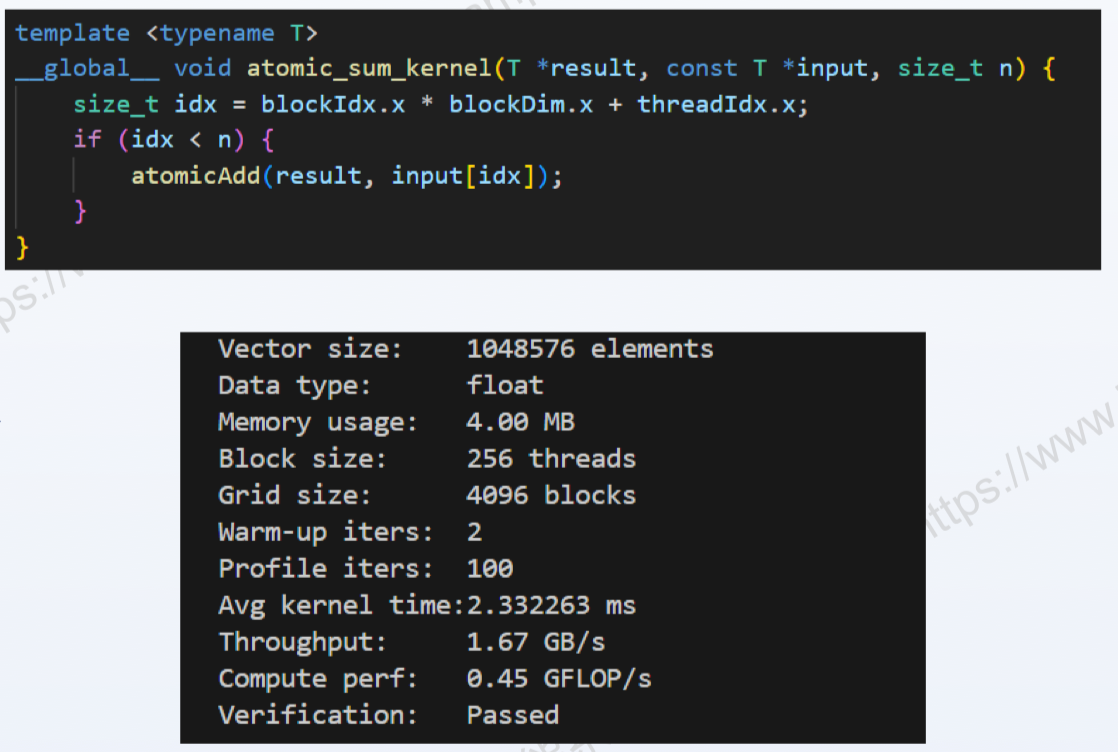
- 运行时间增加了很多,比原来在这个情况下慢了两百多倍
查看ncu:
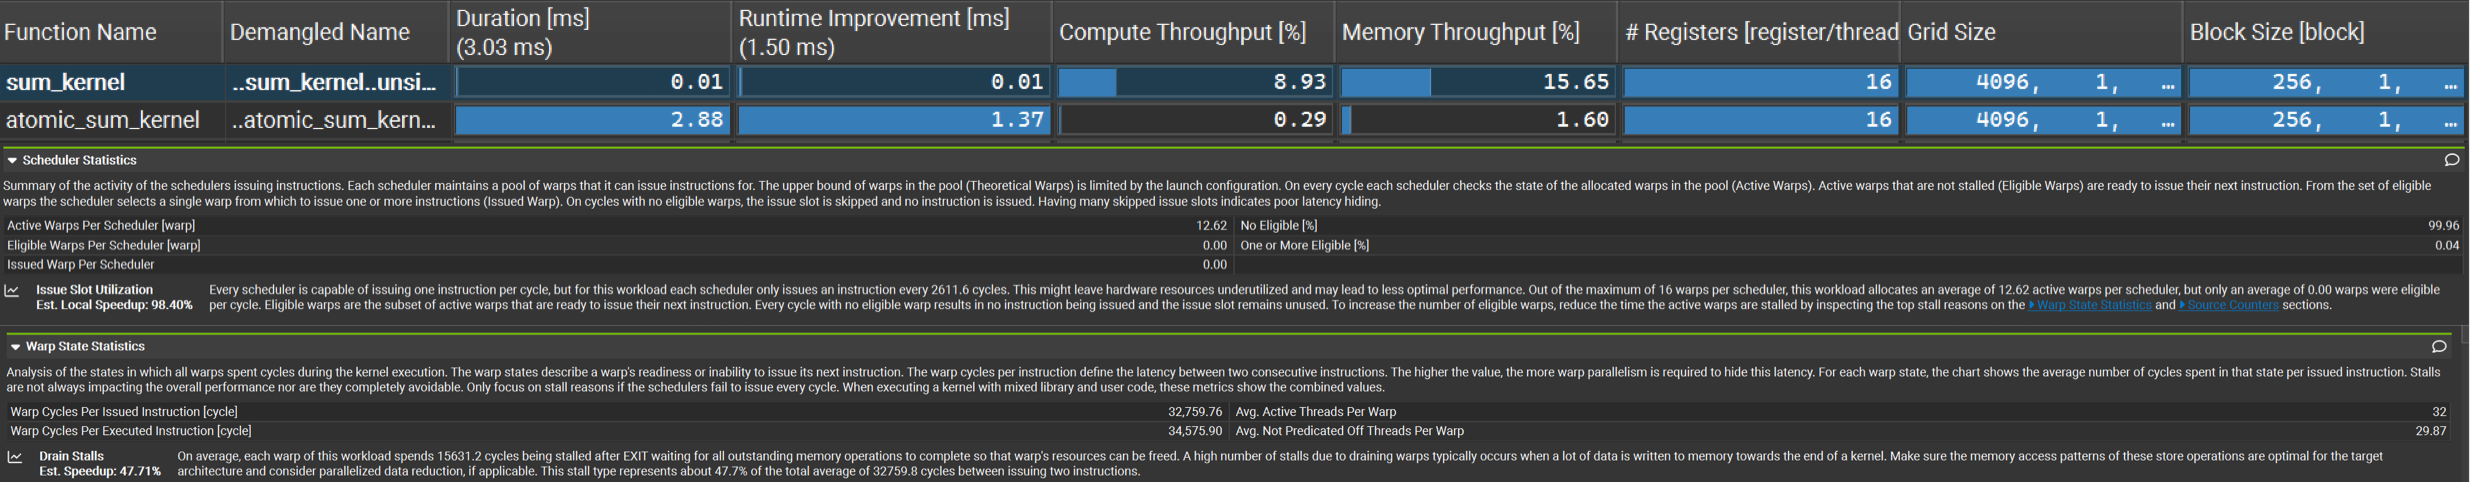
- 计算与内存吞吐/利用率都很低,很多线程都在闲置→ 原子操作导致线程之间完全串行
那如果不要让所有线程都去写全局内存,使用分治的思想,不需要每个线程都直接加到最终的 result 里
并行归约
并行归约(Parallel Reduction)(高性能计算的标准做法):不要让所有线程都去写全局内存
- 先让一个 Block 里的 256 个线程,各自进行局部求和(比如用树形结构两两相加),最后只剩 1 个值
- 然后每个 Block 只需要派 1 个线程,把这个 Block 的局部总和,通过
atomicAdd加到全局的*result里。全局内存的竞争次数瞬间从 100 万次降低到了 4096 次,性能会提升成百上千倍
template <typename T>
__global__ void reduce_warp_global_kernel(T *output, const T *input, size_t n) {
    size_t tid = threadIdx.x;
    unsigned int lane_id = tid % 32;
    size_t idx = blockIdx.x * blockDim.x + tid;

    // Lane 0 thread in the warp accumulates the sum
    if (lane_id == 0) {
        T warp_sum = 0;

        // Loop over the 32 threads in the warp
        for (int i = 0; i < 32; ++i) {
            for (int j = idx + i; j < n; j += blockDim.x * gridDim.x) {
                warp_sum += input[j];
            }
        }

        // Atomically add this warp's sum to the final output
        atomicAdd(output, warp_sum);
    }
}- Lane: 一个 warp 中的一个线程
- grid-stride 循环规约出跨总线程数的 partial sum
- 每个 warp 内选一个线程(第一个)进行循环累加
- Warp 之间通过 atomicAdd 累加
template <typename T>
__global__ void reduce_warp_global_kernel(T *output, const T *input, size_t n) {
    size_t tid = threadIdx.x;
    unsigned int lane_id = tid % 32;
    size_t idx = blockIdx.x * blockDim.x + tid;

    if (lane_id == 0) {
        T warp_sum = 0;
        const size_t step = blockDim.x * gridDim.x;
        const size_t total_elements = ((n - idx) + step - 1) / step;

        for (size_t linear_idx = 0; linear_idx < total_elements * 32; ++linear_idx) {
            const size_t segment = linear_idx / 32;
            const size_t lane = linear_idx % 32;
            const size_t j = idx + segment * step + lane;

            if (j < n) {
                warp_sum += input[j];
            }
        }

        atomicAdd(output, warp_sum);
    }
}
以上是基于warp为单位进行规约的,那如果使用block作为一个单位规约是什么效果呢?
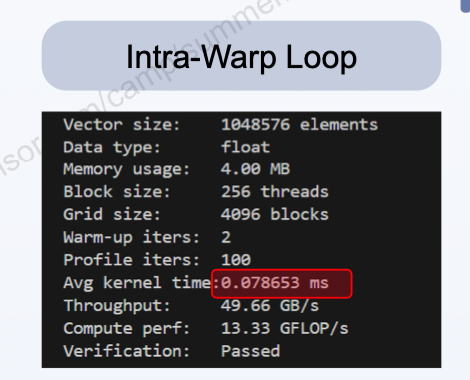
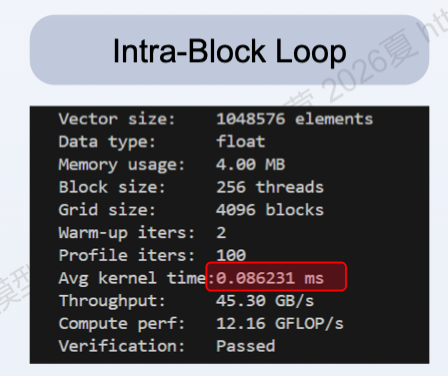
性能降低了???
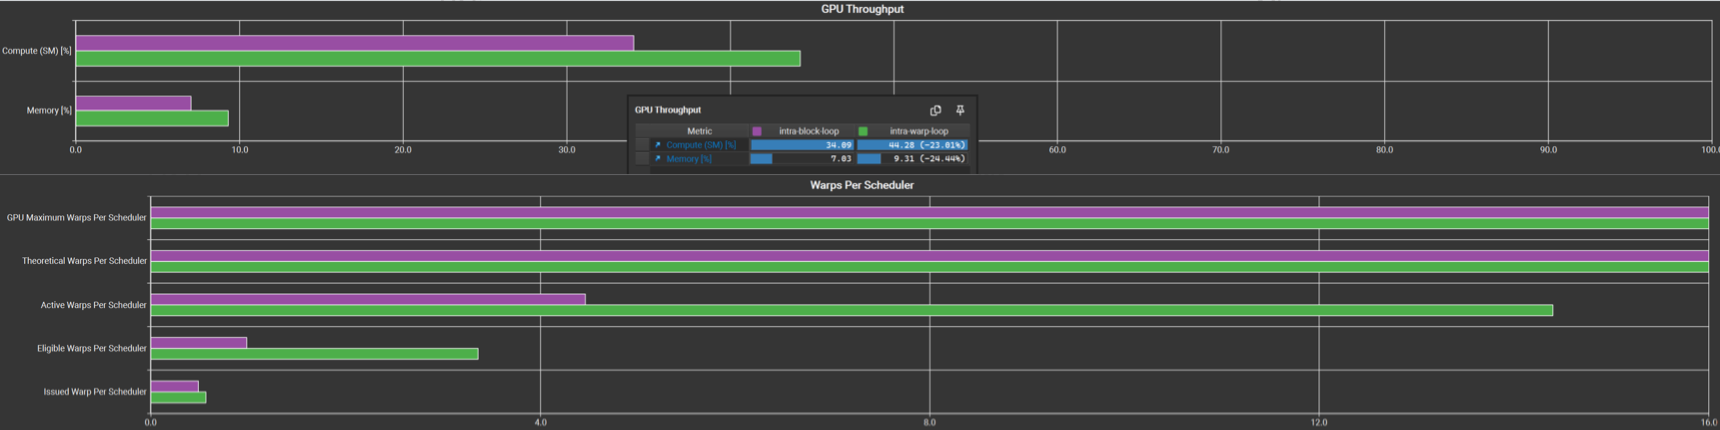
Intra-block 的比 intra-warp 的版本计算利用率和活跃 warp 数都要低不少
虽然减少了原子累加的操作数,但单个线程的计算量增加太大,利用率/效率变低
Memory Hierarchy
能否通过其他内存空间,存储一个warp里所有线程的读取结果呢?

- 越靠近上层/处理器/计算单元→越快、越小、越贵→ 存放更常用的数据和指令
- 越靠近下层→越慢、 越大、越便宜→ 存放更不常用/更大规模的数据和指令
内存结构
Blog:Memory Types in GPU
物理层面
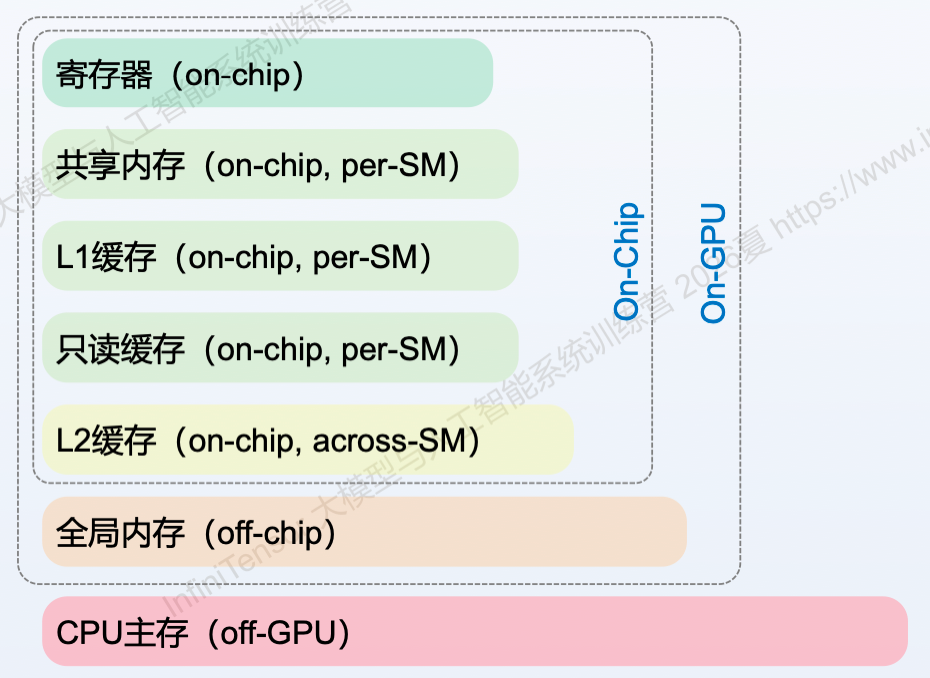
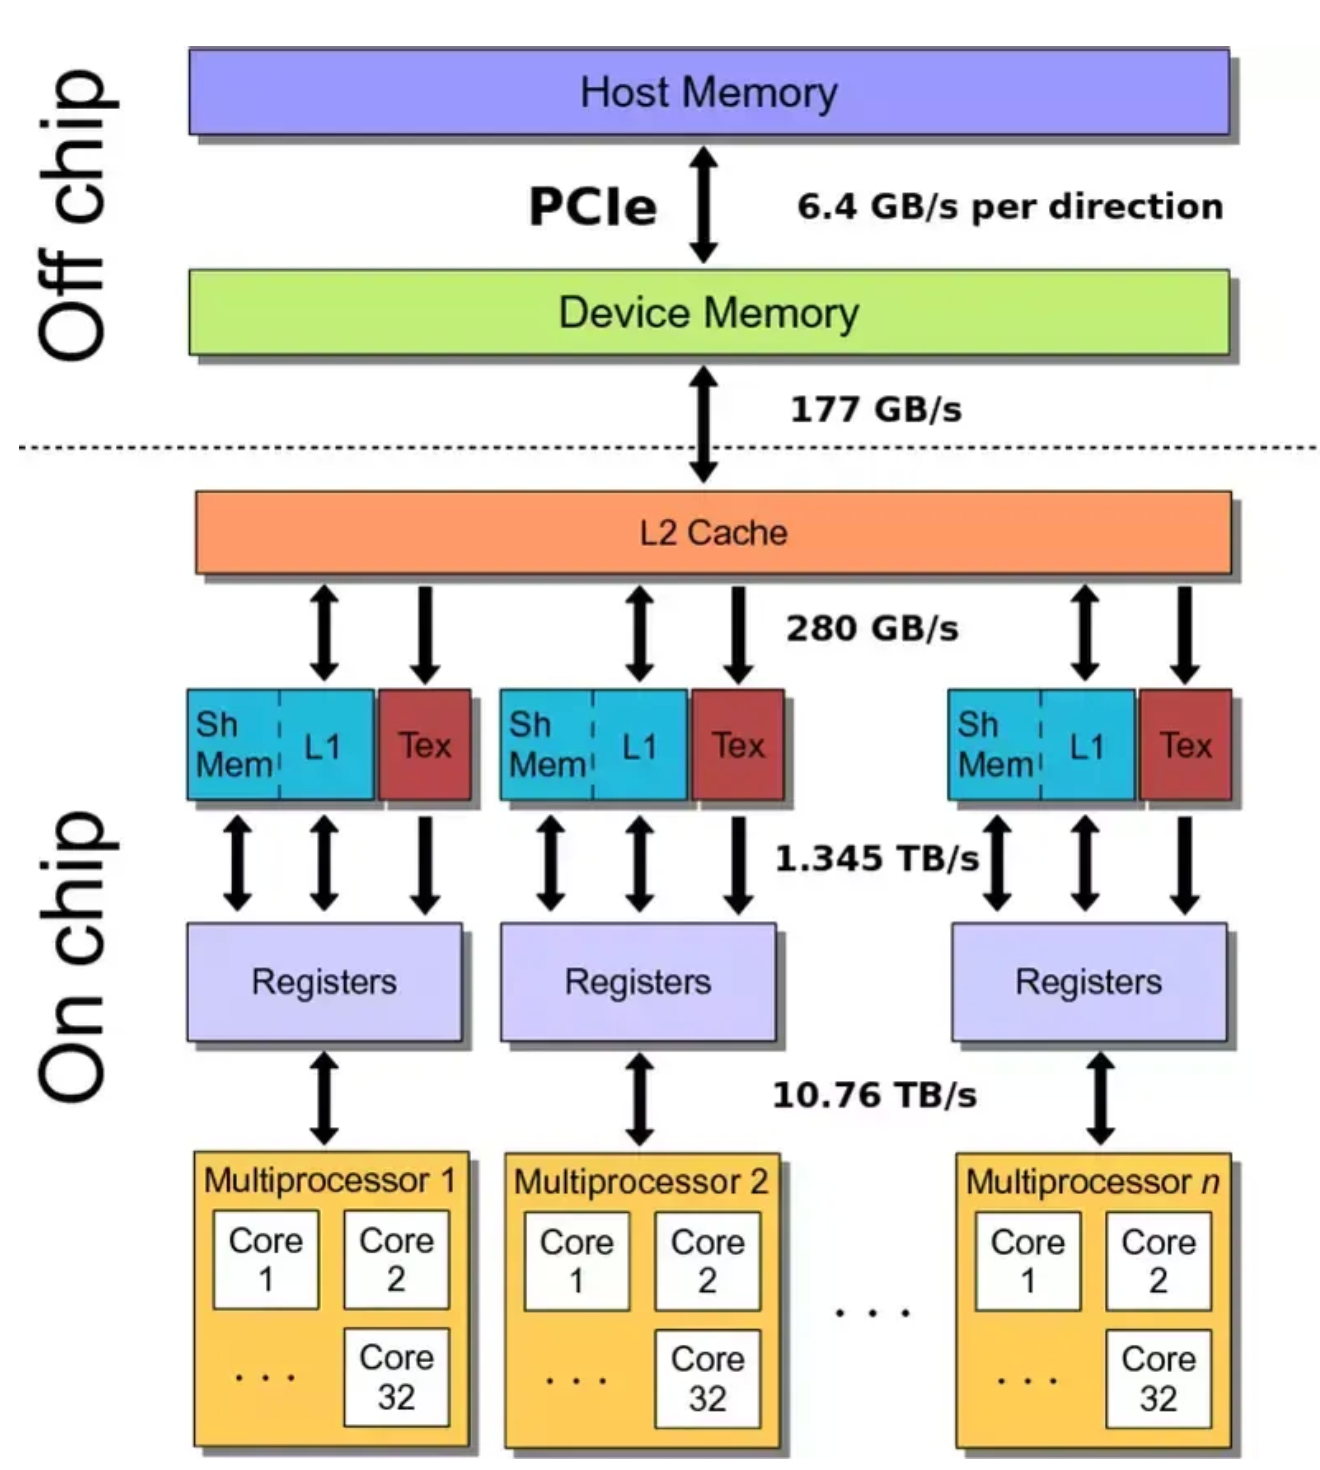
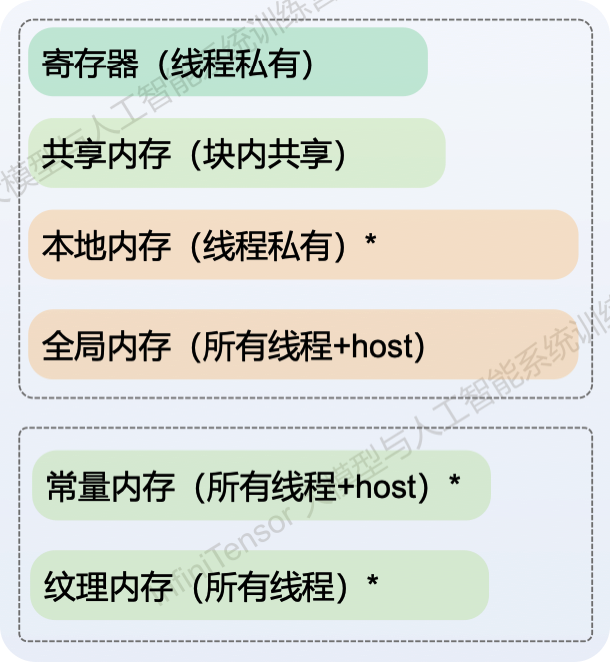
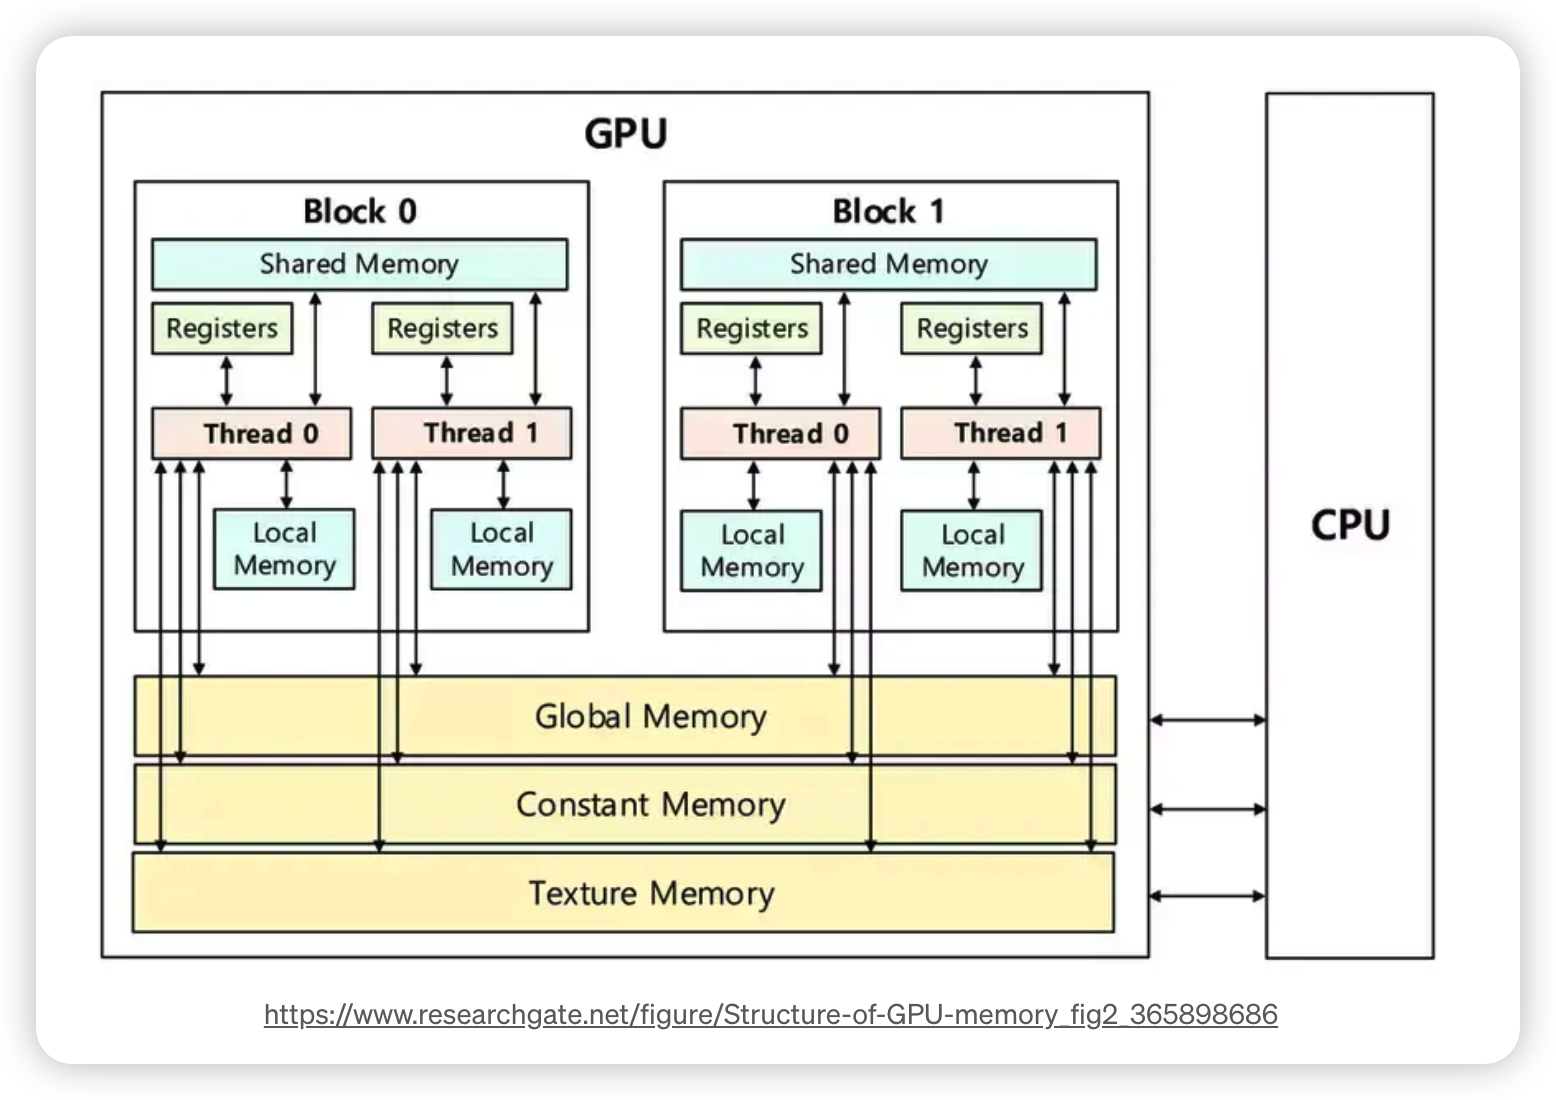
逻辑层面
-
本地内存本质上其实就是全局内存划出来的空间,访问本地内存其实就是访问全局内存(所以比寄存器慢很多)
-
常量内存:只有 64 KB(非常小),属于“所有线程+host”共享。只能由 Host(CPU)端通过
cudaMemcpyToSymbol写入,GPU端只读- 核心特性:广播(Broadcast)机制
- 当一个 Warp 同时访问常量内存时,如果这32个线程读取的是同一个地址,硬件会将其优化为一次广播,只需一个时钟周期就能把同一个值分发给所有线程。此时速度极快,接近寄存器速度
- 适合的场景:数学常数(如 π)、核函数的参数、模型的权重(当所有线程都读取相同的权重时)。比如在神经网络中,所有神经元都要乘以同一个偏置量
-
纹理内存:没有独立的大小限制,它是全局内存的“视图”。通过纹理对象(Texture Object)绑定,也是只读
- 适合的场景:图像处理、医学影像、流体力学仿真,以及大数据量的“不规则但邻近”读取。比如读取一个二维数组的左上角邻居
共享内存树形规约
template <typename T>
__global__ void reduce_smem_tree_kernel(T *output, const T *input, size_t n) {
    // 这里的 extern 表示动态分配共享内存
    extern __shared__ T smem[];
    size_t tid = threadIdx.x;
    size_t idx = blockIdx.x * blockDim.x + tid;

    smem[tid] = (idx < n) ? input[idx] : 0;
    __syncthreads();

    for (int s = blockDim.x / 2; s > 0; s >>= 1) {
        // Warp Divergence(线程束分化)
        if (tid < s) {
            smem[tid] += smem[tid + s];
        }
        __syncthreads();
    }

    if (tid == 0) {
        atomicAdd(output, smem[0]);
    }
}

// 调用方式
size_t smem_size = block.x * sizeof(T);
// 核函数发射第三个参数加入动态分配的共享内存大小
reduce_smem_tree_kernel<<<grid, block, smem_size>>>(d_result, d_input, n);
利用共享内存做树状规约:
-
shared: 表示该变量分配至共享内存
-
__syncthreads(): 同步块内线程
- 因为共享内存是大家共用的,必须确保所有线程都把自己的数据写进
smem后,才能开始下一步计算,否则后面的线程会读到空的未初始化数据
- 因为共享内存是大家共用的,必须确保所有线程都把自己的数据写进
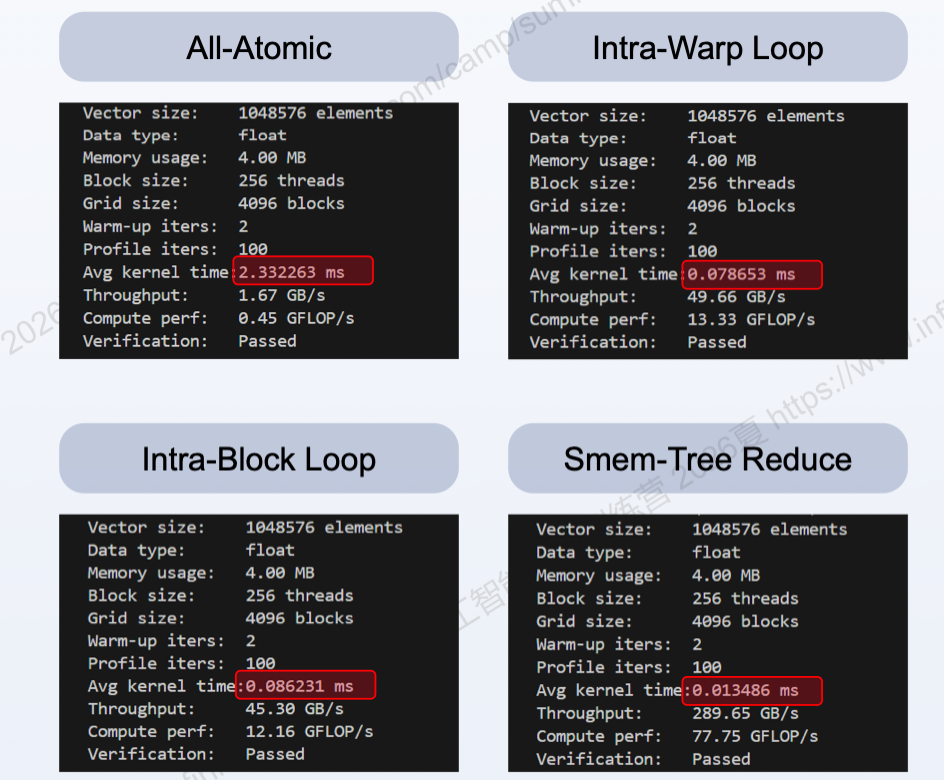
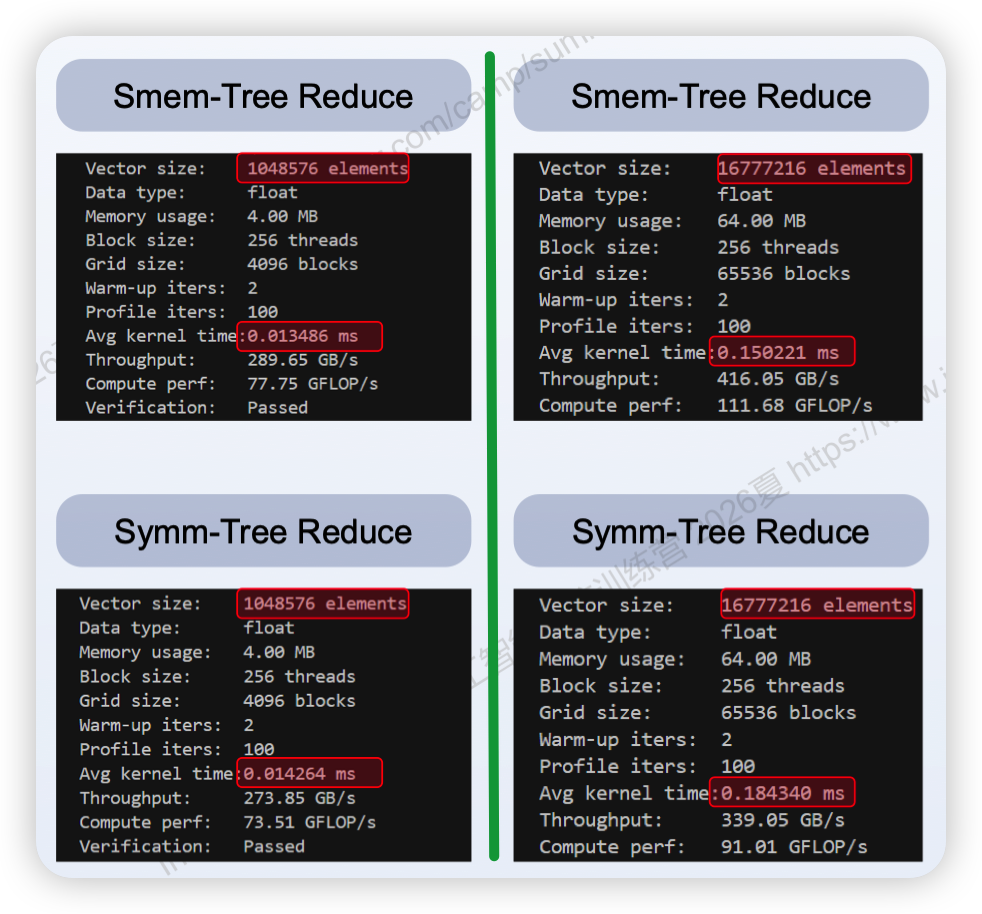
相较于 Intra-Warp: ~5.8x 相较于 Intra-Block: ~6.4x
Warp内规约优化
template <typename T>
__global__ void reduce_warp_shfl_register_kernel(T *output, const T *input, size_t n) {
    size_t tid = threadIdx.x;
    size_t idx = blockIdx.x * blockDim.x + tid;

    T sum = 0;
    for (size_t i = idx; i < n; i += blockDim.x * gridDim.x) {
        sum += input[i];
    }

    for (int offset = 16; offset > 0; offset >>= 1) {
        sum += __shfl_down_sync(0xFFFFFFFF, sum, offset);
    }

    if (tid % 32 == 0) {
        atomicAdd(output, sum);
    }
}- 每个线程利用 Grid-stride 循环,从全局内存中完美合并读取数据(因为
idx连续),并累加到自己私有寄存器sum中 - __shfl_down_sync(): 允许同一个 Warp(32个线程)内的线程,直接读取其他线程寄存器里的值,无需通过共享内存
- 使用 register 无需共享内存和__syncthreads()同步块内线程
- “超出边界反正本值”:如果
Lane 16去读取Lane 32(不存在)的值,硬件会返回Lane 16自己的原始值。所以无需担心边界问题,代码极其简洁
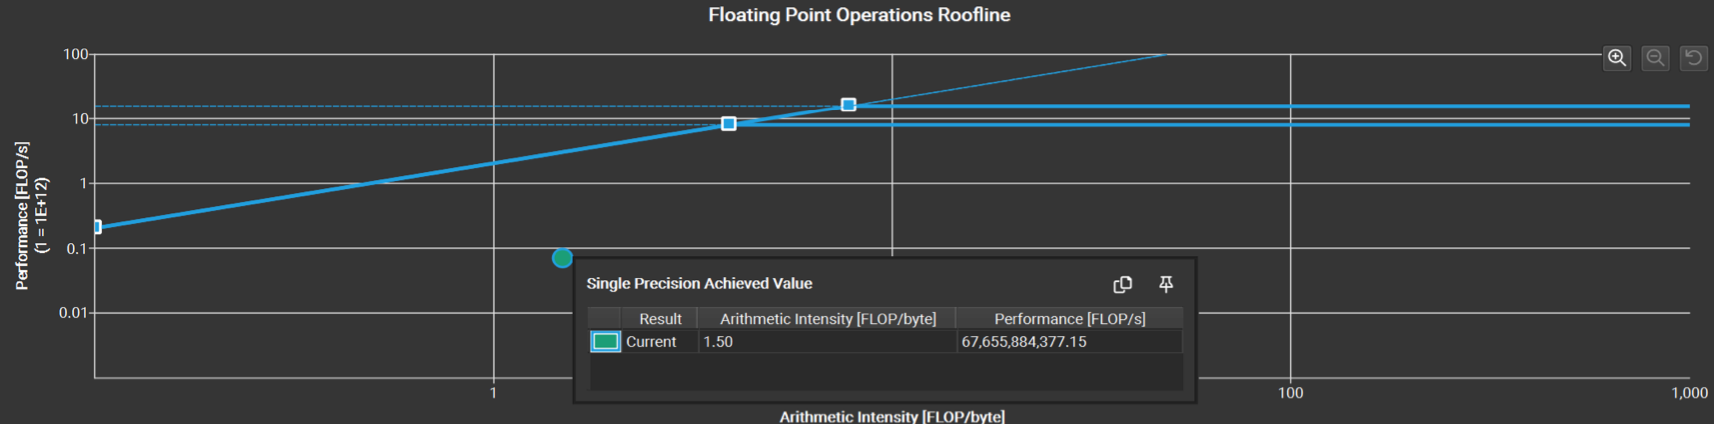
相比于之前的版本,使用 __shfl_down_sync() 后 Roofline 显示AI 明显提高了很多
- 因为__shfl_down_sync() 使得整理计算量增加,AI 增加
Smem Warp Shuffle
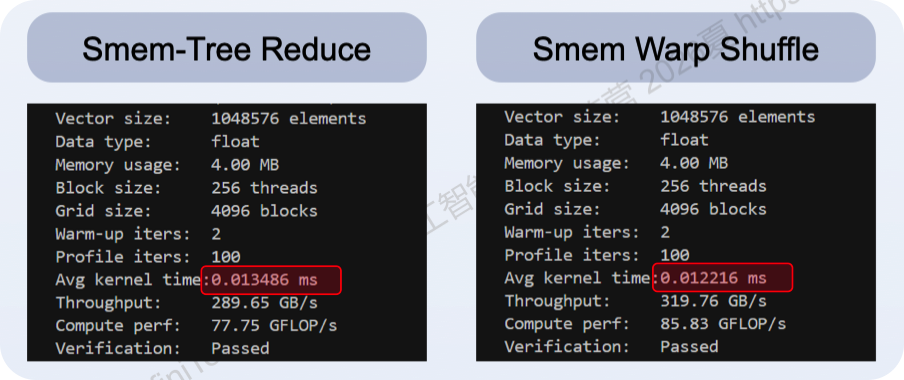
再将原来的 smem 手动树状规约换成warp-shuffle 规约:
template <typename T>
__device__ T warp_reduce(T val) {
    // #pragma unroll: 暗示编译器进行循环展开
    #pragma unroll
    for (int offset = 16; offset > 0; offset >>= 1) {
        val += __shfl_down_sync(0xFFFFFFFF, val, offset);
    }
    return val;
}

template <typename T>
__global__ void reduce_warp_shuffle_kernel(T *output, const T *input, size_t n) {
    size_t tid = threadIdx.x;
    size_t idx = blockIdx.x * blockDim.x + tid;

    T sum = 0;
    for (size_t i = idx; i < n; i += blockDim.x * gridDim.x) {
        // 每个线程自己的寄存器
        sum += input[i];
    }

    T warp_sum = warp_reduce(sum);

    if (tid % 32 == 0) {
        smem[tid / 32] = warp_sum;
    }
    __syncthreads();

    if (tid < 32) {
        T block_sum = (tid < (blockDim.x + 31) / 32) ? smem[tid] : T(0);
        block_sum = warp_reduce(block_sum);
        if (tid == 0) {
            atomicAdd(output, block_sum);
        }
    }
}device:表示这是一个运行在 GPU 上的设备函数,只能被 GPU 的其他函数调用#pragma unroll:指示编译器将for循环完全展开。因为循环次数是固定的(16, 8, 4, 2, 1),编译器会直接写出5句硬编码的汇编指令,消除了循环计数器开销和分支跳转开销,让流水线跑得更快
Two-Pass Reduce
template <typename T>
void reduce_two_pass(T *d_result, const T *d_input, size_t n,
                     const dim3 &grid, const dim3 &block) {
    // Allocate intermediate buffer for block results
    T *d_intermediate;
    CUDA_CHECK(cudaMalloc(&d_intermediate, grid.x * sizeof(T)));

    // First pass: reduce within blocks
    size_t smem_size1 = ((block.x + 31) / 32) * sizeof(T);
    reduce_warp_shuffle_first_pass_kernel<<<grid, block, smem_size1>>>(d_intermediate, d_input, n);
    CUDA_CHECK(cudaGetLastError());

    // Second pass: reduce block results
    dim3 grid2(1);
    dim3 block2(min(grid.x, block.x));
    size_t smem_size2 = ((block2.x + 31) / 32) * sizeof(T);
    reduce_warp_shuffle_second_pass_kernel<<<grid2, block2, smem_size2>>>(d_result, d_intermediate, grid.x);
    CUDA_CHECK(cudaGetLastError());
    // 任务完成后,将动态分配的中间缓冲区释放,防止显存泄漏
    CUDA_CHECK(cudaFree(d_intermediate));
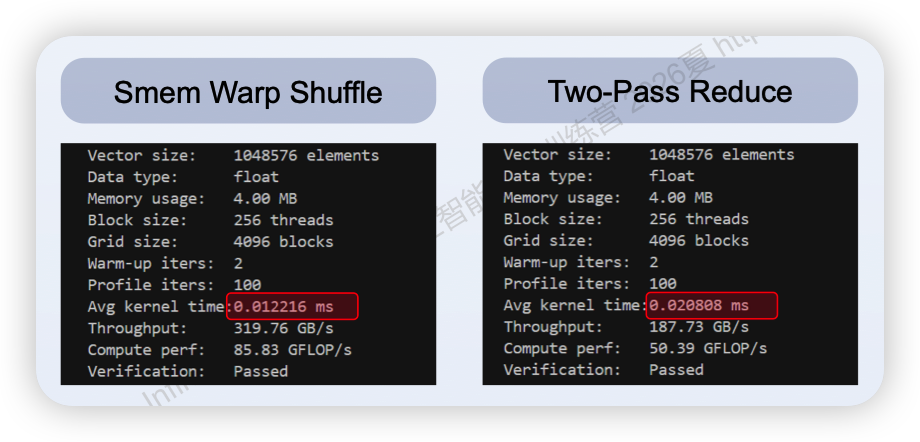
}- 第一个 kernel 的结果需要存到全局内存→ 需要分配一个临时数组(4096个block的累加结果赋值到大小为4096的临时数组,显存中)
- 第二个 kernel 的 gridSize 是 :因为第一遍已经完成了大部分并行工作,现在只剩一个很短的数组(比如只有 4096 个数)需要求和
- 其实就是利用了显存(Global Memory)作为桥梁,通过暂存规约的结果,完成跨 Block 通信

Grid Sync Reduce
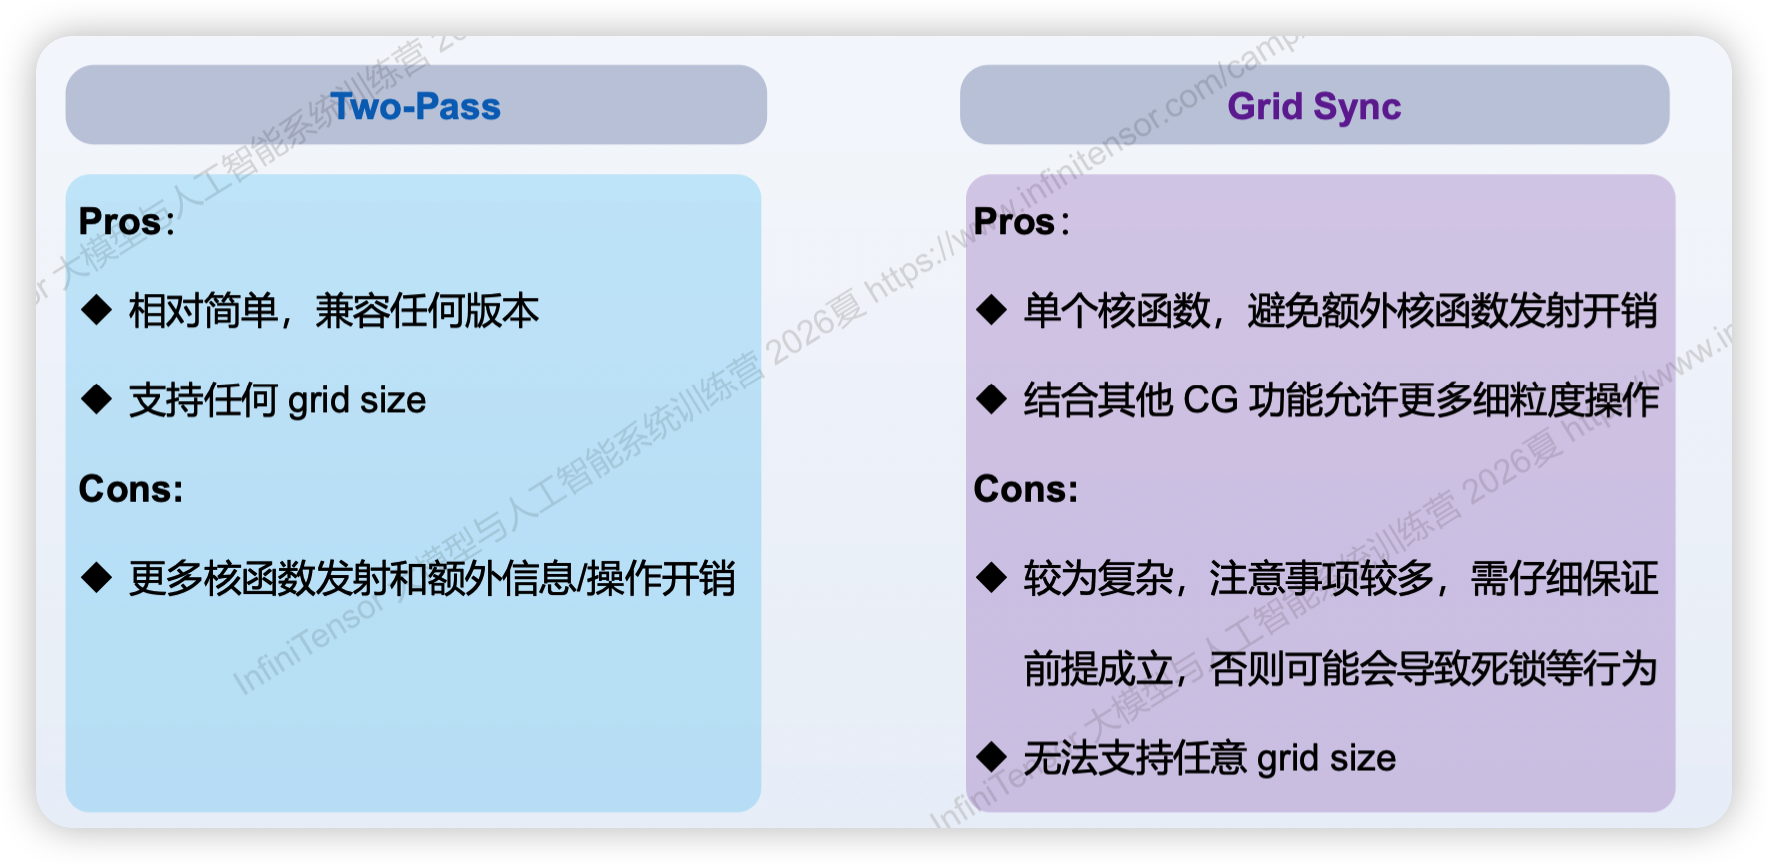
像同步块内/warp内线程一样同步块间线程,但前提是:
- CUDA 9.0+
- 用 Cooperative Group
代码逻辑保持和之前的 two-pass 一样
// 前提:需要包含 cooperative_groups 头文件
#include <cooperative_groups.h>
namespace cg = cooperative_groups;

// 之前定义的 Warp Shuffle 归约辅助函数
template <typename T>
__device__ T warp_reduce(T val) {
    #pragma unroll
    for (int offset = 16; offset > 0; offset >>= 1) {
        val += __shfl_down_sync(0xFFFFFFFF, val, offset);
    }
    return val;
}

template <typename T>
__global__ void reduce_cooperative_kernel(T *output, const T *input, size_t n) {
    extern __shared__ __align__(sizeof(T)) unsigned char shared_mem_raw[];
    T *coop_smem = reinterpret_cast<T*>(shared_mem_raw);

    auto grid = cg::this_grid();
    auto block = cg::this_thread_block();
    size_t tid = threadIdx.x;
    size_t idx = blockIdx.x * blockDim.x + tid;

    // Block-level reduction
    T sum = 0;
    for (size_t i = idx; i < n; i += gridDim.x * blockDim.x) {
        sum += input[i];
    }

    T warp_sum = warp_reduce(sum);

    if (tid % 32 == 0) {
        coop_smem[tid / 32] = warp_sum;
    }
    block.sync();

    if (tid < 32) {
        T block_sum = (tid < (blockDim.x + 31) / 32) ? coop_smem[tid] : T(0);
        block_sum = warp_reduce(block_sum);
        if (tid == 0) {
            output[blockIdx.x] = block_sum;
        }
    }

    // Global synchronization
    grid.sync();

    // Final reduction
    if (blockIdx.x == 0) {
        T final_sum = 0;
        for (size_t i = tid; i < gridDim.x; i += blockDim.x) {
            final_sum += output[i];
        }

        T warp_val = warp_reduce(final_sum);

        if (tid % 32 == 0) {
            coop_smem[tid / 32] = warp_val;
        }
        block.sync();

        if (tid < 32) {
            T v = (tid < (blockDim.x + 31) / 32) ? coop_smem[tid] : T(0);
            T total = warp_reduce(v);
            if (tid == 0) {
                output[0] = total;
            }
        }
    }
}- block.sync(): __syncthreads()
- grid.sync(): 跨 block 同步——等待所有 Block 都把结果写入
output[blockIdx.x]后,再指定blockIdx.x == 0的这一个 Block 去读取其余 Block 的结果。 - Grid Sync Reduce的方案在数据量更大的时候优势会更大
Bank Conflict
交错寻址 vs 邻近合并寻址
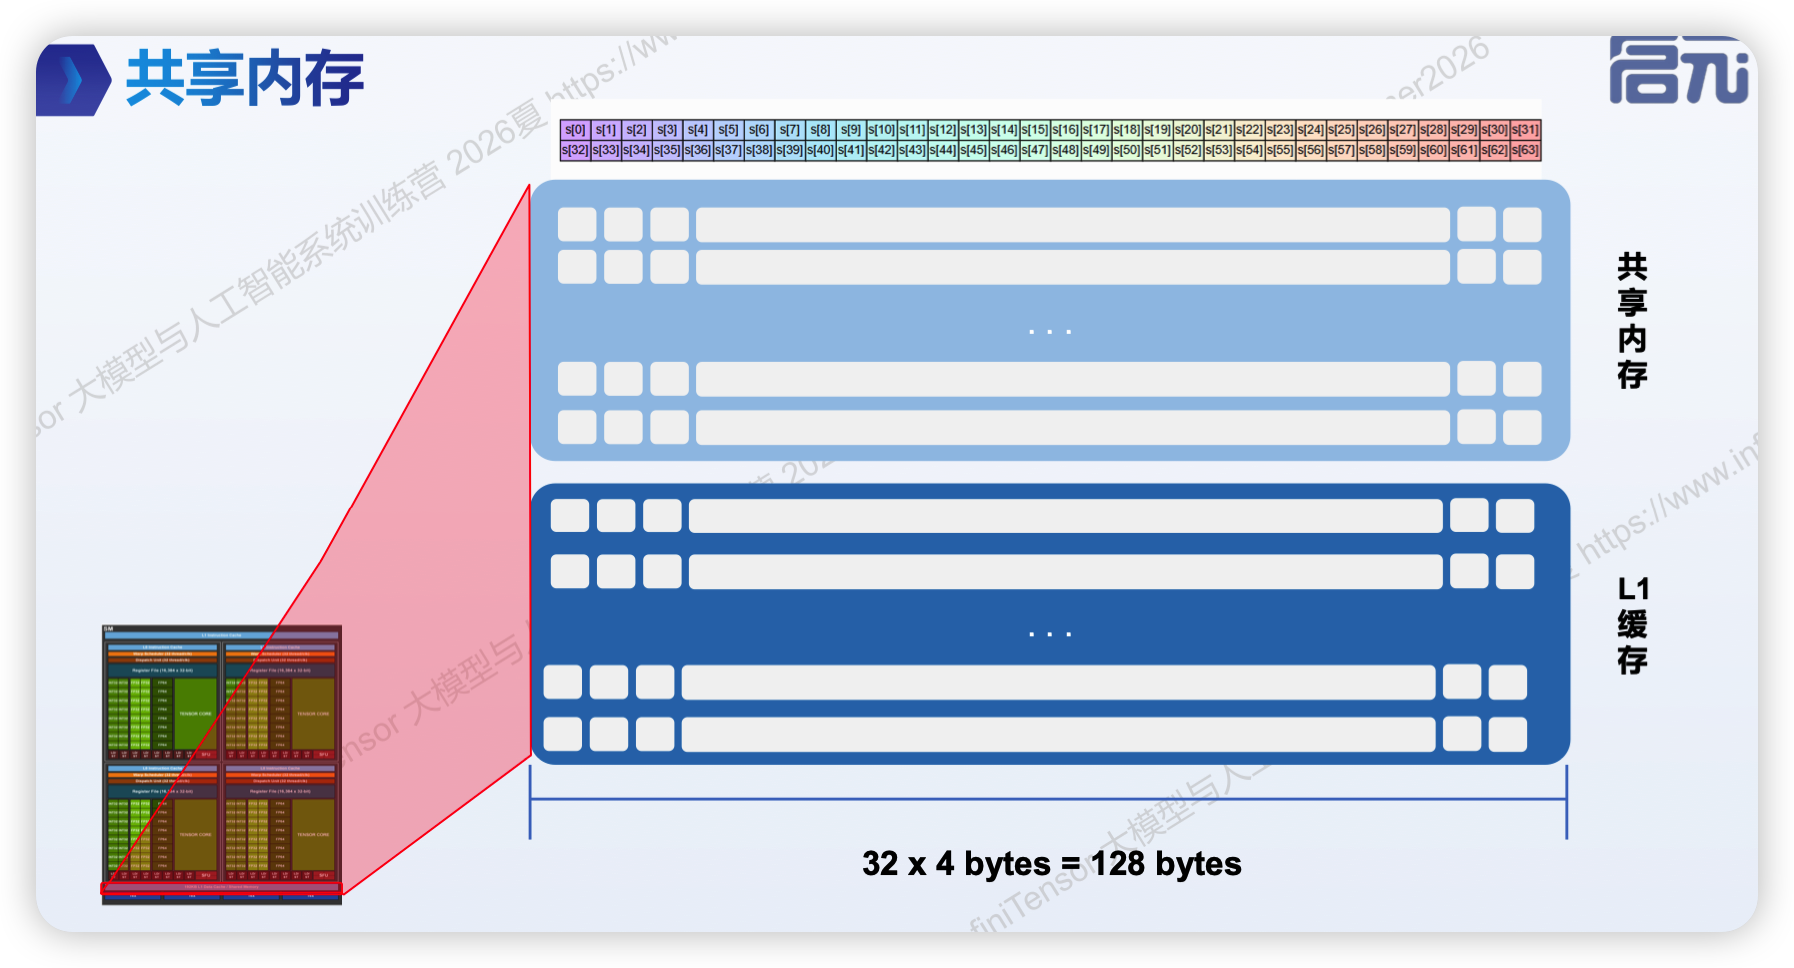
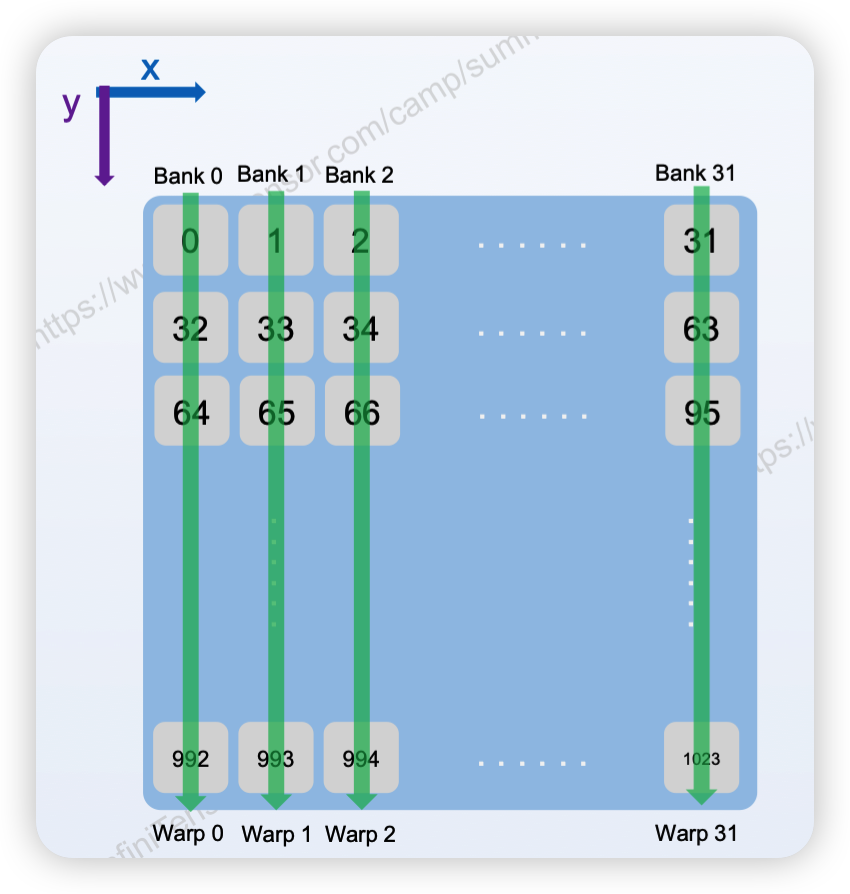
共享内存被划分为 32 个 Bank,每个 bank 是 4 bytes,硬件每一次只能从这同一个 Bank 里取出 4 个字节(32位,正好一个 int 或 float 的大小)
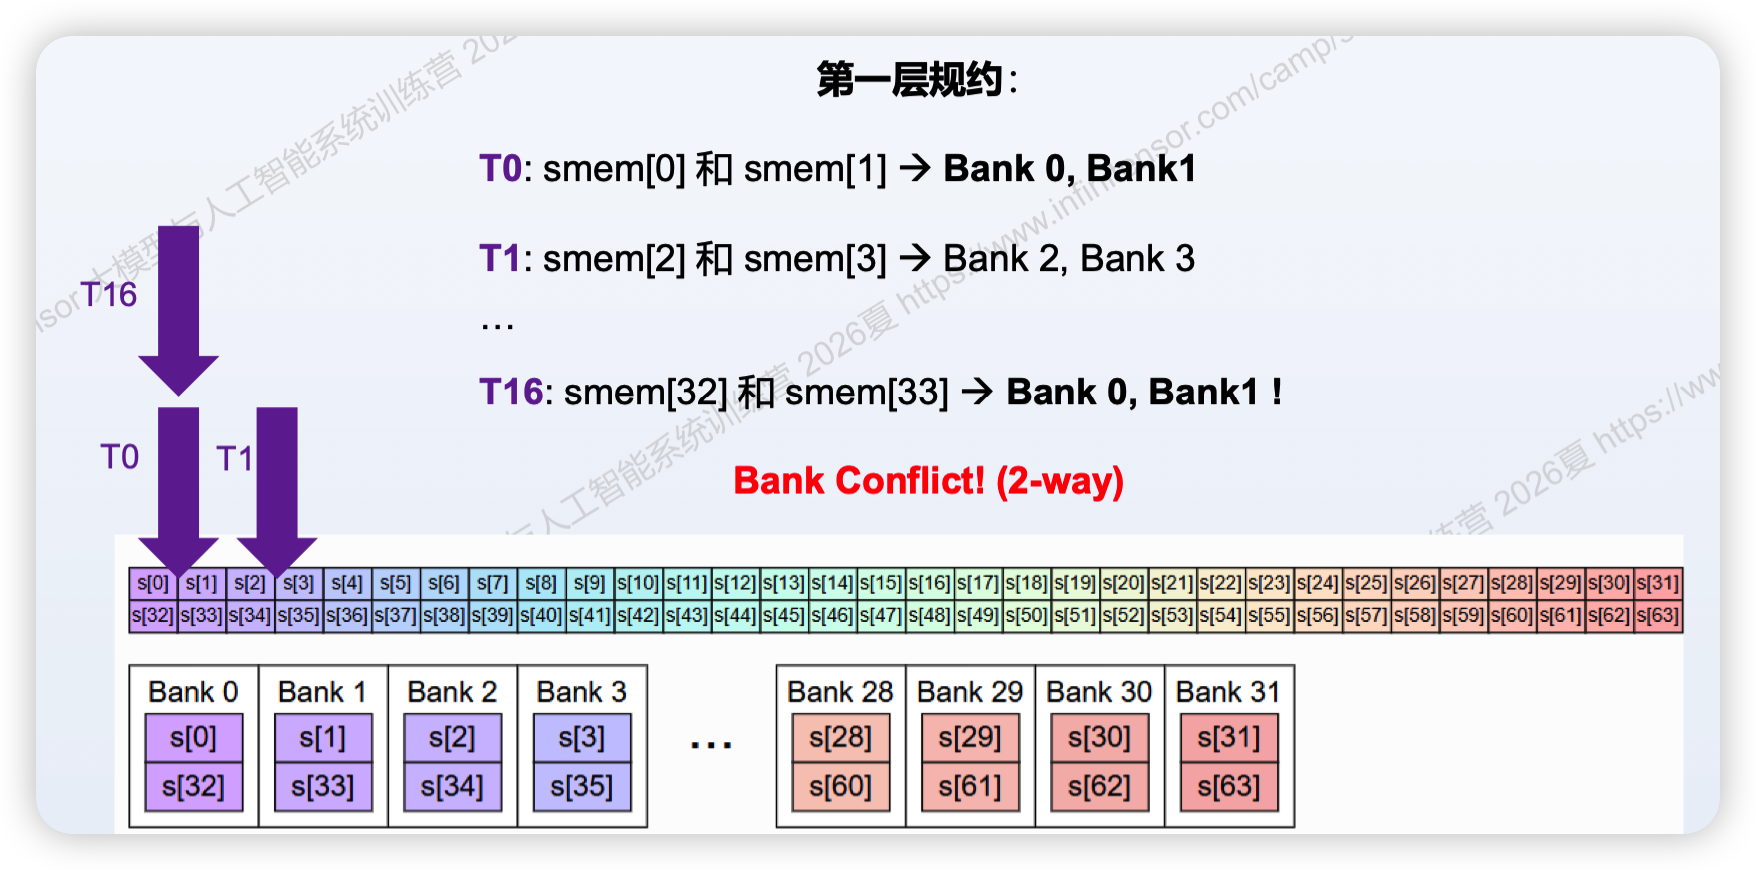
但当一个 warp 中的多个线程同时(Instr./TX)访问同一个 bank 的不同地址时,这时候访问将会被串行化,这个现象就叫 Bank Conflict。重点:访问规律/模式
一个 Warp 有 32 个线程同时访问内存:
- 如果线程 0 访问
s[0],线程 1 访问s[1],… 线程 31 访问s[31]。由于它们落在 32 个不同的 Bank 上,硬件可以一次性并行完成(无冲突,速度极快) - 但是,如果线程 0 访问
s[0],而线程 1 访问s[32](它们都在 Bank 0 里),因为 Bank 0 同一时间只能服务一个地址,硬件必须强制排队,把访问分裂成两次(发生两路银行冲突),速度直接减半 - 因此,Bank conflict 常发生于不连续访问共享内存的情况
- 最常见的不连续访问情景就是跨步访问(比如刚才的树状规约)
如果多个线程同时访问同一个 bank 的同一个地址时,这时不会发生 bank conflict,而是会直接发生广播 (Broadcast) 或多播 (Multicast)
算法/访存模式优化
使用之前的对半向前的树状规约模式

内存填充(Padding)
transpose(转置)核函数
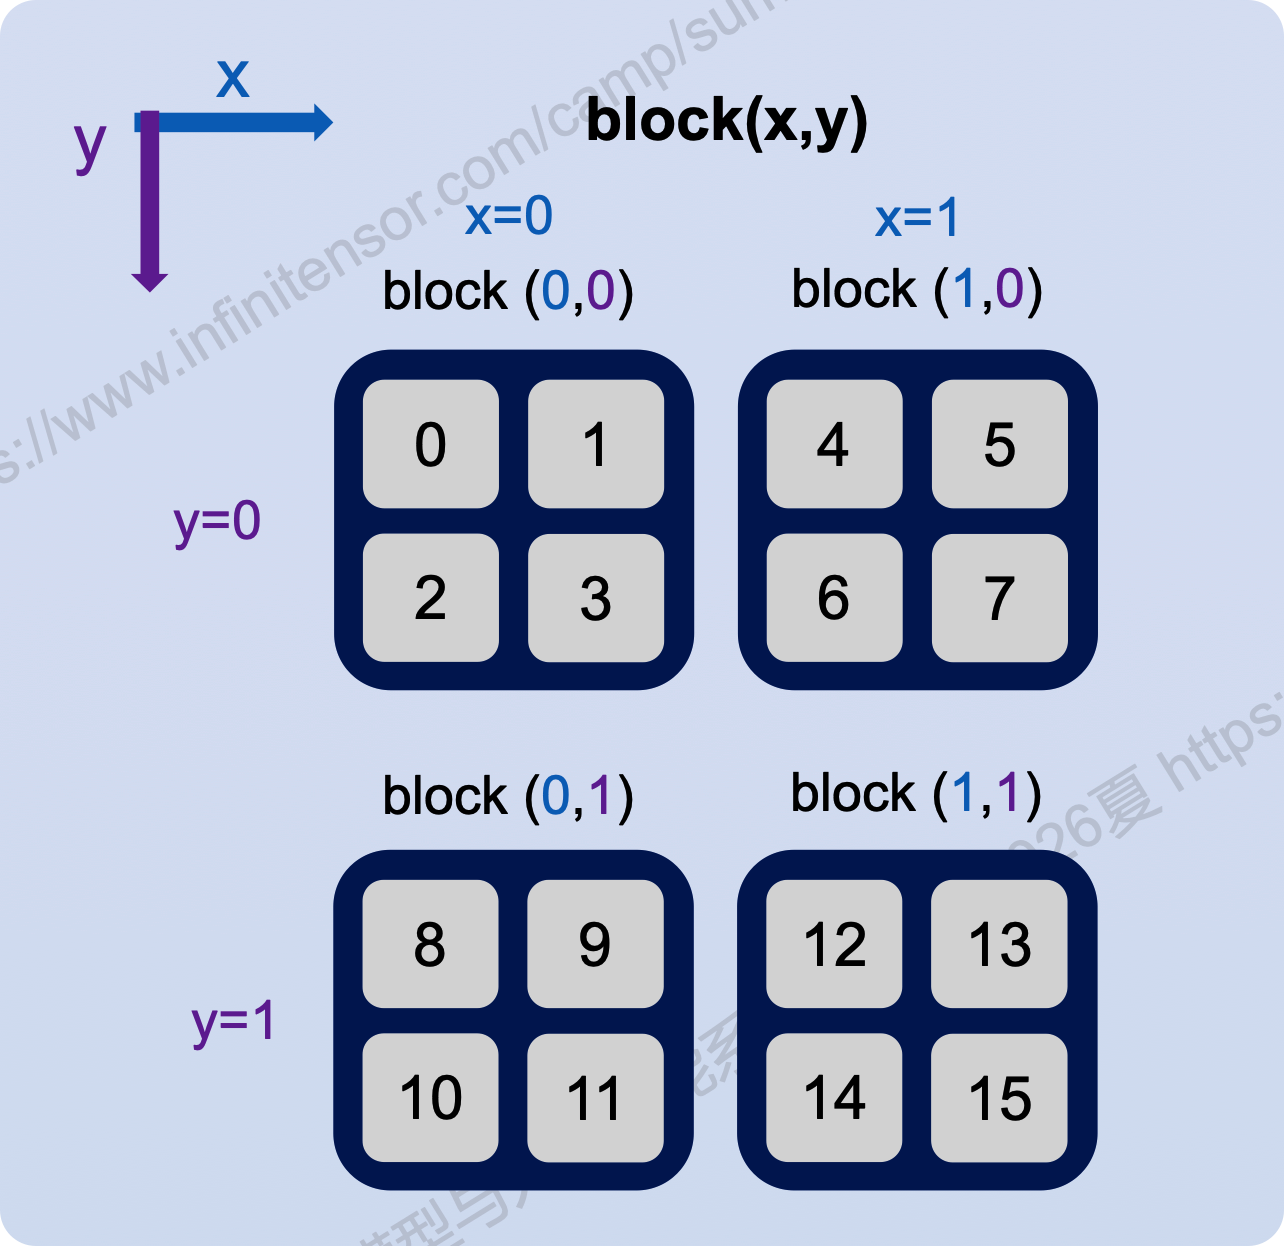
__global__ void transpose_kernel(float *output, const float *input, int matrix_dim) {
    __shared__ float tile[BLOCK_DIM][BLOCK_DIM];
    // 1.读取原始数据
    int col = blockIdx.x * BLOCK_DIM + threadIdx.x;
    int row = blockIdx.y * BLOCK_DIM + threadIdx.y;
    // 2.写入共享内存tile(临时存放)
    if (row < matrix_dim && col < matrix_dim) {
        tile[threadIdx.y][threadIdx.x] = input[row * matrix_dim + col];
    }
    // 同一个 Block 里的线程需要确保其他所有线程都已经把数据放进共享内存
    __syncthreads();
    // 3.计算转置后的坐标位置
    int transposed_col = blockIdx.y * BLOCK_DIM + threadIdx.x;
    int transposed_row = blockIdx.x * BLOCK_DIM + threadIdx.y;

    if (transposed_row < matrix_dim && transposed_col < matrix_dim) {
        // 4.写入最终输出(到全局内存 output)
        output[transposed_row * matrix_dim + transposed_col] = tile[threadIdx.x][threadIdx.y];
    }
}
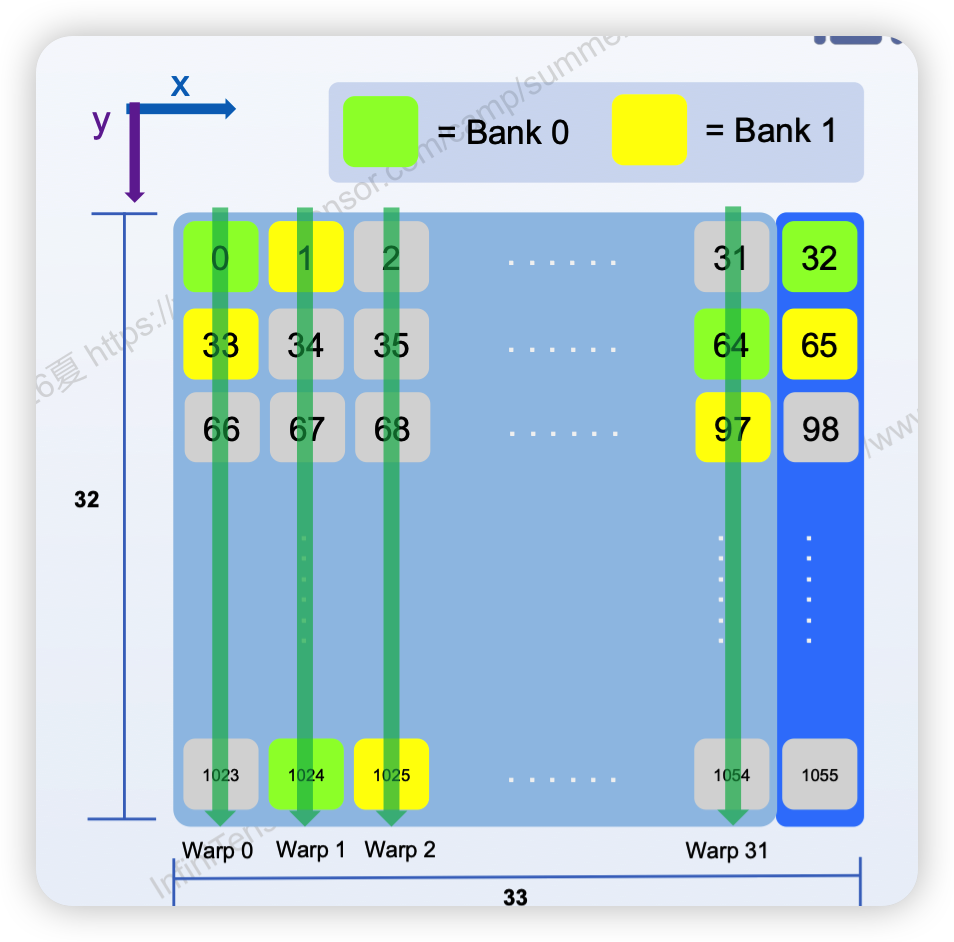
- Padding 会额外消耗 smem 的空间,根据情景可能会浪费许多宝贵的 smem 空间
COMMENTS
评论