并行编程导论与CUDA入门
并行
- 串行(Sequential/Serial):顺序执行,一次一条指令,任务A做完才能做任务B,中途没有任何重叠
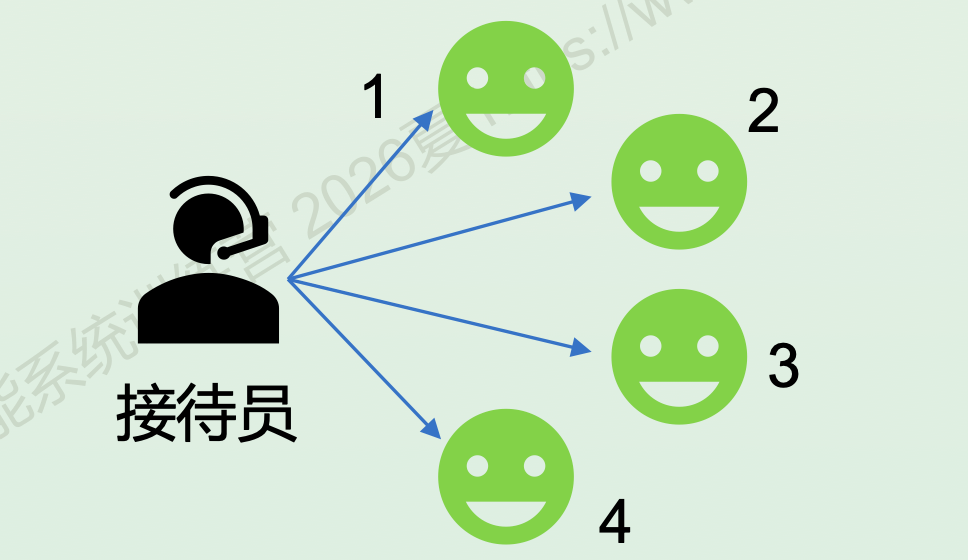
- 并发(Concurrent):逻辑上同时,物理上轮流,单核CPU通过极快的时间片切换,让任务A和B交替推进(我觉得在AI时代,我们的脑子在管理多个Agent任务的过程中就像并发XD)
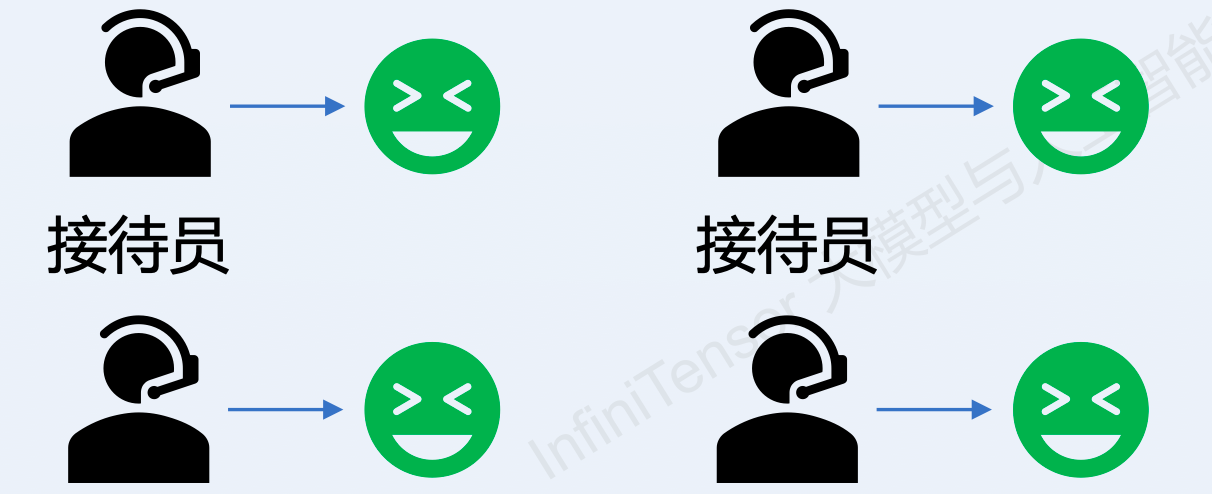
- 并行(Parallel):物理上同时一起执行,必须依赖多核CPU或GPU,核心1跑任务A,核心2跑任务B
CUDA (Compute Unified Device Architecture)
NVIDIA 开发的并行计算平台和编程模型
- C/C++语法:宿主语言为C/C++,使用范围广,应用领域对口,新语法学习门槛低
- 与 CPU 端协作:CPU 需负责整理程序执行和处理逻辑等
- SIMT 模式:Single Instruction Multiple Threads 一个指令可以被多个线程同时执行
- 自动调度:根据设定的执行参数自动调度资源(优化)
GPU硬件单元
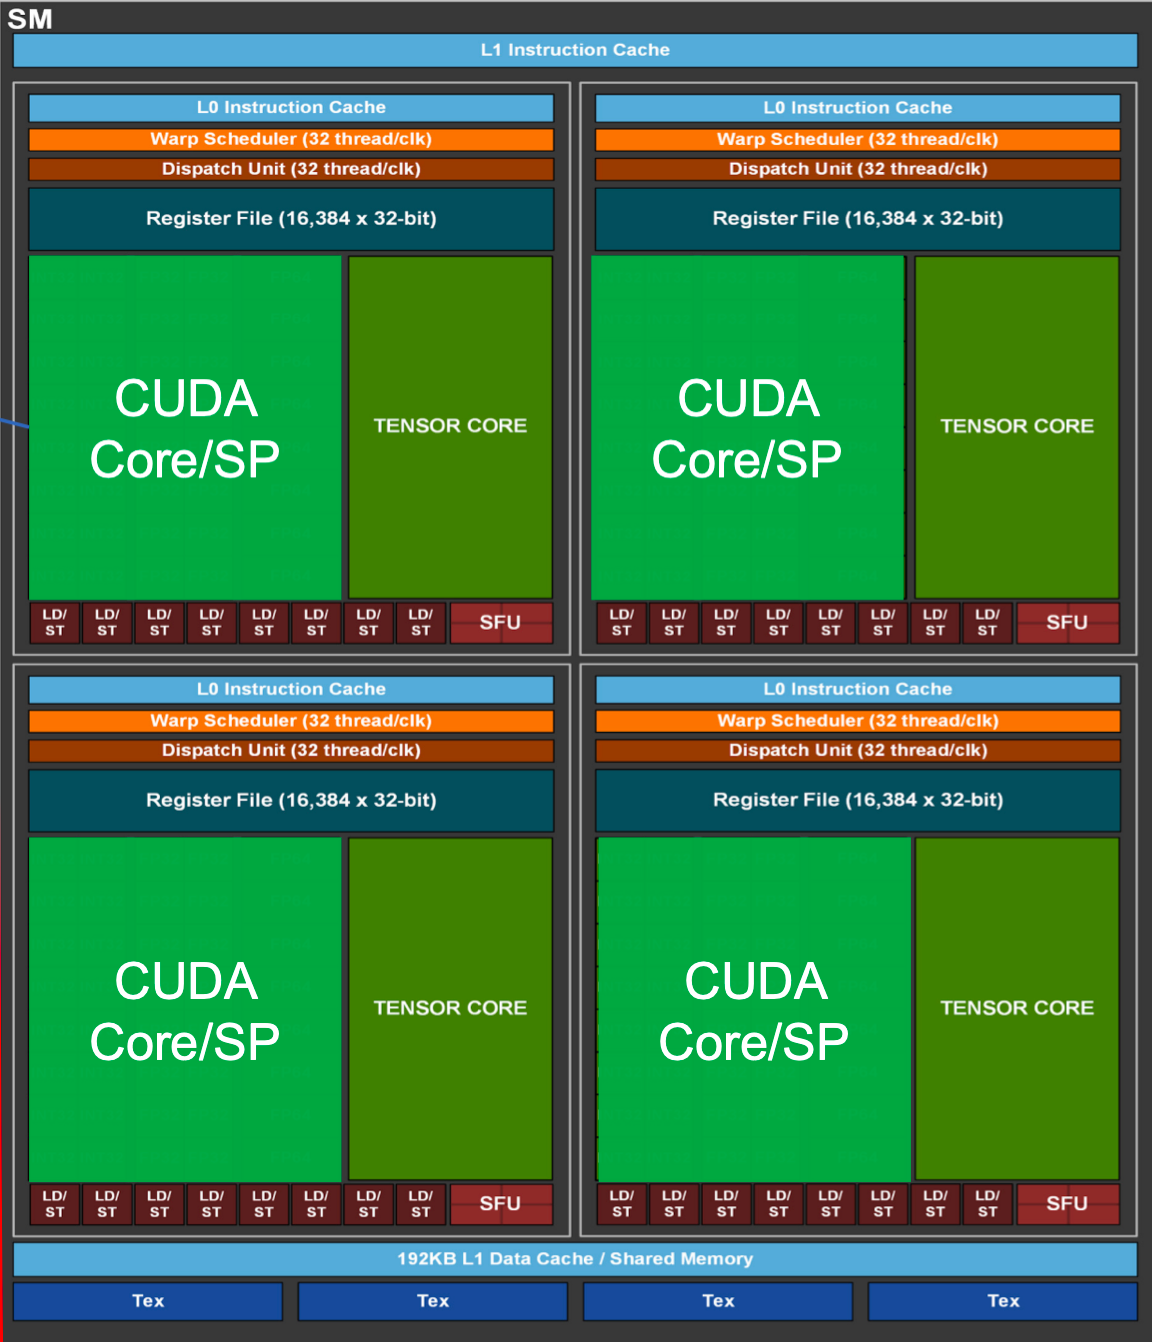
- SM(streaming multiprocessor) 流多处理器,是并行计算的核心
- CUDA Core/ Streaming Processor:每个SM有多个SP,计算被调度和分配到这里进行
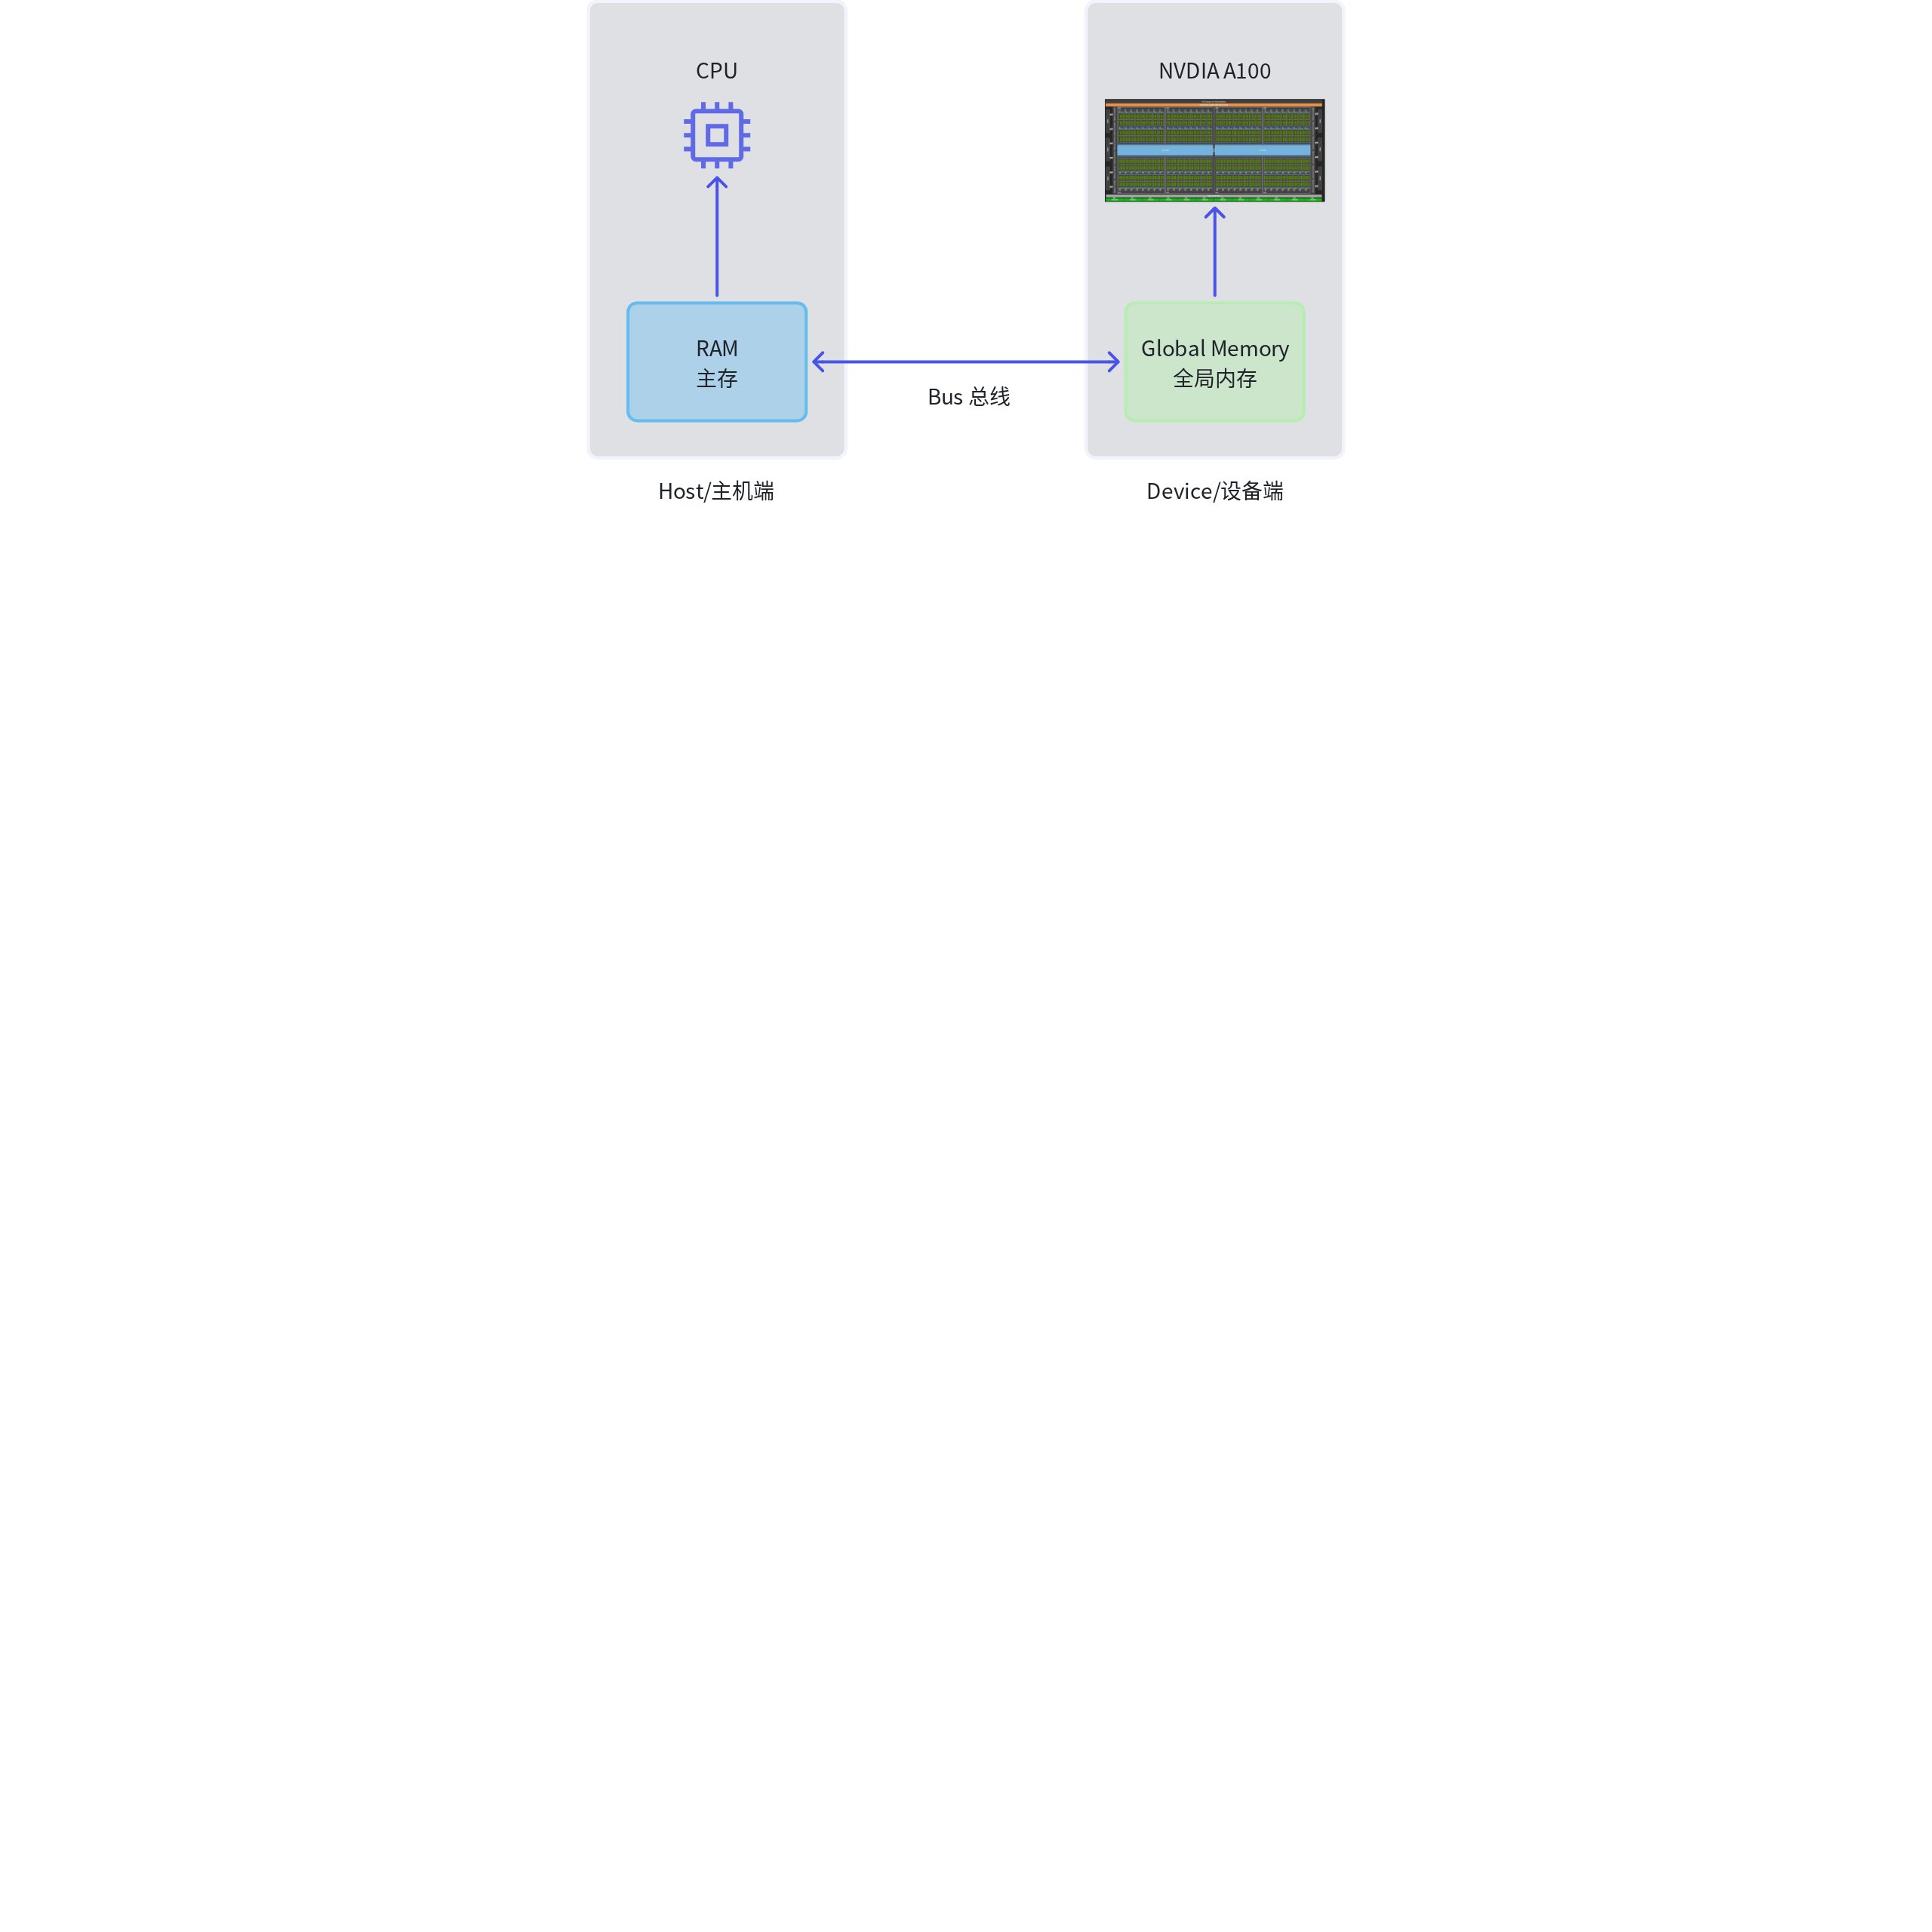
CPU与GPU
- CPU准备任务
- CPU传输数据至GPU
- GPU从GM中读取数据
- GPU进行运算
- 运算后的结果写回GM
- 再由GPU传输数据到CPU
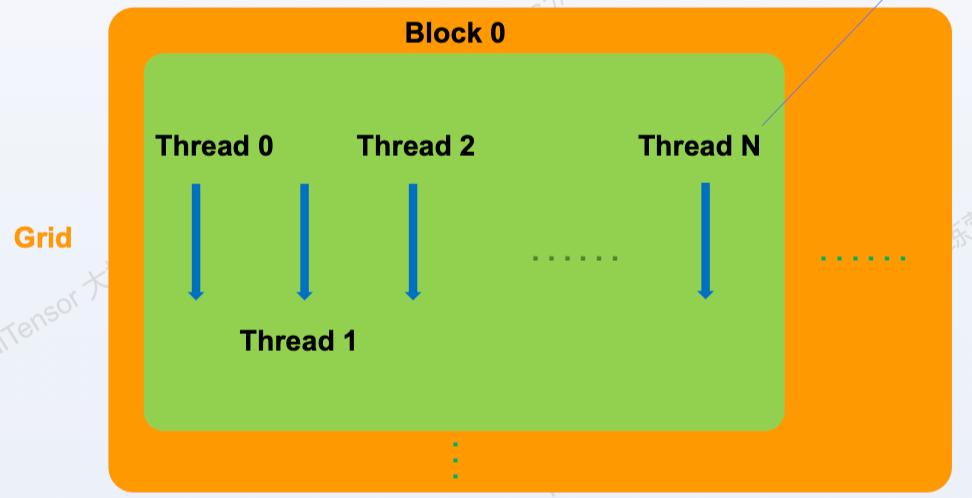
SIMT
SIMT(Single Instruction, Multiple Threads,单指令多线程)是现代GPU,特别是NVIDIA CUDA架构的核心执行模型:在一个线程束(Warp,通常为32个线程)中,所有线程在同一时刻执行同一条指令,但每个线程处理自己独立的数据。每个线程拥有独立的寄存器、程序计数器(PC)等状态,因此可以独立地进行计算、读取不同的内存地址,甚至在遇到分支时(如if-else)走向不同的执行路径。GPU硬件以线程束Warp为基本单位进行调度和执行。一个Warp里的32个线程是锁步(lock-step)执行的,即它们以高度同步的方式一起前进
- SIMT → 指挥每个线程 → 需要组织结构和编号
- Grid → Block → Thread
- 每个线程独一无二的编号/索引(idx):idx = Block ID * Block Size + Thread ID
GPU加法
- 文件名:add_cuda.cu
- dim3: CUDA 表示线程层级结构的类型
- <<<>>>: 传递线程层级信息给核函数
int main() {
    const size_t SIZE = 1 << 20; // ~1M elements
    size_t size_bytes = SIZE * sizeof(float);

    // Initialize host data 初始化数据
    std::vector<float> h_a(SIZE, 1.0f);
    std::vector<float> h_b(SIZE, 2.0f);
    std::vector<float> h_c(SIZE, 0.0f);

    // Allocate device memory 分配/开辟数据空间
    float *d_a, *d_b, *d_c;
    CUDA_CHECK(cudaMalloc(&d_a, size_bytes));
    CUDA_CHECK(cudaMalloc(&d_b, size_bytes));
    CUDA_CHECK(cudaMalloc(&d_c, size_bytes));

    // Copy data from host to device 数据传输到GPU
    CUDA_CHECK(cudaMemcpy(d_a, h_a.data(), size_bytes, cudaMemcpyHostToDevice));
    CUDA_CHECK(cudaMemcpy(d_b, h_b.data(), size_bytes, cudaMemcpyHostToDevice));
    CUDA_CHECK(cudaMemcpy(d_c, h_c.data(), size_bytes, cudaMemcpyHostToDevice)); // 修正拼写

    // Set up kernel configuration
    // 定义 block 的数量和大小来指挥线程同时进行/并行计算
    dim3 block_dim(256);
    dim3 grid_dim((SIZE + block_dim.x - 1) / block_dim.x);

    // Launch the CUDA add kernel 传递线程层级信息给核函数
    add_kernel<<<grid_dim, block_dim>>>(d_c, d_a, d_b, SIZE);

    // Copy the result back to host 将 GPU 数据传输回 CPU
    CUDA_CHECK(cudaMemcpy(h_c.data(), d_c, size_bytes, cudaMemcpyDeviceToHost));

    // 可选:验证结果(简单校验前10个)
    for (int i = 0; i < 10; ++i) {
        std::cout << h_c[i] << " ";
    }
    std::cout << std::endl;

    // Free device memory 运行程序验证结果,释放内存
    if (d_a) CUDA_CHECK(cudaFree(d_a));
    if (d_b) CUDA_CHECK(cudaFree(d_b));
    if (d_c) CUDA_CHECK(cudaFree(d_c));

    return 0;
}- 核函数(kernel):设备侧的入口函数
- global: 表示这是个核函数
- blockIdx: 表示刚刚提到的 block 的编号
- blockDim: 表示刚刚提到的 block 的大小
- threadIdx: 表示刚刚提到的 thread 的编号
// CUDA 核函数:逐元素加法
template<typename T>
__global__ void add_kernel(T *c, const T *a, const T *b, int n) {
    int idx = blockIdx.x * blockDim.x + threadIdx.x;
    if (idx < n) {
        c[idx] = a[idx] + b[idx];
    }
}
NVCC编译器
// 编译
nvcc add_cuda.cu -o add_cuda
// 运行
./add_cuda
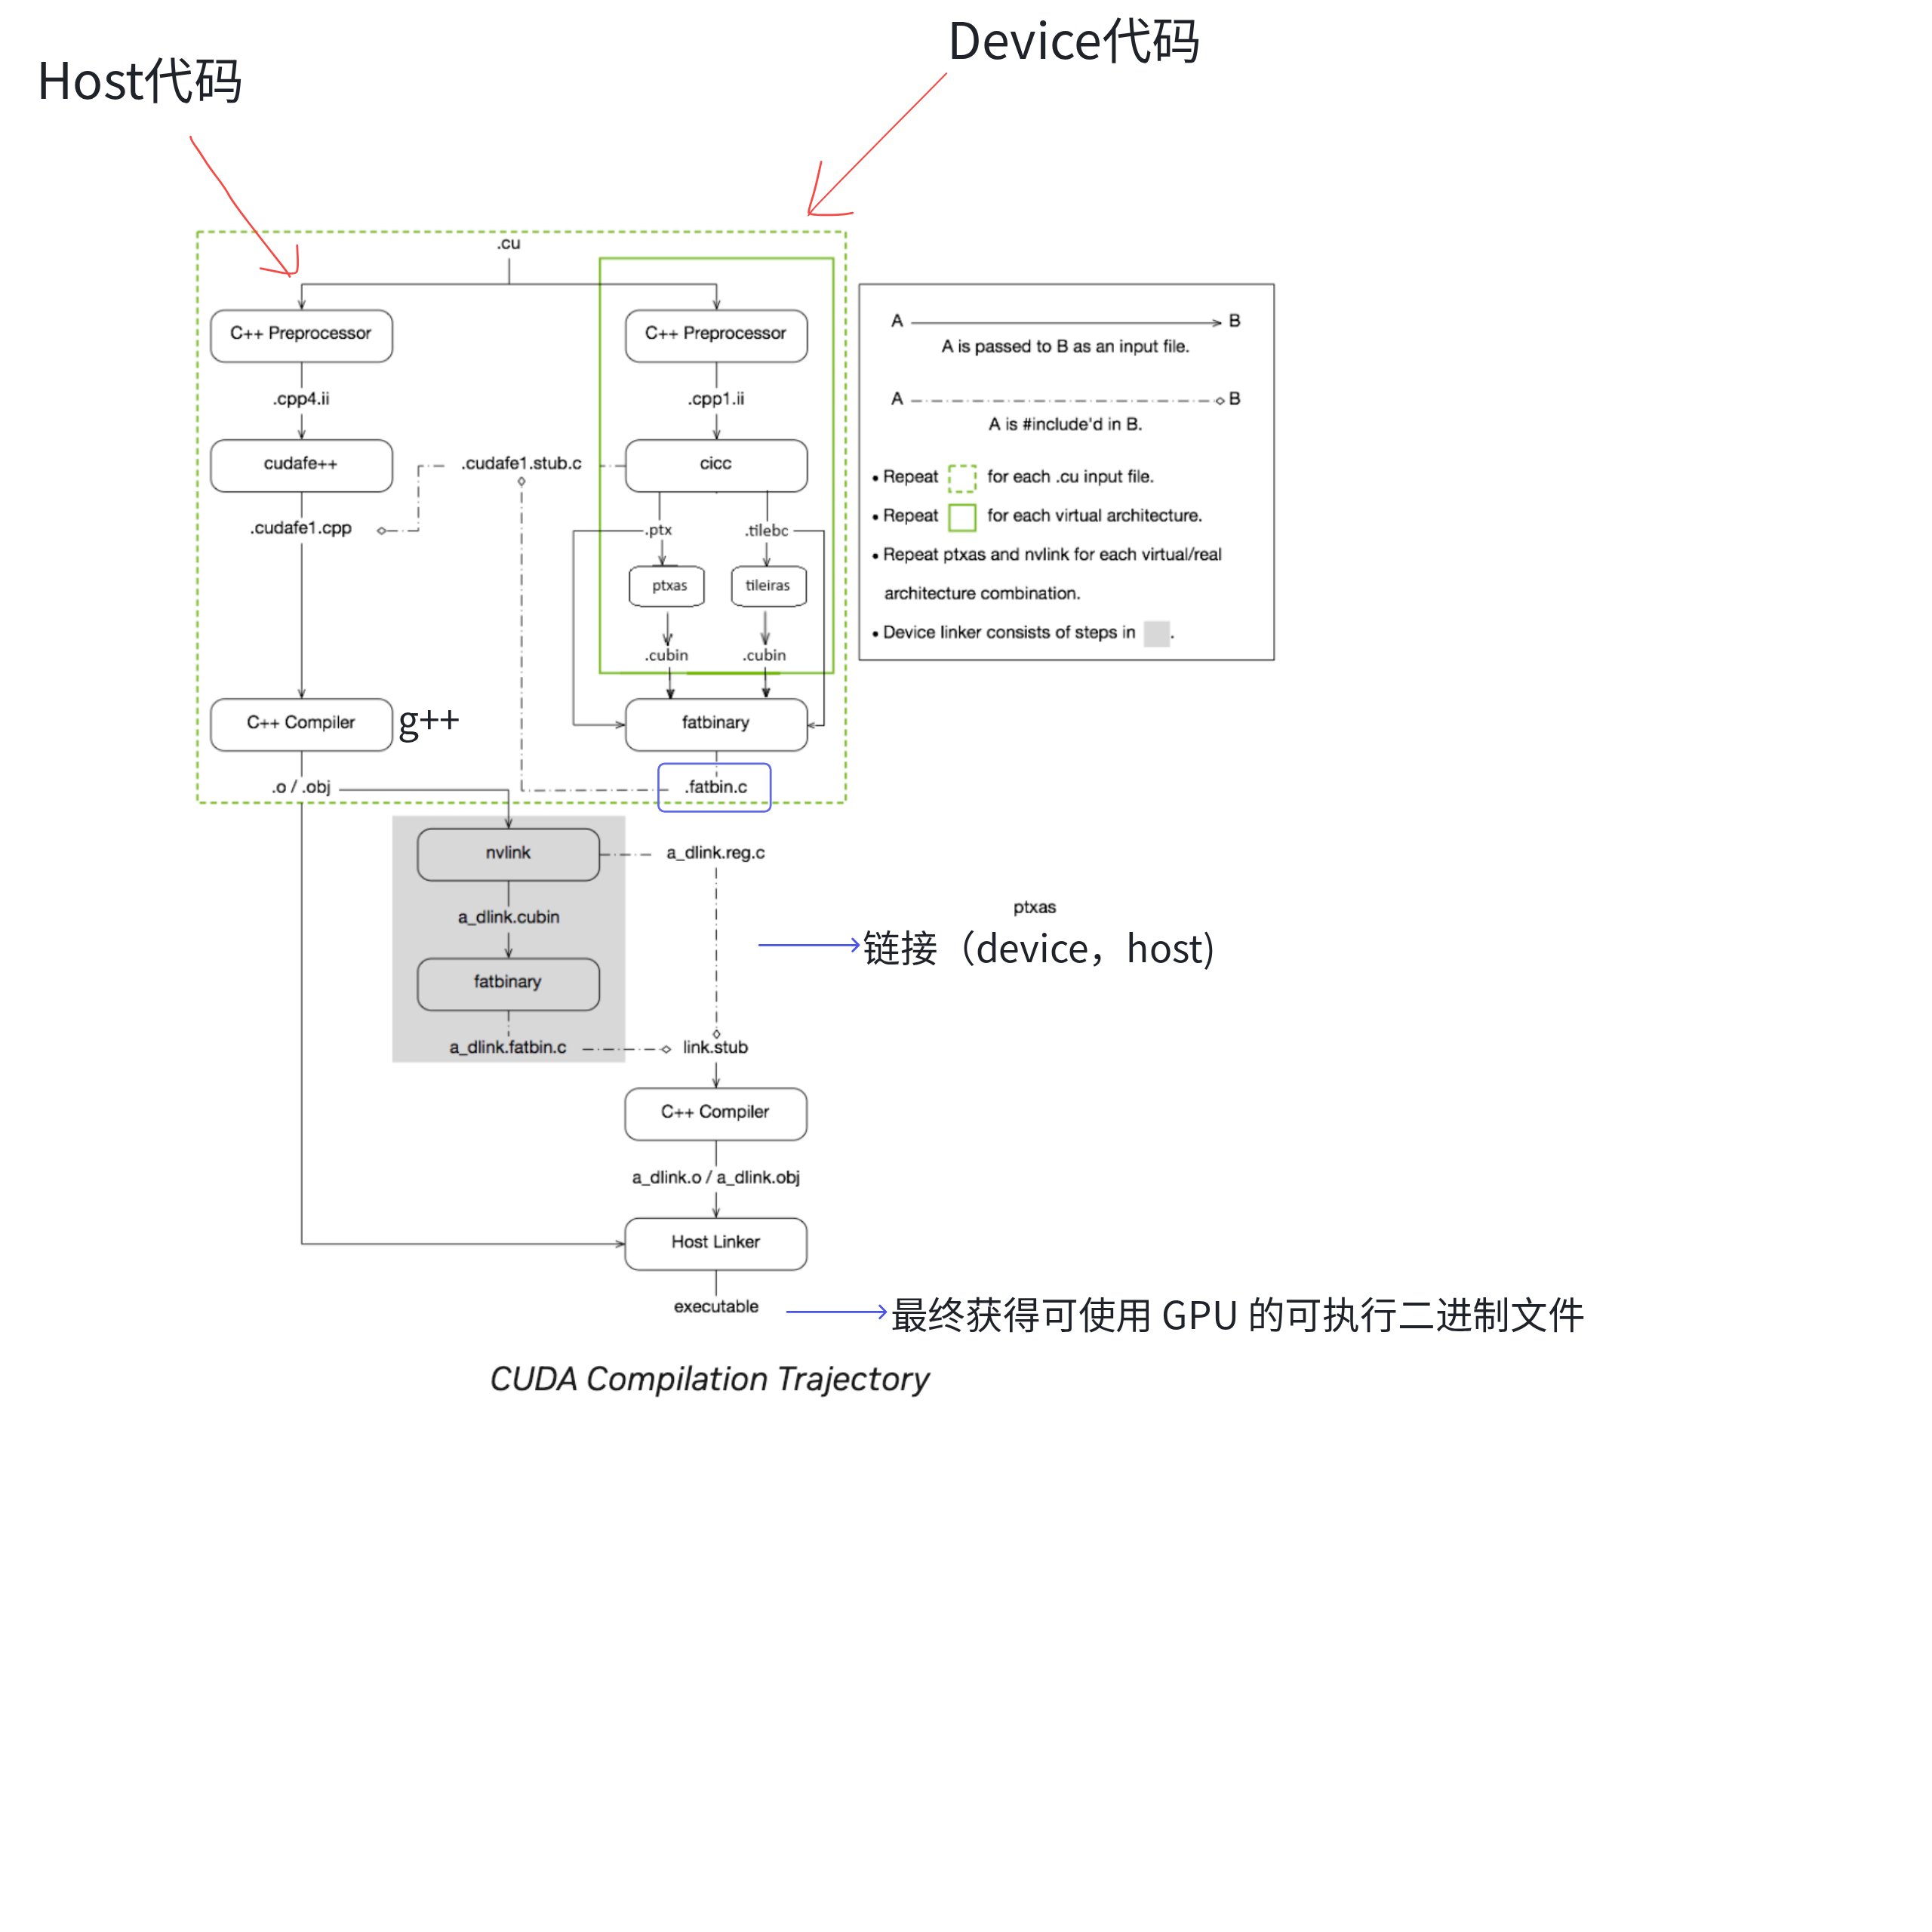
可以编译GPU端和CPU端的代码
- 每个 cu: Host 代码与 Device 代码分离
- 每个虚拟架构:Device 代码编译出 fatbin
- Host 端使用系统的 C++ 编译器(如 g++)
- 链接(device,host)
- 最终获得可使用 GPU 的可执行二进制文件
GPU架构
不同的 GPU 硬件架构(如 Ampere、Hopper 等)底层设计是有区别的,以 A100 为例,它属于 Ampere 架构。
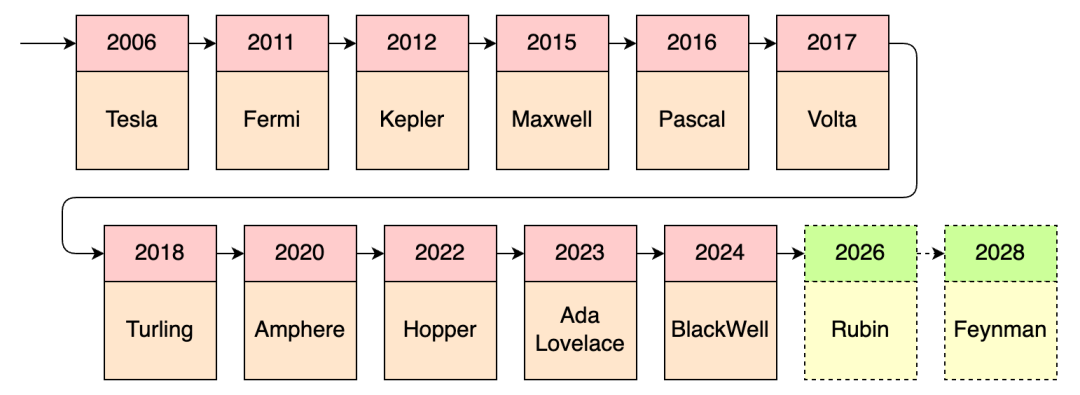
- Compute Capability(CC):你可以把它理解为一个版本号。它代表了该 GPU 硬件能支持的功能集合和指令集。版本越高,能支持的新特性就越多。
关于硬件架构的更多内容可以查看《GPU经典架构演进与解析》
Nsight Systems性能分析工具
分析 CPU 和 GPU 之间的交互(比如数据传输、内核启动时间),定位程序整体的性能瓶颈。
-
nsys profile -t cuda,nvtx,osrt -o add_cuda -f true ./add_cuda-
nsys profile:启动性能分析模式。 -
-t cuda,nvtx,osrt:指定需要收集的跟踪(Trace)数据类型。cuda:CUDA API 的调用(如内核启动、内存拷贝)。nvtx:NVIDIA Tools Extension,这是程序员在代码里手动插入的标记(用于界定代码段),方便在分析时看出哪一段代码耗时最长。osrt:操作系统运行时库(如内存分配、线程同步等系统调用)。
-
-o add_cuda:指定输出文件名的前缀。运行结束后,程序会自动生成一个名为add_cuda.nsys-rep的报告文件。 -
-f true:强制覆盖(Force overwrite)。如果当前目录下已经有同名报告文件,直接覆盖掉,避免报错。 -
./add_cuda:是你需要被分析的目标可执行程序。
-
-
nsys stats add_cuda.nsys-repnsys stats会把报告转换为文本统计信息,直接在终端打印出来,比如:CUDA 内核的总执行时间、内存拷贝的耗时、各类 API 的调用次数和平均耗时等。
-
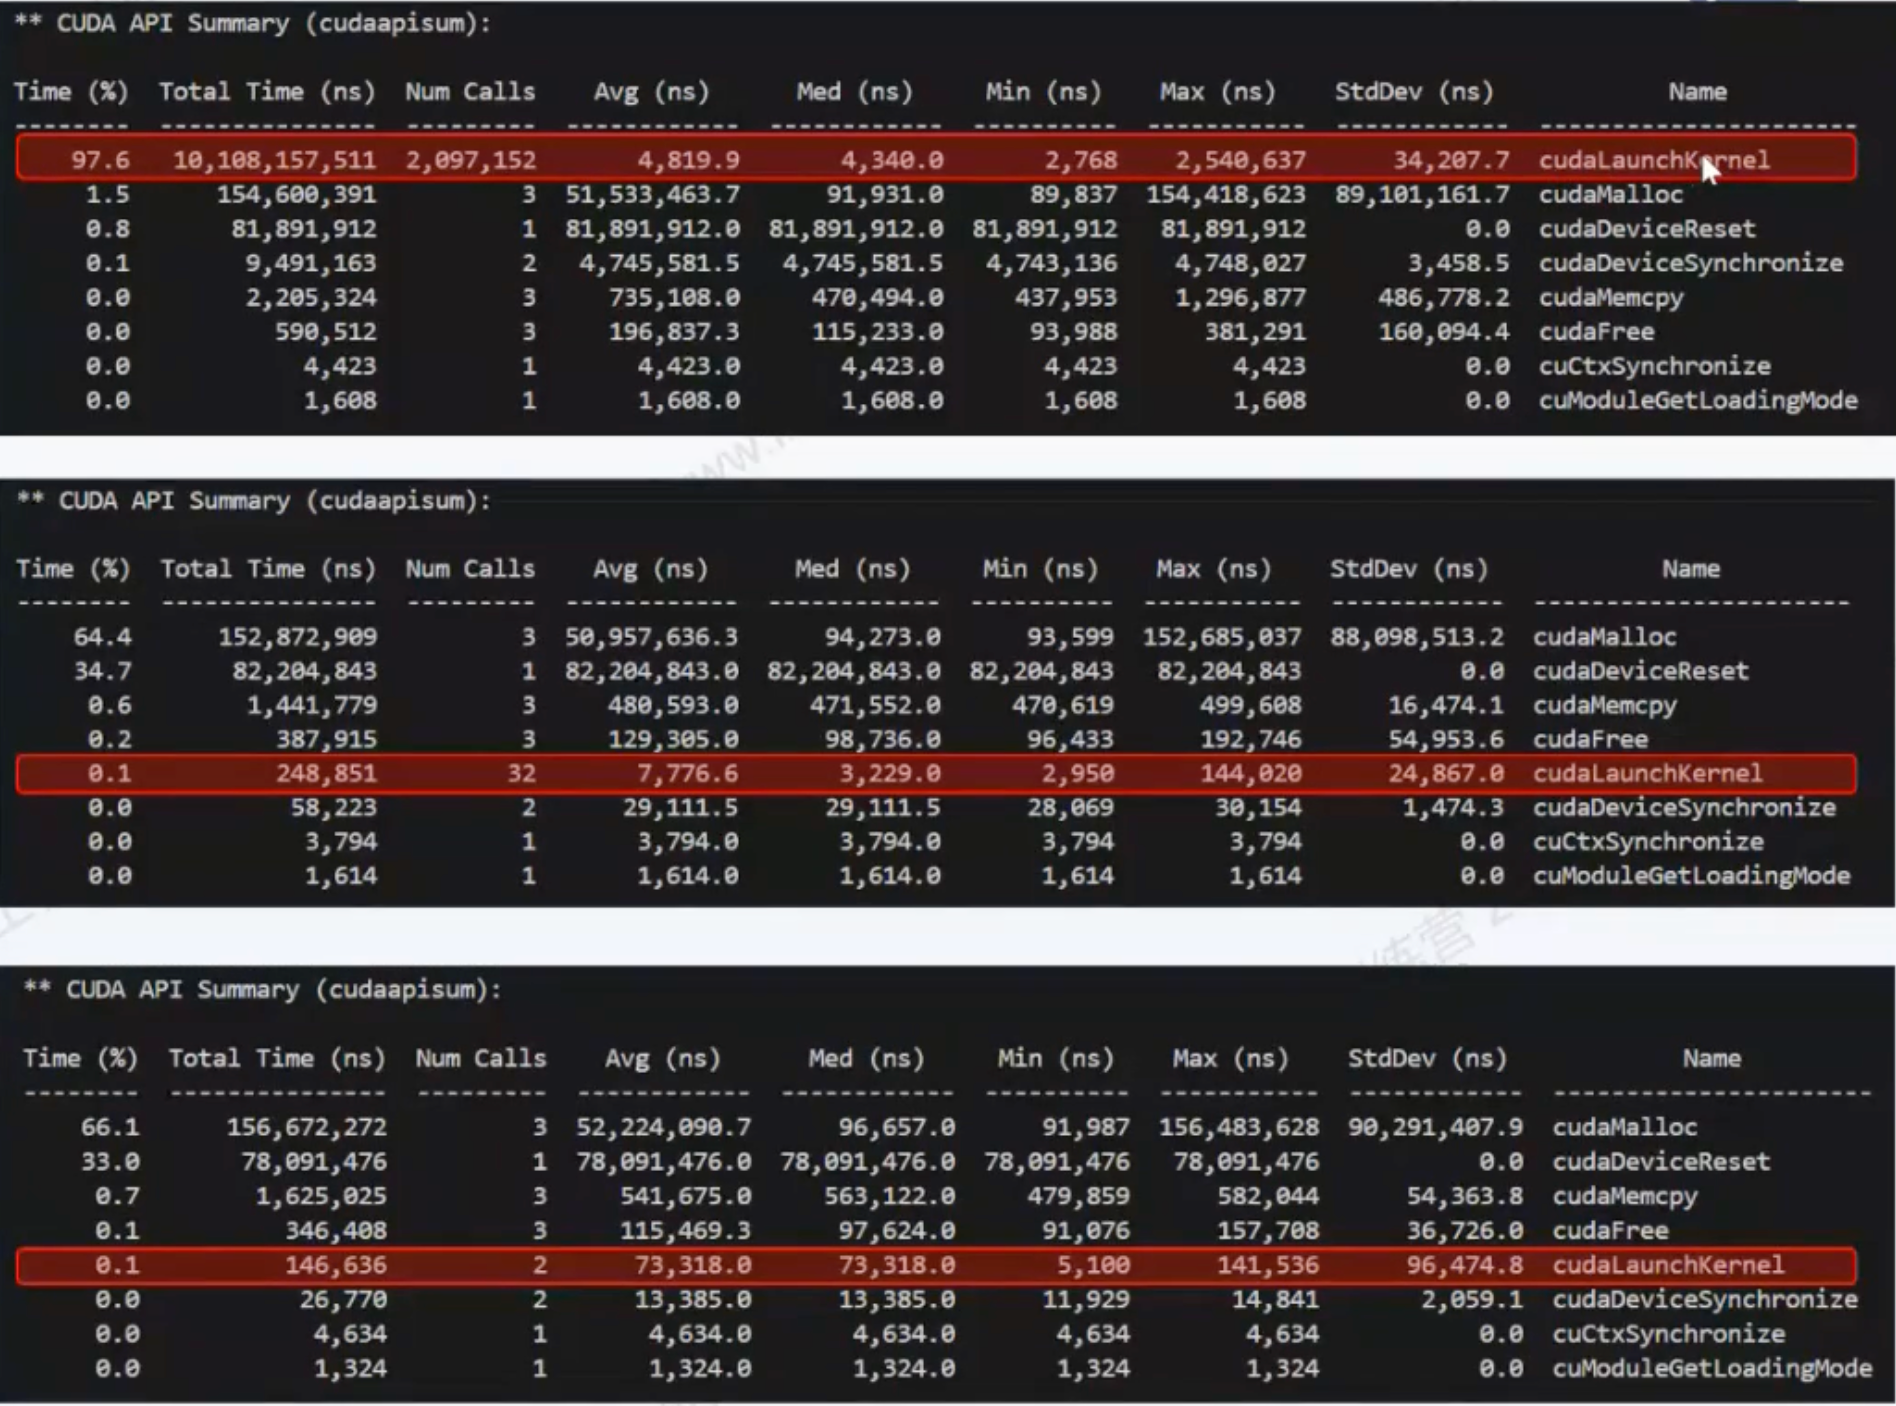
CUDA API Summary:有哪些的CUDA API被调用了
- cudaLaunch:每次调用
<<<>>>,CPU 都要向 GPU 发送指令,这个延迟通常在 5~10 微秒左右 - <<<1,1>>>:GPU 上巨大的计算资源(数千个 CUDA 核心)只有 1 个线程在工作,其余全部闲置
- 加速比:Tcpu/Tgpu
- 总耗时: 𝑻𝑯𝟐𝑫 + 𝑻𝒌𝒆𝒓𝒏𝒆𝒍 + 𝑻𝑫𝟐𝑯(HtoD 和 DtoH 的耗时均远大于核函数时间)
- cudaLaunch:每次调用
设备信息:
- maxGridSize (int[3]):整个 Grid 在 x、y、z 三个方向上,最多可以有多少个 Block
- maxThreadsDim (int[3]):单个 Block 内部,在 x、y、z 三个方向上分别最多可以有多少个线程
- maxThreadsPerBlock (int):单个 Block 内部,最多可以容纳的线程总数(即 x * y * z 的乘积上限)
COMMENTS
评论