GEMM 优化
矩阵乘法GEMM
矩阵乘法(GEMM/Matmul)是深度学习中最为常见和重要的计算密集型算子之一
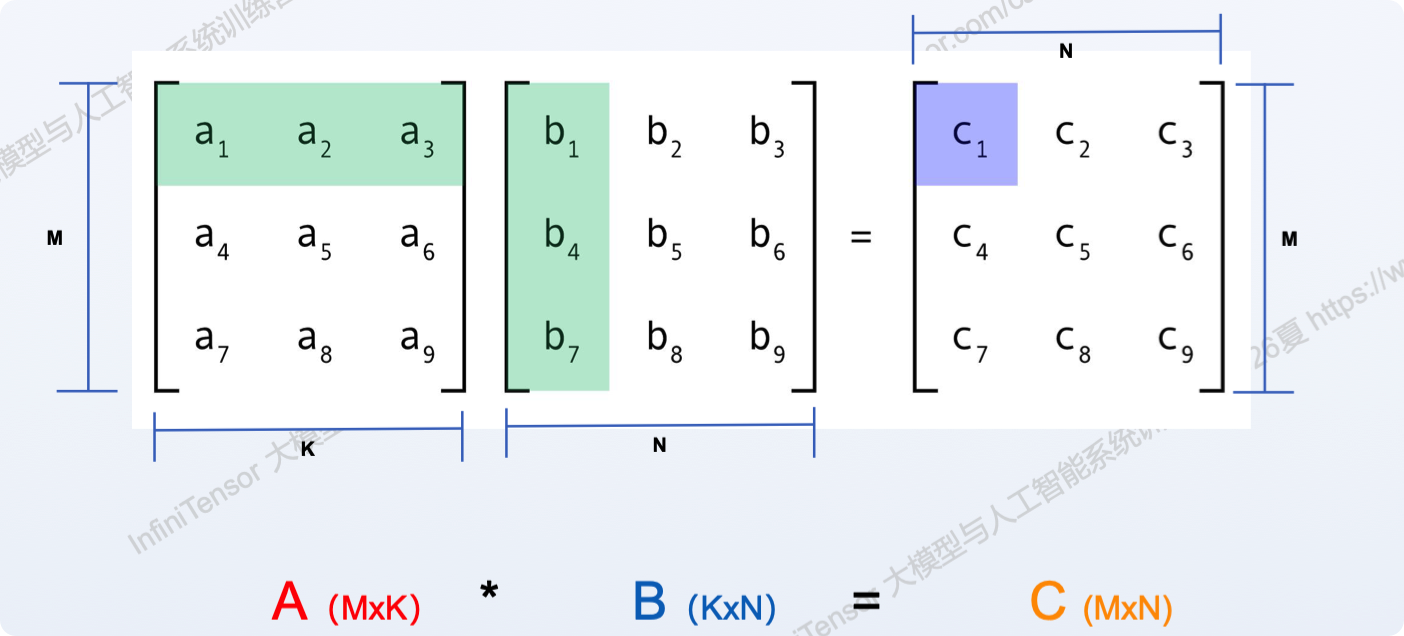
C(结果矩阵)中每个数(entry)对应 A 中的一行和 B 中的一列进行点积 —— O(N) 操作
C(结果矩阵)中一共有 NxN 个数,因此计算的总复杂度为: O(N3)
人工一共三个矩阵,一共有3N2个数,因此访存的总复杂度为: O(N2)
计算复杂度 > 访存复杂度: GEMM 理论上确实是计算密集型
GEMM: C = αA * B + βD
- α 和 β: 标量,缩放因子,一般均为 float;
- D: 可以和 C 是同一个 (in-place)
template<typename T>
__global__ void gemm_naive(int M, int N, int K, float alpha,
                           const T *A, const T *B, float beta,
                           T *C) {
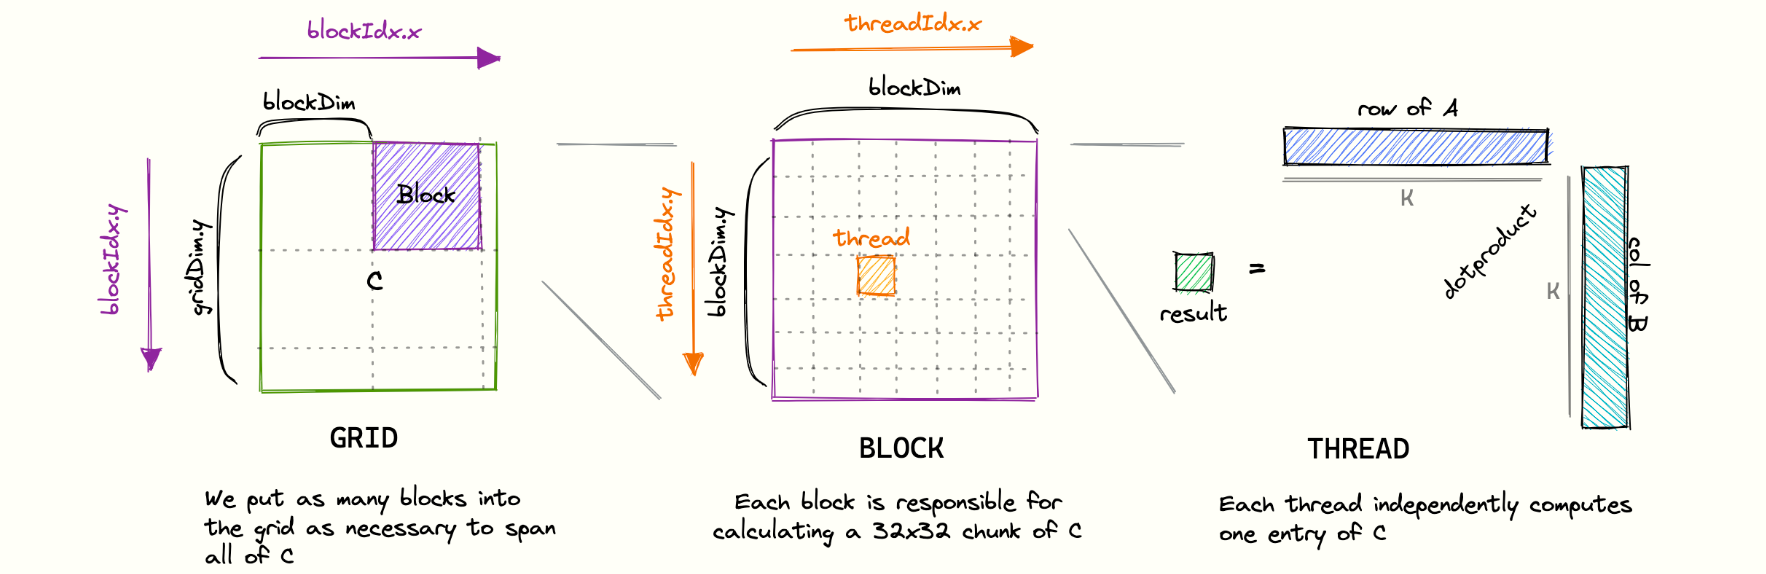
    int row = blockIdx.y * blockDim.y + threadIdx.y; // Row of C (varies per thread in x-direction)
    int col = blockIdx.x * blockDim.x + threadIdx.x; // Column of C (fixed per thread in y-direction)

    if (row < M && col < N) {
        float sum = 0.0f;
        // Inner loop over k (dot product for C[row][col])
        for (int k = 0; k < K; ++k) {
            sum += A[row * K + k] * B[k * N + col];
        }
        C[row * N + col] = alpha * sum + beta * C[row * N + col];
    }
}-
二维数组在存储空间有两种存储方式:
- 行优先 (Row-Major):(a1, a2, a3, a4, a5, a6, a7, a8, a9)
- 列优先 (Column-Major):(a1, a4, a7, a2, a5, a8, a3, a6, a9)
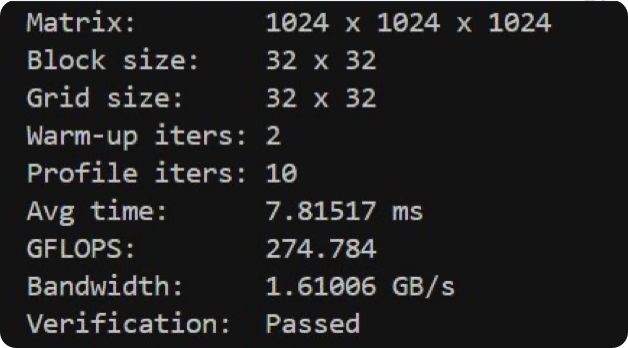
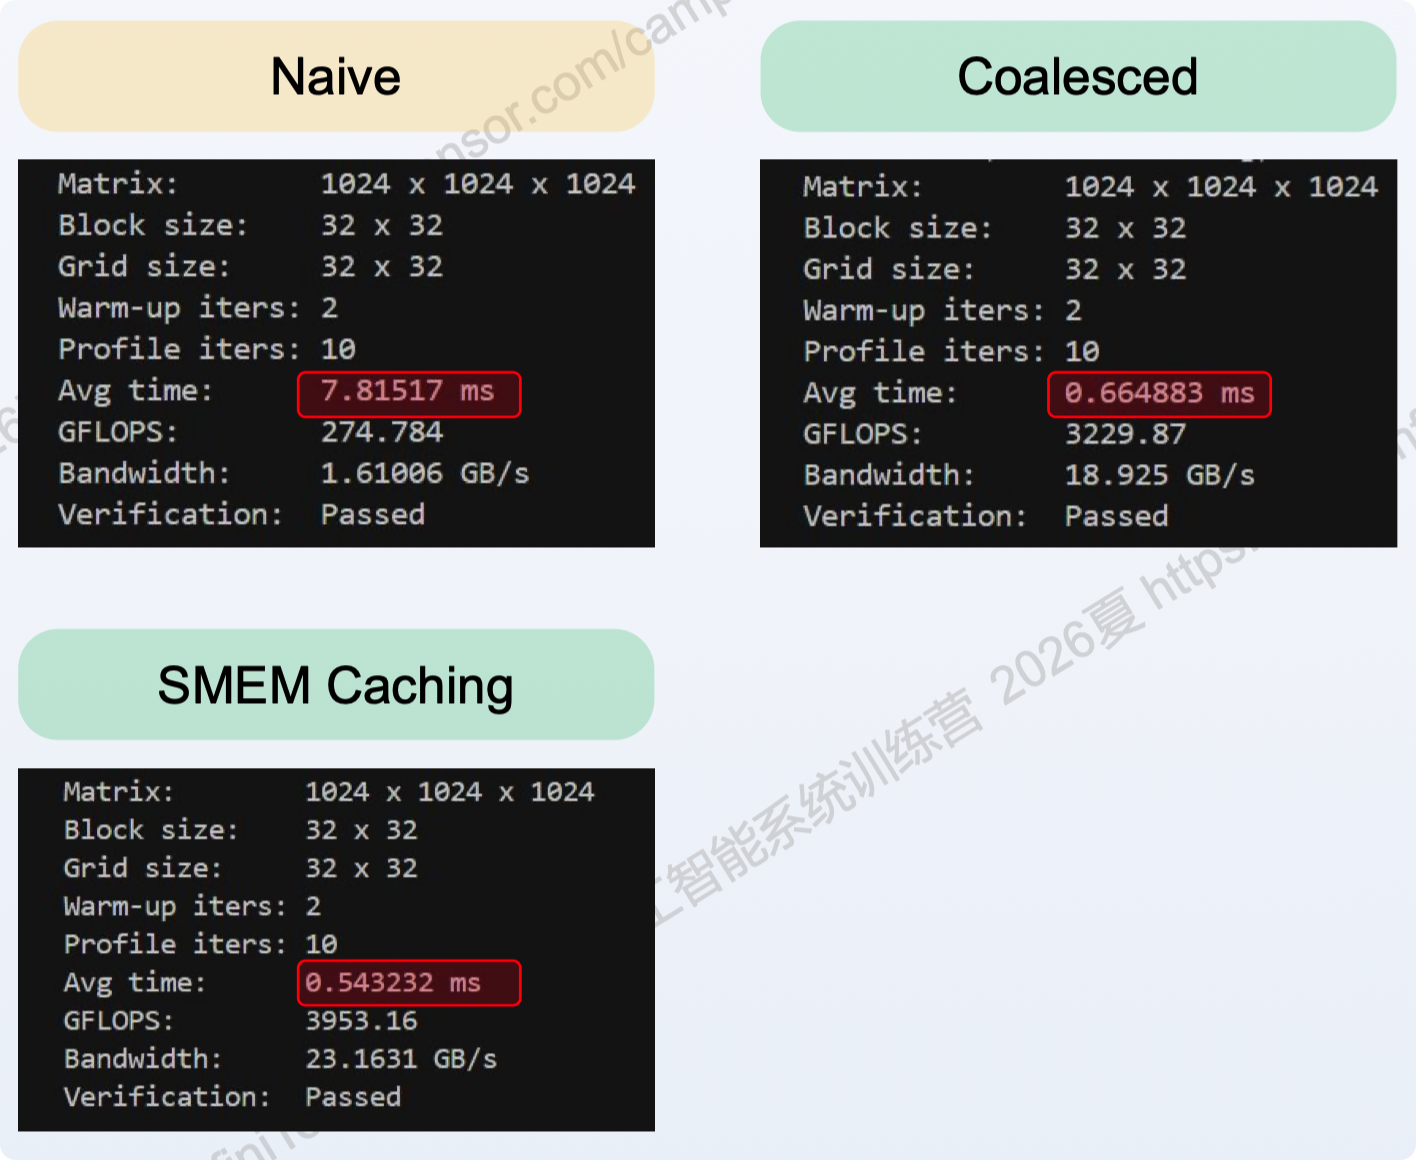
默认行优先,每个线程负责一个 C (结果矩阵) 中数值的计算(K 次的循环计算点积),C 中数值按列逐步计算
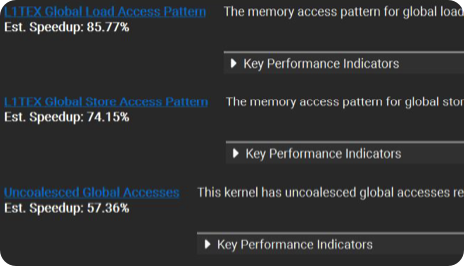
- L1TEX Global Load/Store Access Pattern——访存模式问题
- Uncoalesced Global Accesses——全局内存访问没内存合并
- L2 Theoretical Sectors Global Excessive——全局访存指令中额外的 L2 访问数量
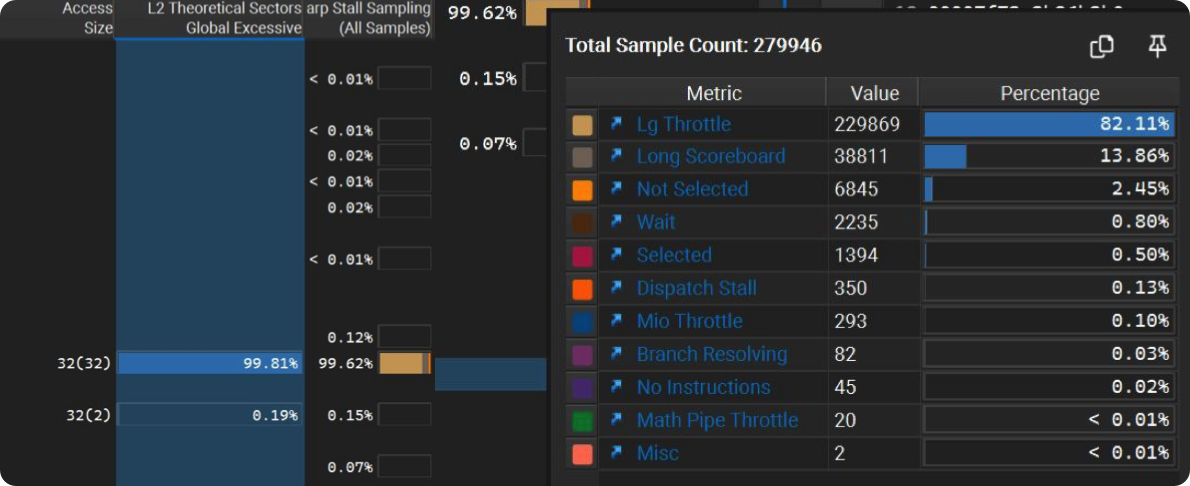
Lg Throttle高——因为本地和全局内存访问过频使得 Warp 等待
理论性能下界
假设使用两个 4092 × 4092 的 FP32 矩阵,并计算
GEMM:C = αAB + βC
- 计算量下限
C 中共有 4092² 个元素。每个元素都要计算 A 的一行和 B 的一列的点积:
一个点积包含 4092 次乘法和 4092 次加法。GPU 常把这两步合成一次 FMA 指令,但性能统计仍按 2 次浮点运算计算,因此每个输出元素约需要 2 × 4092 FLOPs
矩阵乘法部分的总计算量为:
因为 GEMM 还要把 αAB 与 βC 相加,每个输出元素再增加一次加法,所以估算为:
如果显卡的 FP32 峰值是 30 TFLOPs/s,只考虑计算时的理想时间约为:
- 数据传输下限
每个 FP32 数占 4 字节。对于 C = αAB + βC,理想情况下至少要:
- 读入 A、B 和旧的 C:
3 × 4092² × 4 B ≈ 201 MB - 写回新的 C:
4092² × 4 B ≈ 67 MB
因此最少需要传输约 268 MB,假设 A 和 B 被缓存后可以反复复用,不需要每次使用都重新从显存读取
如果显存带宽是 768 GB/s,理想的数据传输时间约为:
- 如何判断瓶颈
计算下限约为 4.57 ms,数据传输下限约为 0.35 ms。由于 GPU 可以在搬数据的同时进行计算,理想总时间的下限近似取两者中较大的值:
所以在这个规模和硬件上,GEMM 主要是计算受限,而不是显存带宽受限。实际程序如果搬运的数据量超过理论最小值很多,情况就会改变,最终可能变成数据受限
GeMM——Native
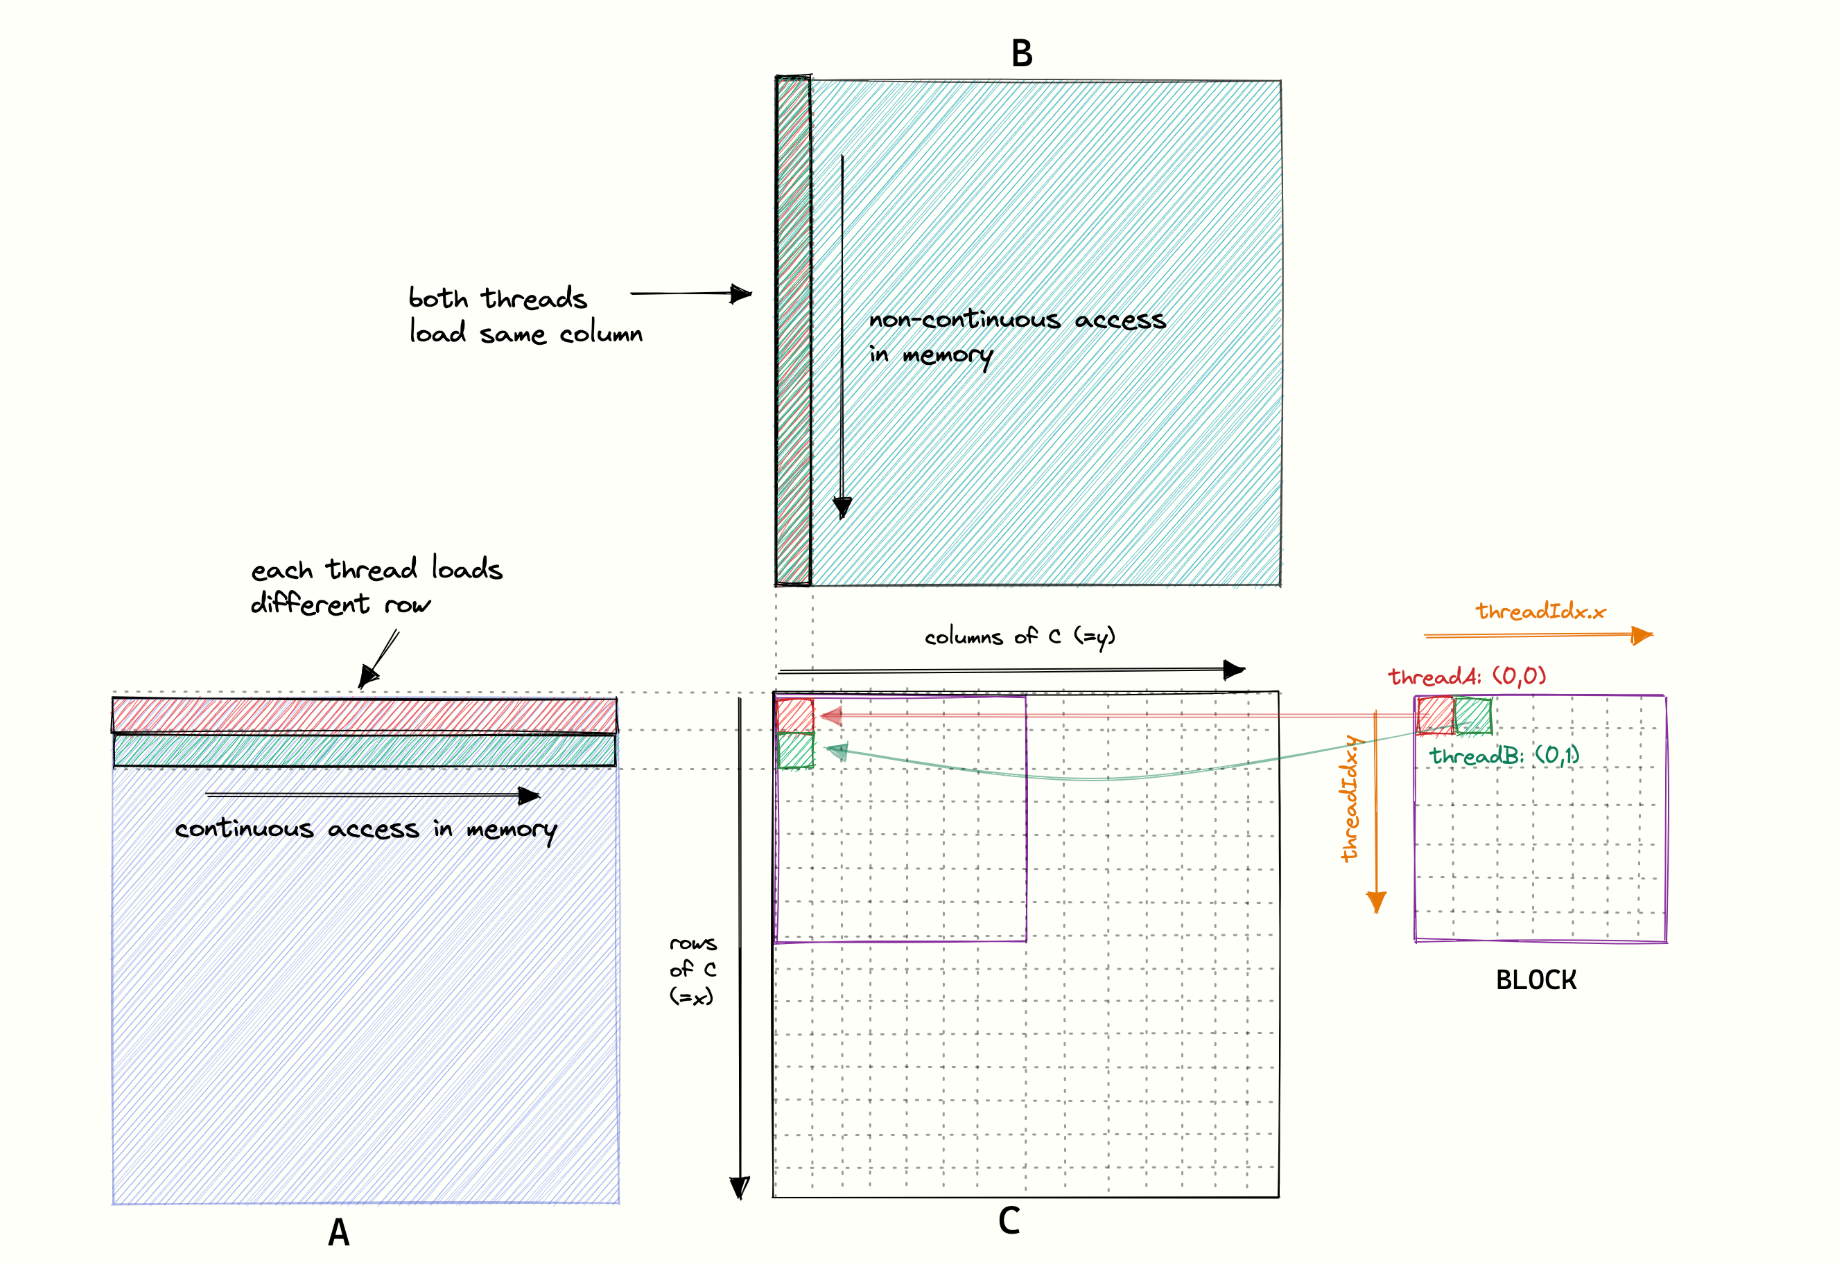
int row = blockIdx.y * blockDim.y + threadIdx.x;
int col = blockIdx.x * blockDim.x + threadIdx.y;
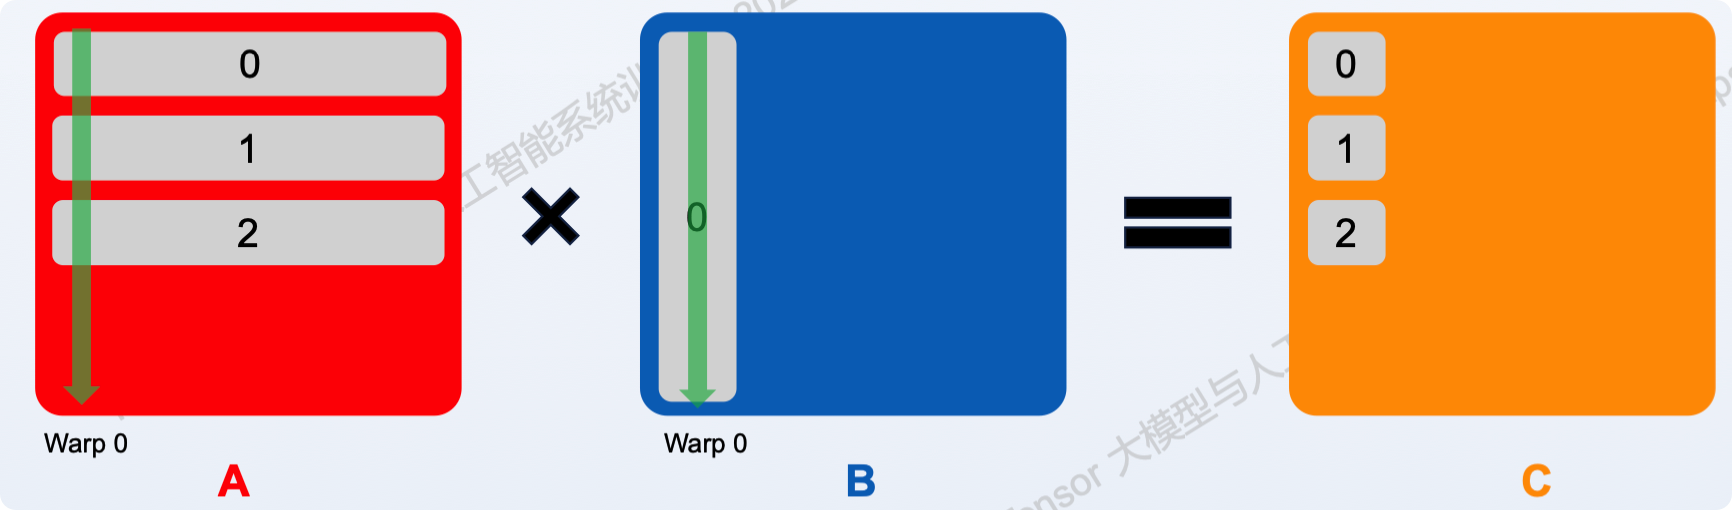
为了计算 C 的一列,一个 Warp里的线程会去读取 B 矩阵的同一列的 32 个不同行(比如 Thread 0 读 B[0][0],Thread 1 读 B[1][0],Thread 2 读 B[2][0]…)
因为 B 是行优先存储,这 32 个数据在内存里不是挨着的,而是隔了 1024 个浮点数
- 此时,LSU(加载/存储单元)看到这 32 个线程发出的内存请求是极其分散的。
- 原本读取连续的 128 字节只需要 1 次内存事务,现在为了读取这散落的 32 个数据,LSU 必须拆分成 32 次独立的内存事务
- 导致本地和全局内存访问过频,内存请求量瞬间暴涨 32 倍
GeMM-Coalesced
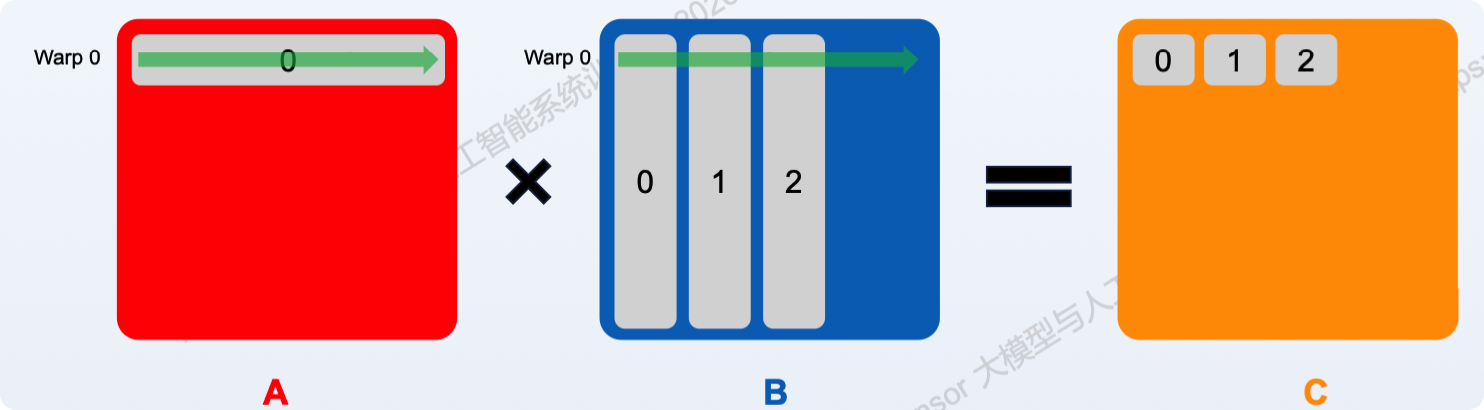
int row = blockIdx.y * blockDim.y + threadIdx.y;
int col = blockIdx.x * blockDim.x + threadIdx.x;
在一个 Warp中,threadIdx.x 是变化最快的,而 threadIdx.y 是固定不变的
- 同一个 Warp 里的32个线程,拥有相同的
threadIdx.y,所以row(行号)是一样的。 - 同一个 Warp 里的32个线程,拥有变化的
threadIdx.x,所以col(列号)是连续的(0, 1, 2…31)。
内存访问行为:
- 读取 A:
A[row * K + k]因为row相同,k固定,所以 这32个线程请求的是完全相同的一个地址,触发广播(Broadcast)机制 - 读取 B:
B[k * N + col]因为col是连续的(0~31),这32个线程请求的地址是k*N + 0,k*N + 1, …,k*N + 31。这些地址在内存中是连续的,LSU(加载/存储单元)可以一次性把这 128 字节的数据全部拉取过来 - 写入 C:
C[row * N + col]同理,col连续,写回的地址也是连续的,同样实现完美合并
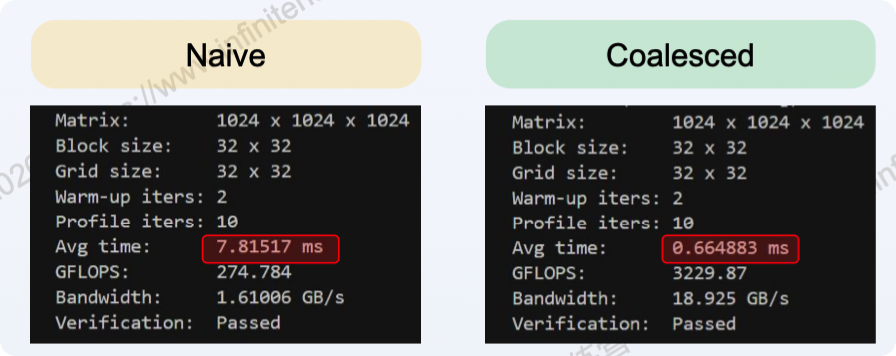
进一步优化
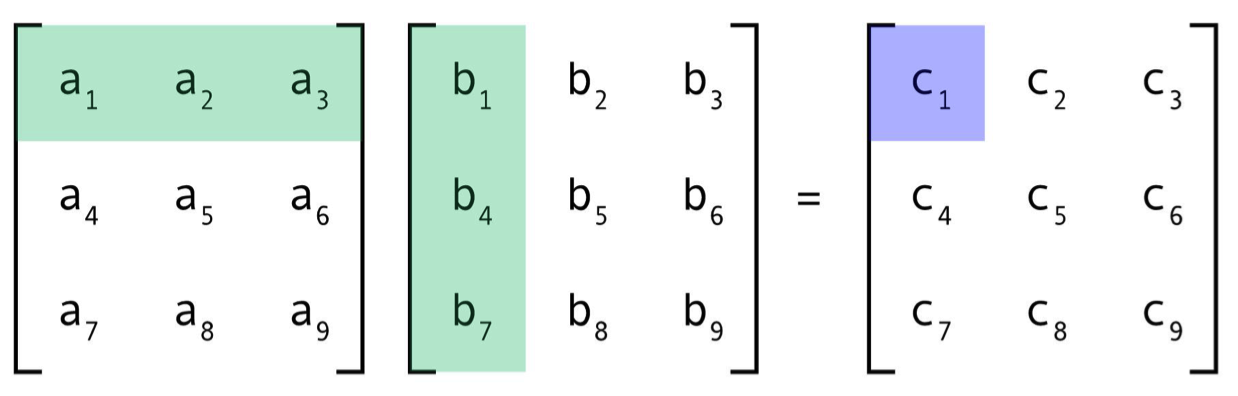
计算C的第一行时,重复从 GMEM 里反复读取A中的第一行内容,可以通过 SMEM 缓存来减少数据复用开销从而提高性能
但是容易达到硬件上限:nvlink error : Entry function '...' uses too much shared data (0x800000 bytes, 0xc000 max)
设置BLOCK_SIZE = 1024两个共享内存数组 As[1024][1024] 和 Bs[1024][1024]
假设数据类型 T 是 float(4字节):
- 单个数组大小 = 1024 × 1024 × 4 Bytes = 4 MB
- 两个数组总大小 = 4 MB + 4 MB = 8 MB
8 MB 的需求,面对 48 KB 的物理极限,差距是 170 多倍
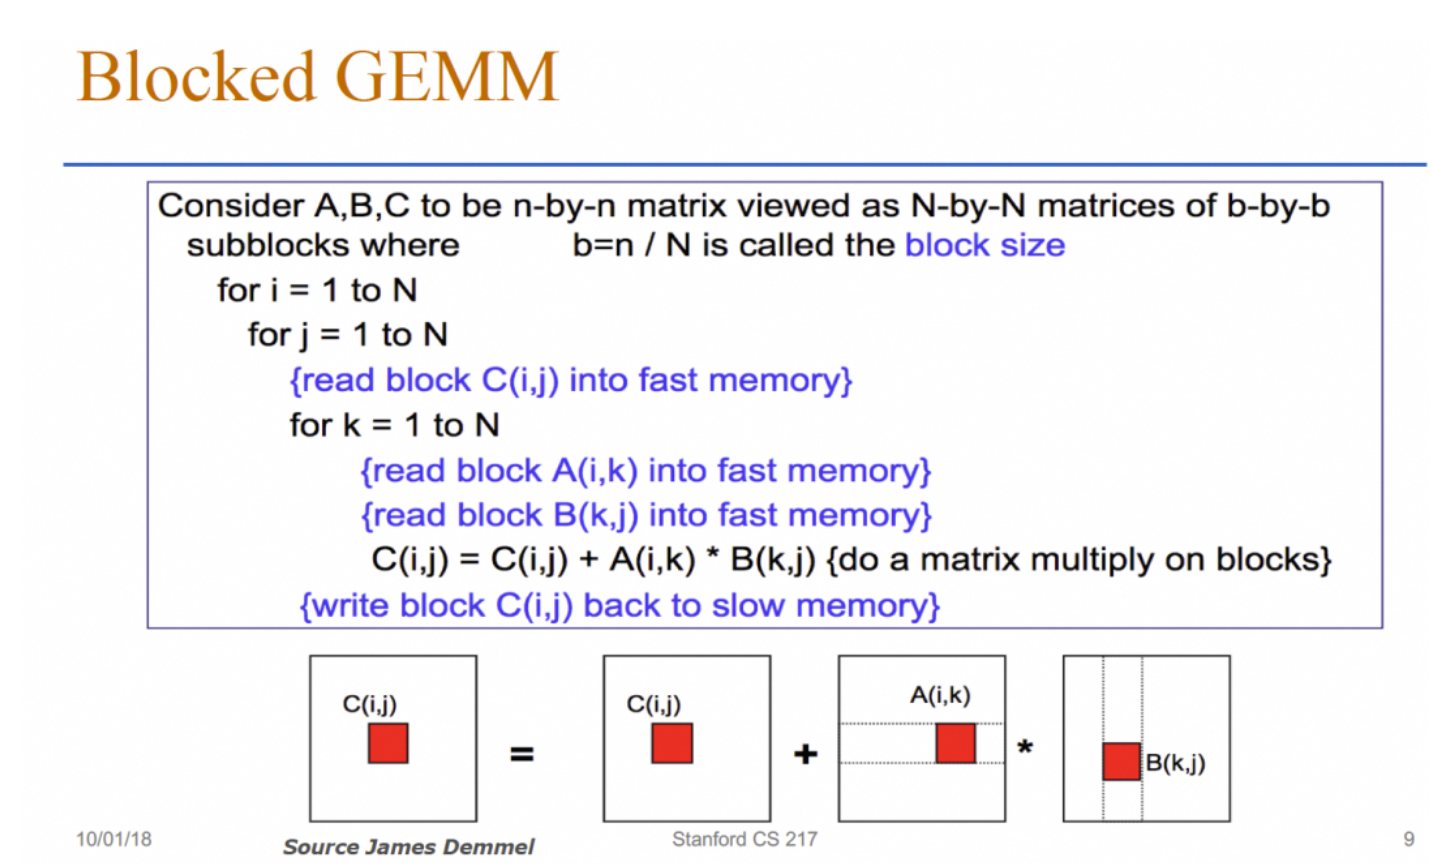
整个矩阵太大,那我们每次只取一部分
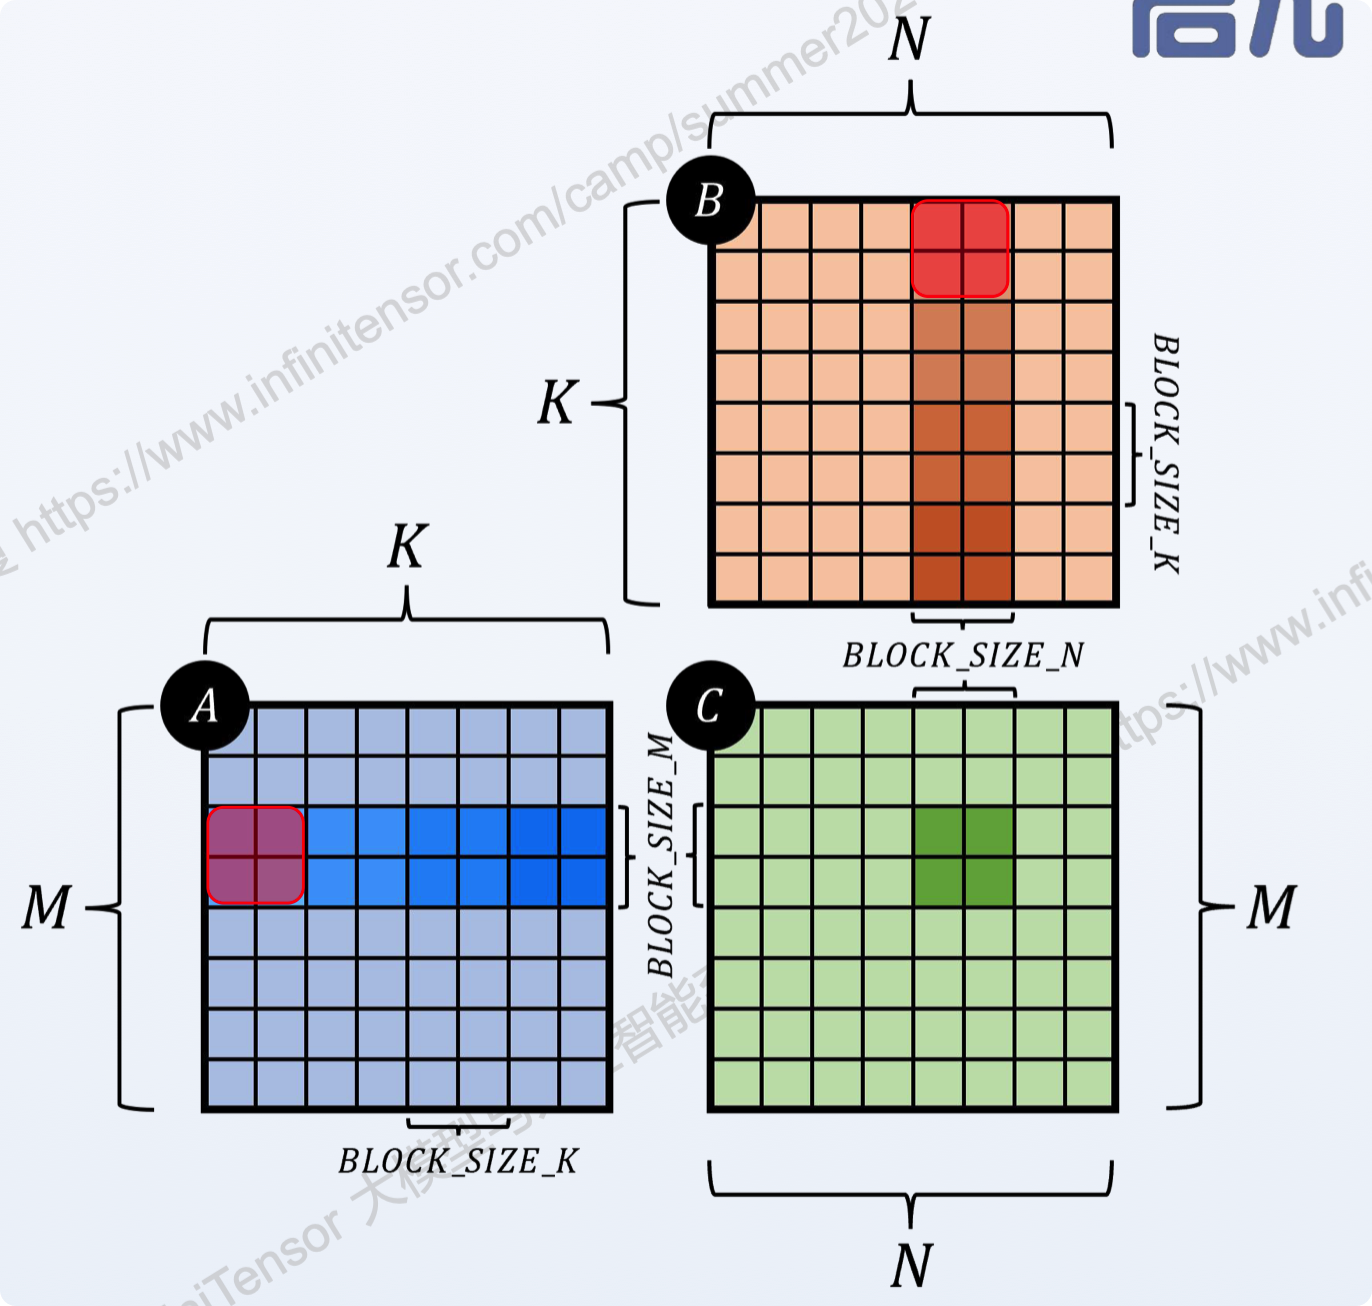
分块(Tiling)
每次仅从 GMEM 加载一块 (Tile) 到SMEM,然后计算这部分的数据
template<typename T>
__global__ void gemm_smem_caching(int M, int N, int K, float alpha,
                                  const T *A, const T *B, float beta,
                                  T *C) {
    __shared__ T As[BLOCK_SIZE][BLOCK_SIZE];
    __shared__ T Bs[BLOCK_SIZE][BLOCK_SIZE];

    int row = blockIdx.y * BLOCK_SIZE + threadIdx.y;
    int col = blockIdx.x * BLOCK_SIZE + threadIdx.x;
    // 在寄存器中声明一个累加器 tmp
    T tmp = T(0);

    for (int bk = 0; bk < K; bk += BLOCK_SIZE) {
        // Cooperative loading of A and B tiles into SMEM
        int a_row = row;
        int a_col = bk + threadIdx.x;
        As[threadIdx.y][threadIdx.x] = (a_row < M && a_col < K) ? A[a_row * K + a_col] : T(0);

        int b_row = bk + threadIdx.y;
        int b_col = col;
        Bs[threadIdx.y][threadIdx.x] = (b_row < K && b_col < N) ? B[b_row * N + b_col] : T(0);

        __syncthreads();

        for (int k = 0; k < BLOCK_SIZE; ++k) {
            tmp += As[threadIdx.y][k] * Bs[k][threadIdx.x];
        }
        __syncthreads();
    }

    // Write result with alpha/beta scaling
    if (row < M && col < N) {
        C[row * N + col] = alpha * tmp + beta * C[row * N + col];
    }
}
BLOCK_SIZE=32:选择 32 可以让线程与 Warp 完美对齐,方便共享内存的合并访存
所有 K 维度循环结束后,每个线程将寄存器里的 tmp 加上 alpha 和 beta 缩放因子,写入最终输出矩阵 C 的对应位置
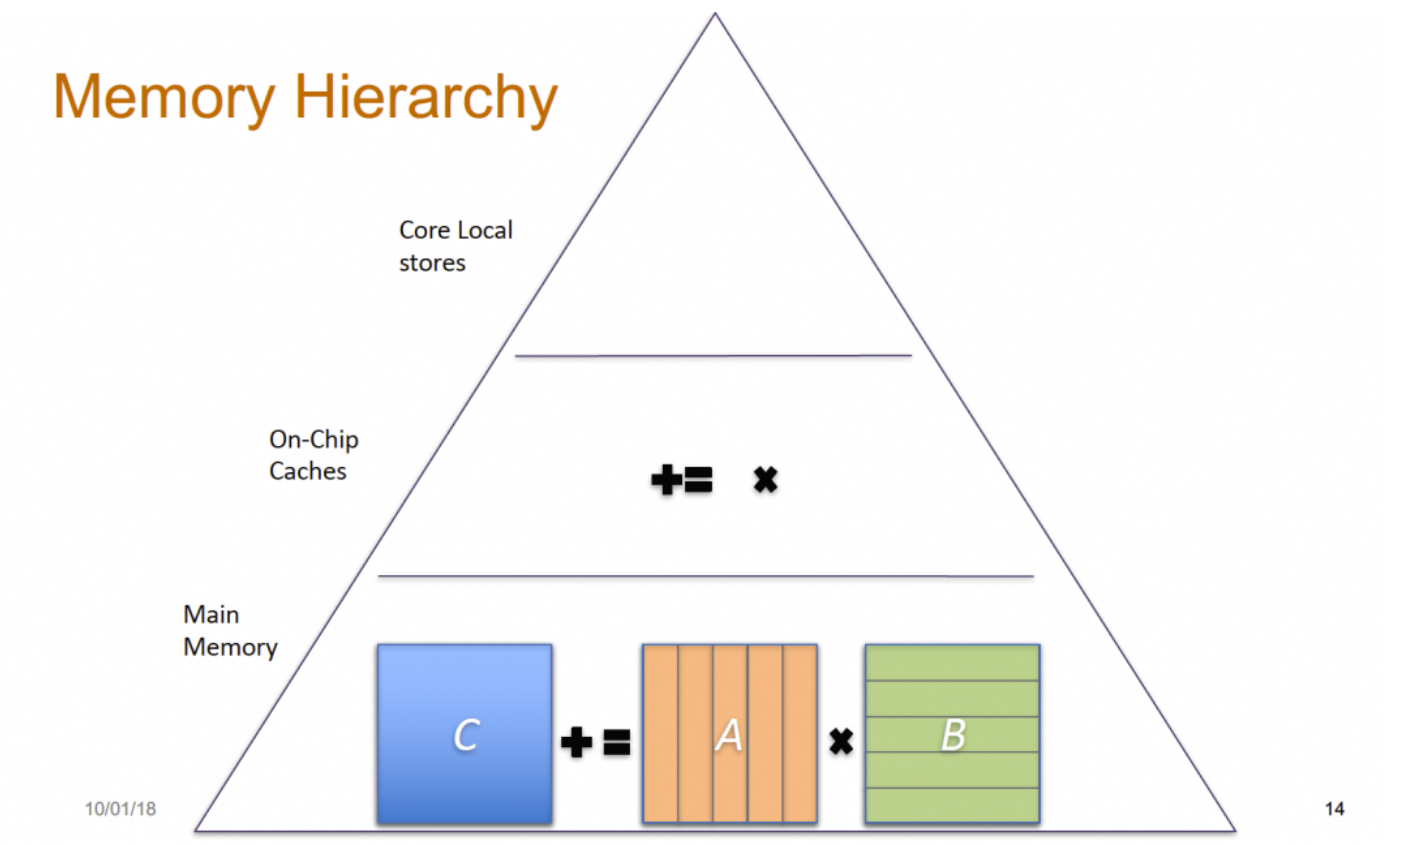
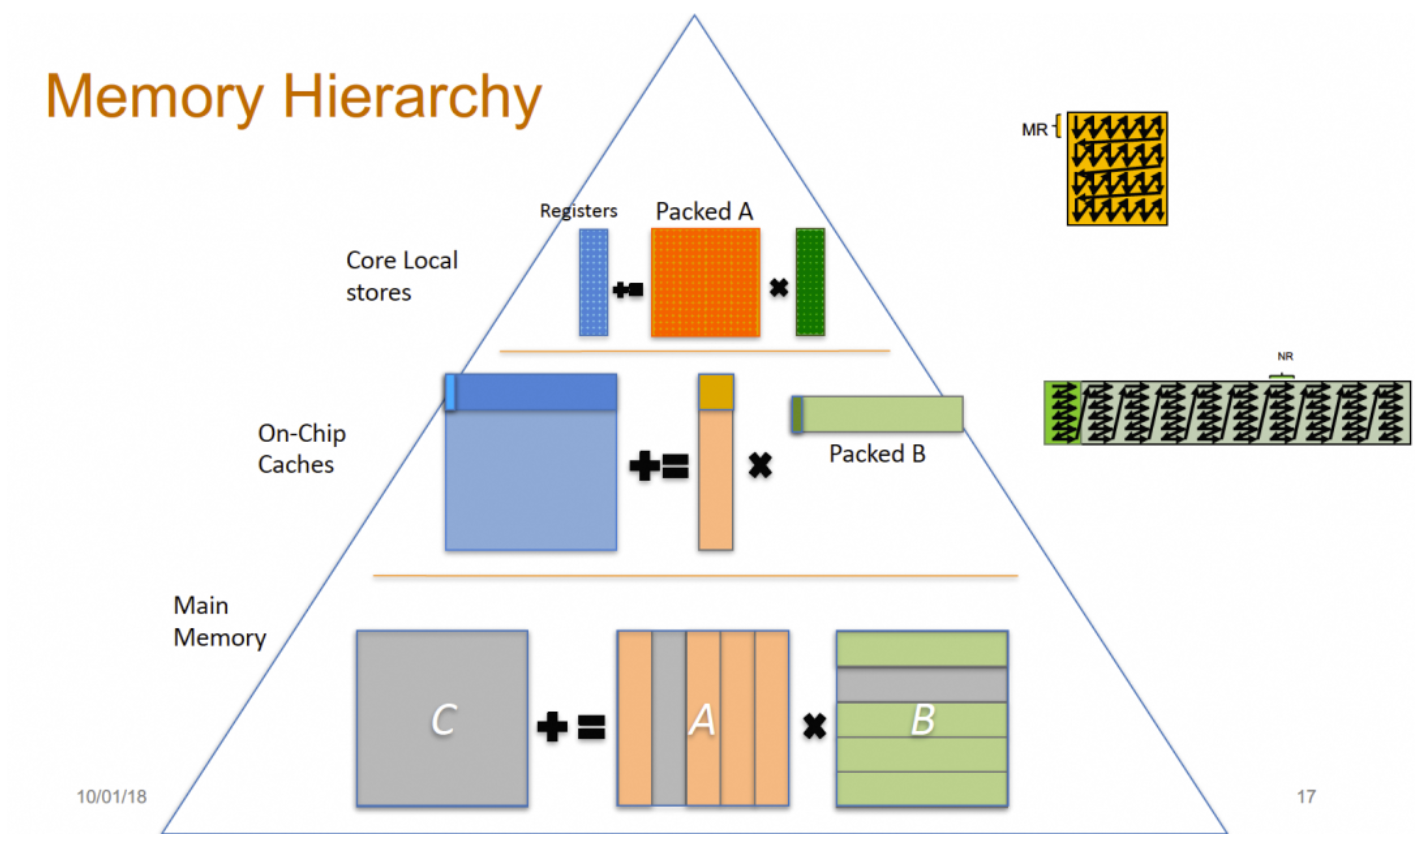
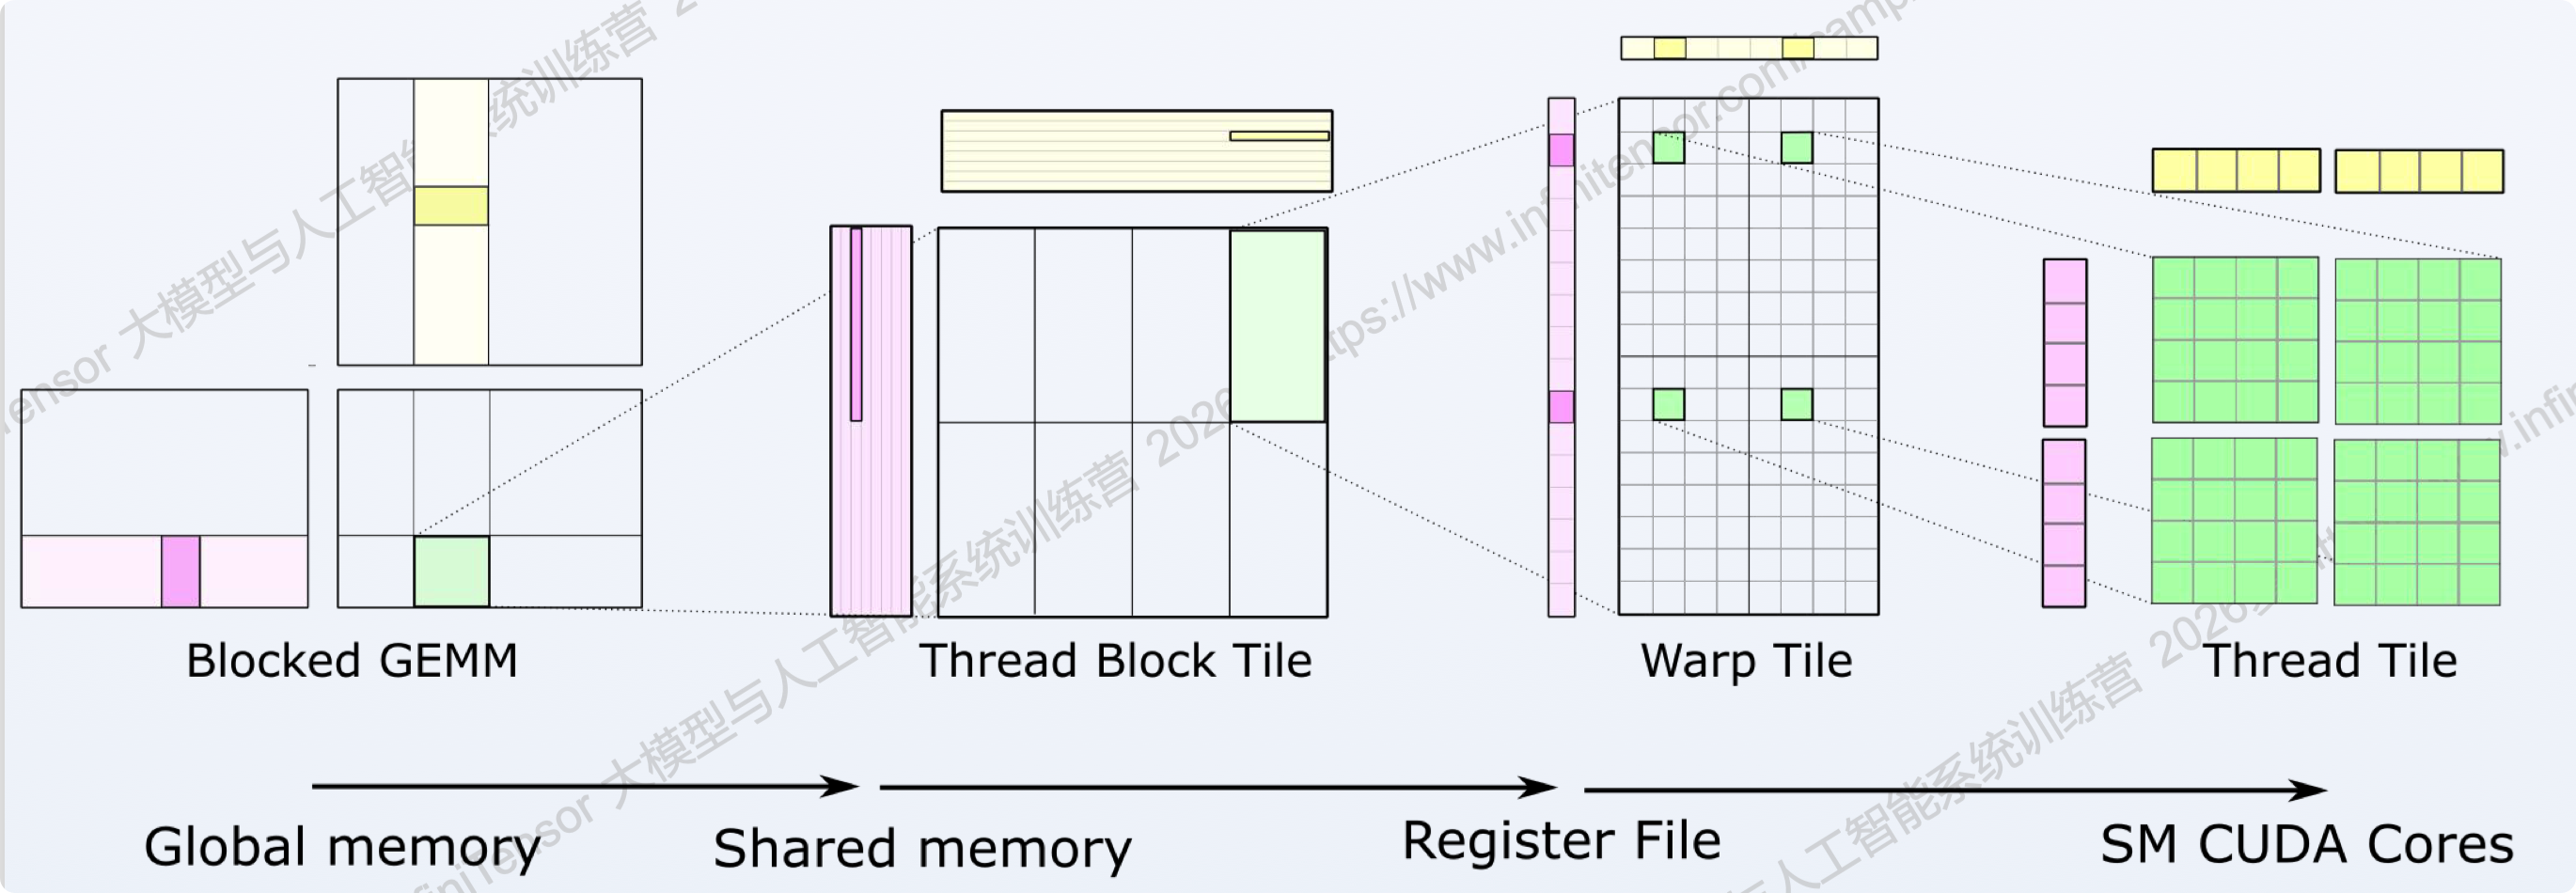
内存层次
首先所有的数据都在主内存中,如下图所示:
然后在分块加载到 L2Cache 中, 完成分块子任务
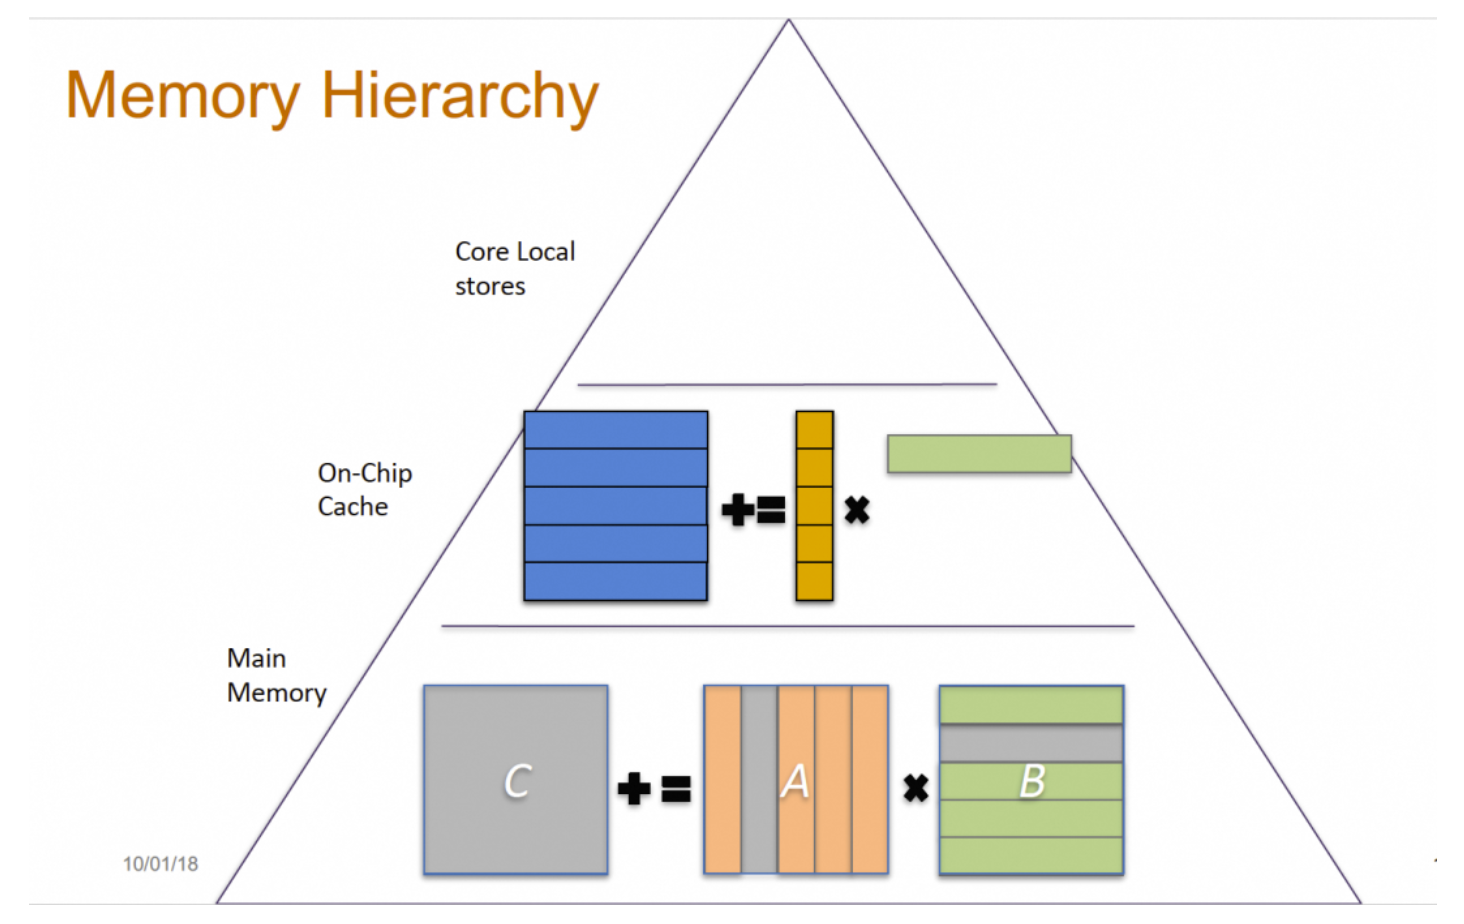
在进入计算核内部时,将向量 Block 进一步拆分成更小的 Tile 进行计算
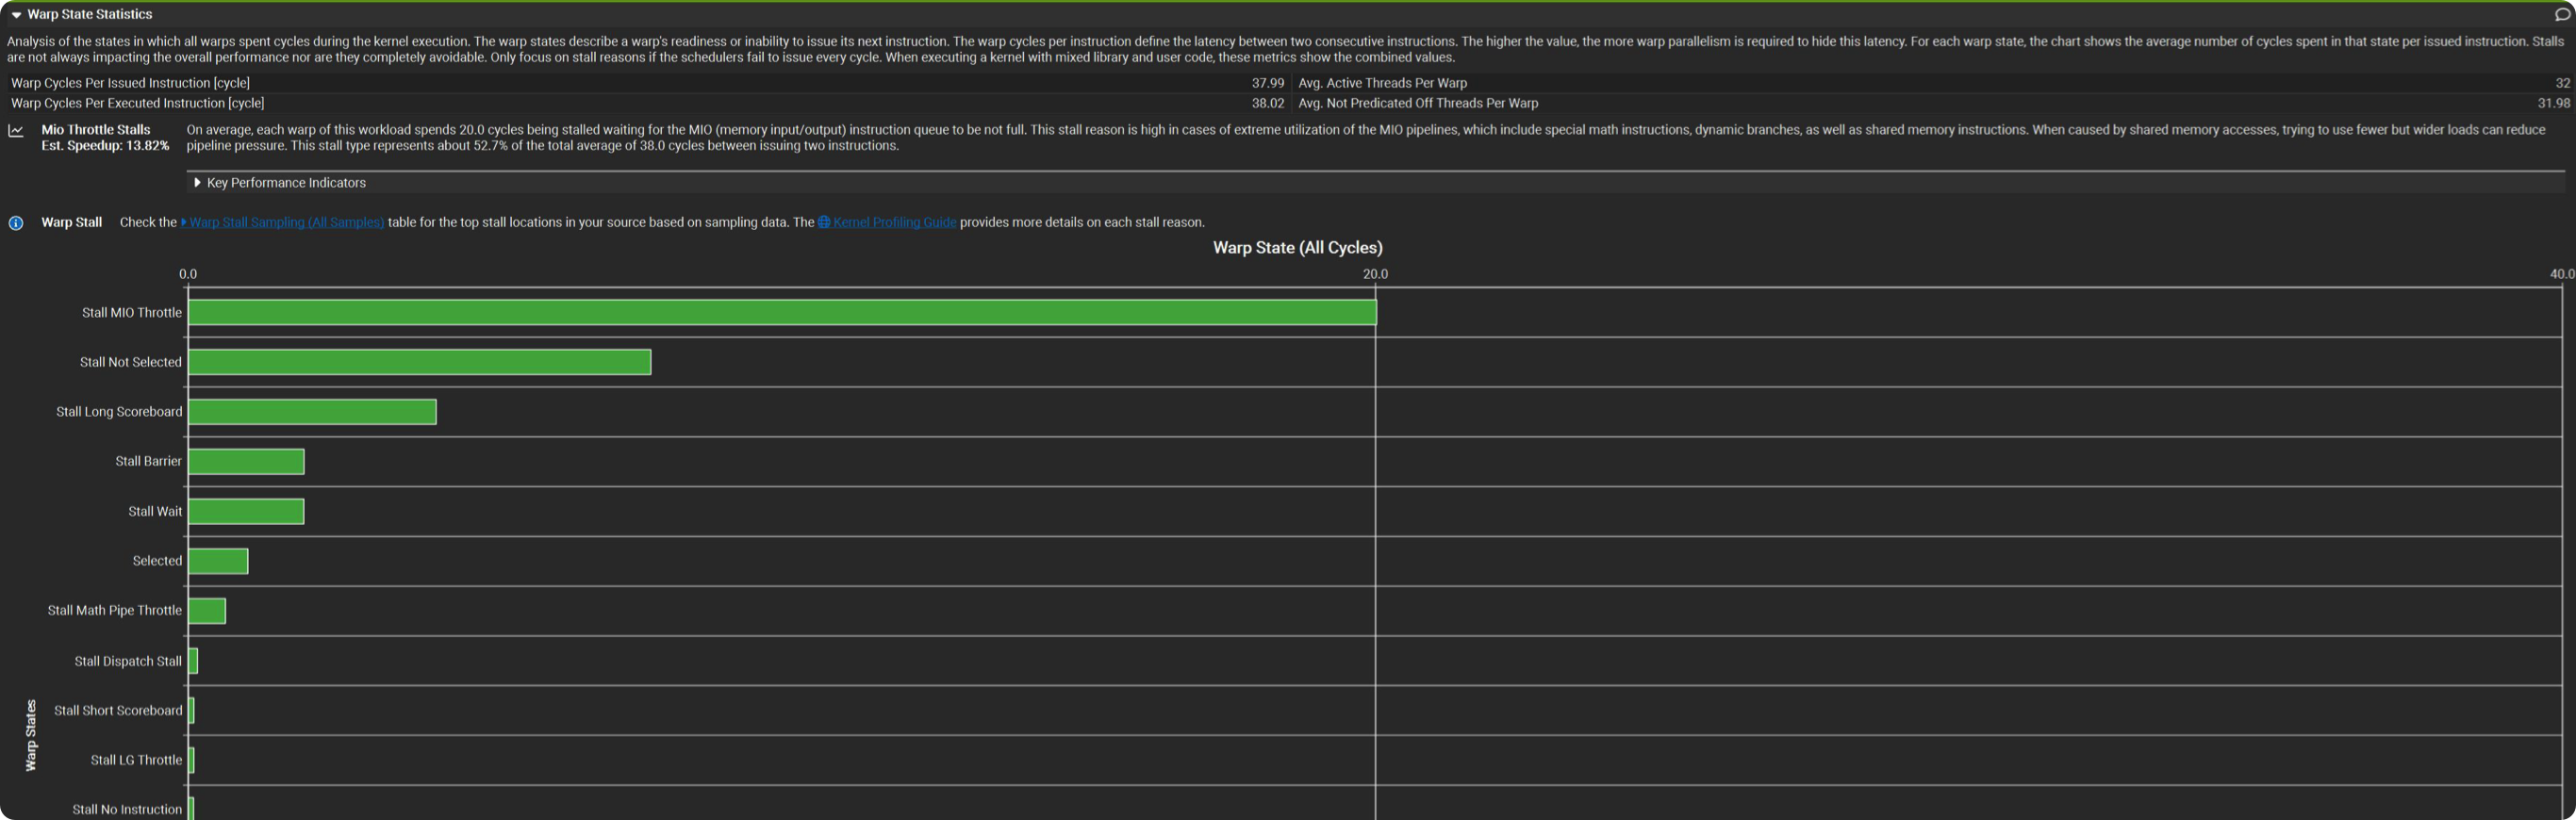
Stall MIO Throttle——Warp was stalled waiting for the MIO (memory input/output)
Warp 很多都在等待 SMEM (使用过于频繁)
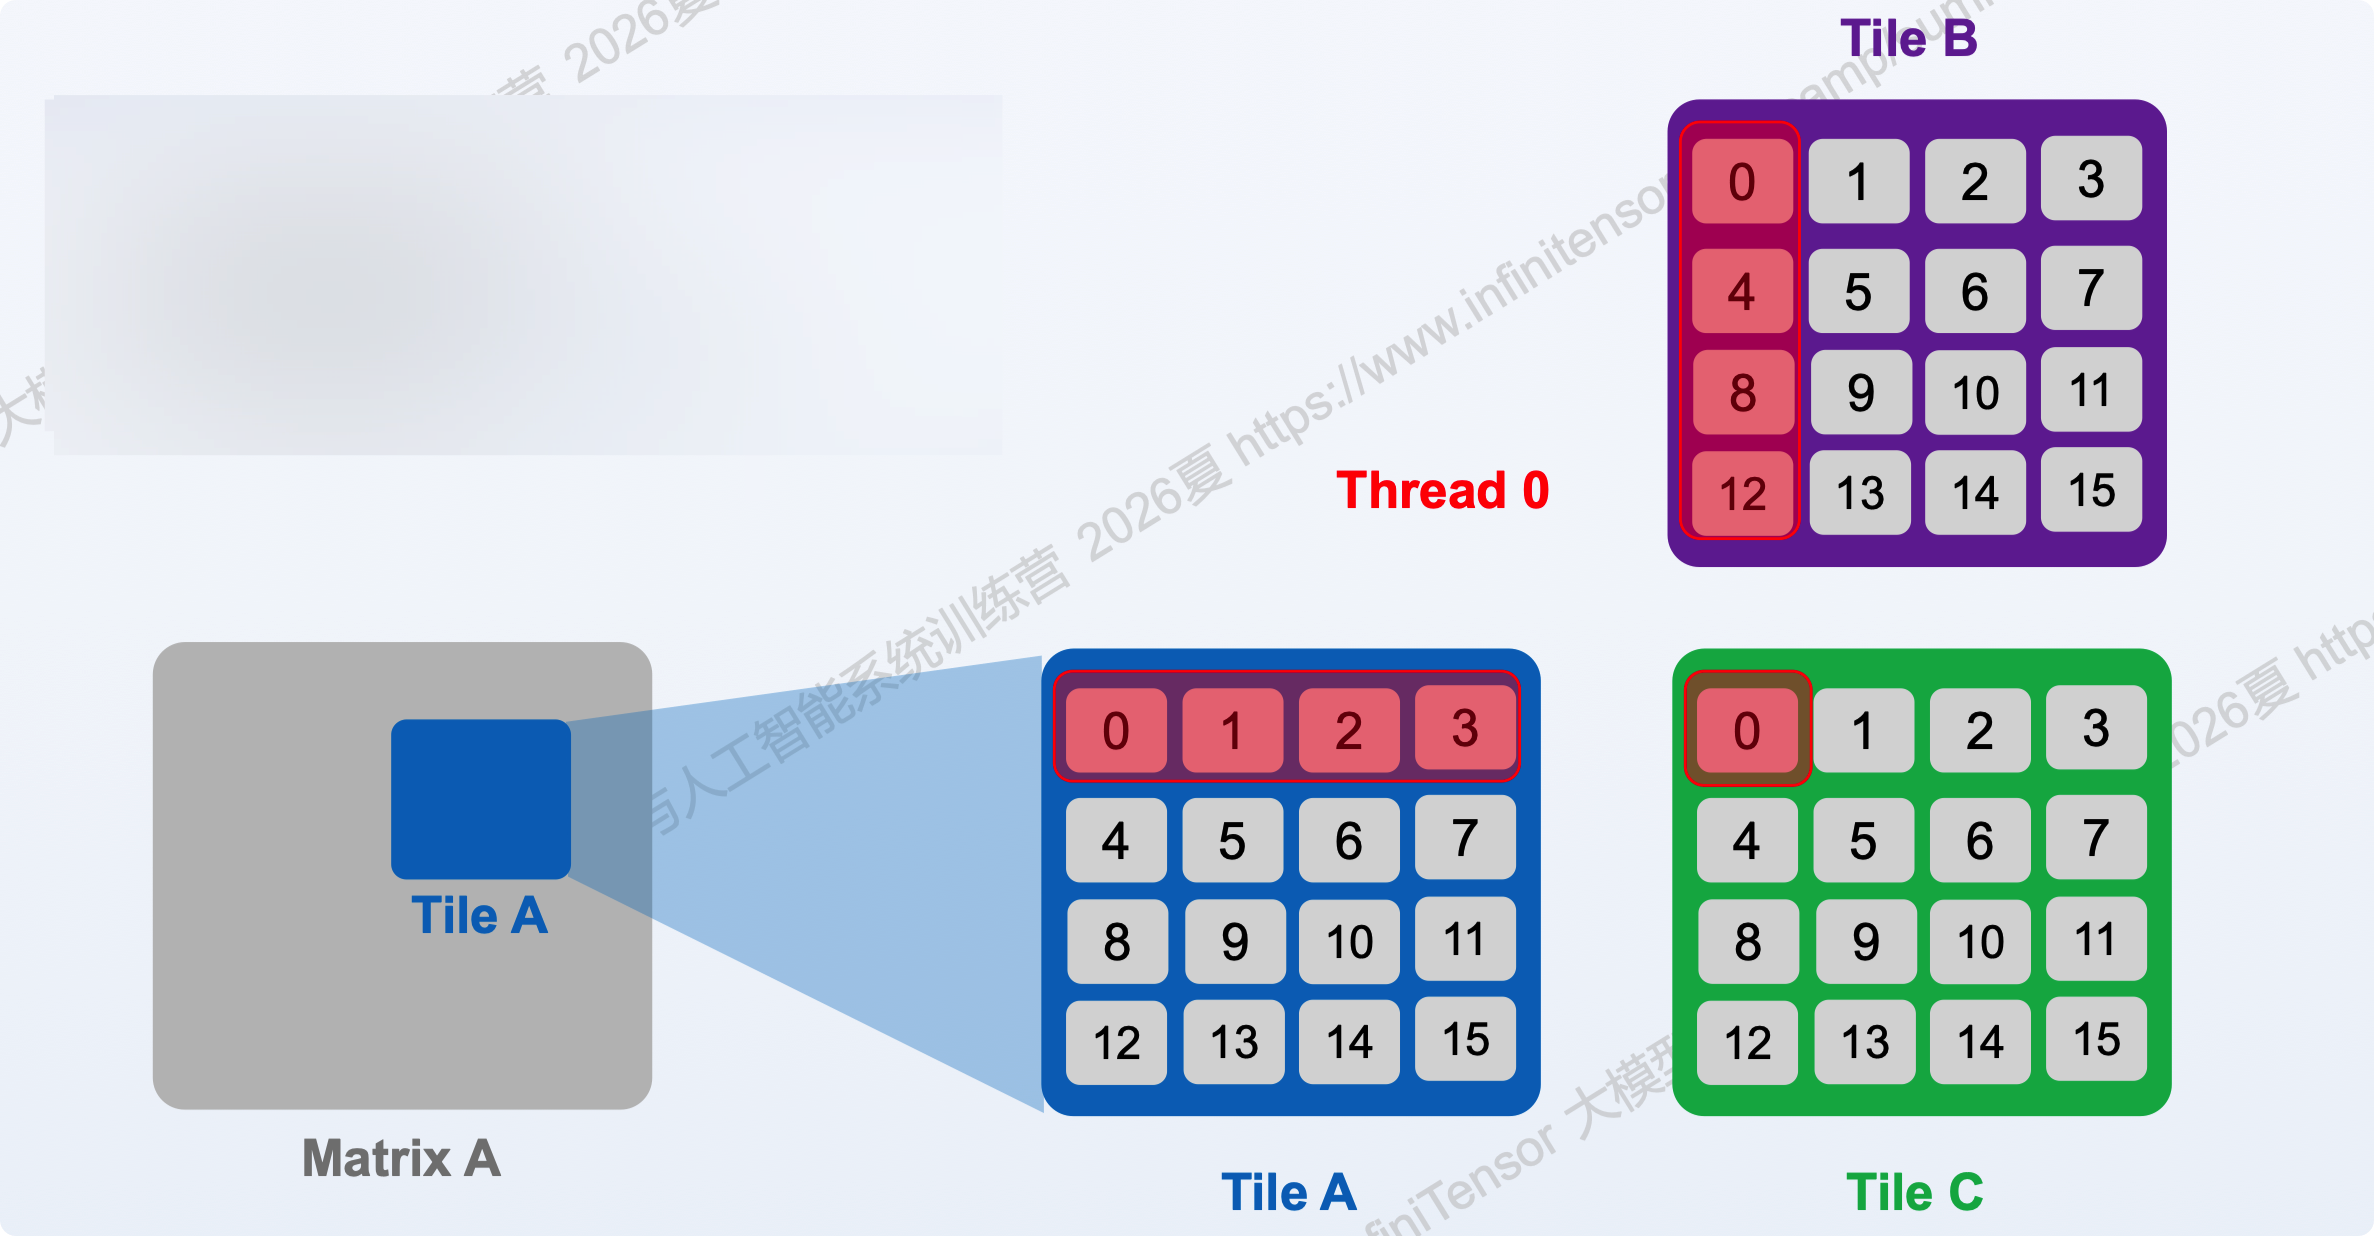
Thread 0 负责计算输出矩阵 Tile C 里的第一个元素
为了算这一个点,Thread 0 必须从共享内存 Tile A 里读一整行(0, 1, 2, 3),从 Tile B 里读一整列(0, 4, 8, 12)。每个线程都这么干,导致共享内存(MIO)访问极其频繁,引发了 Stall MIO Throttle
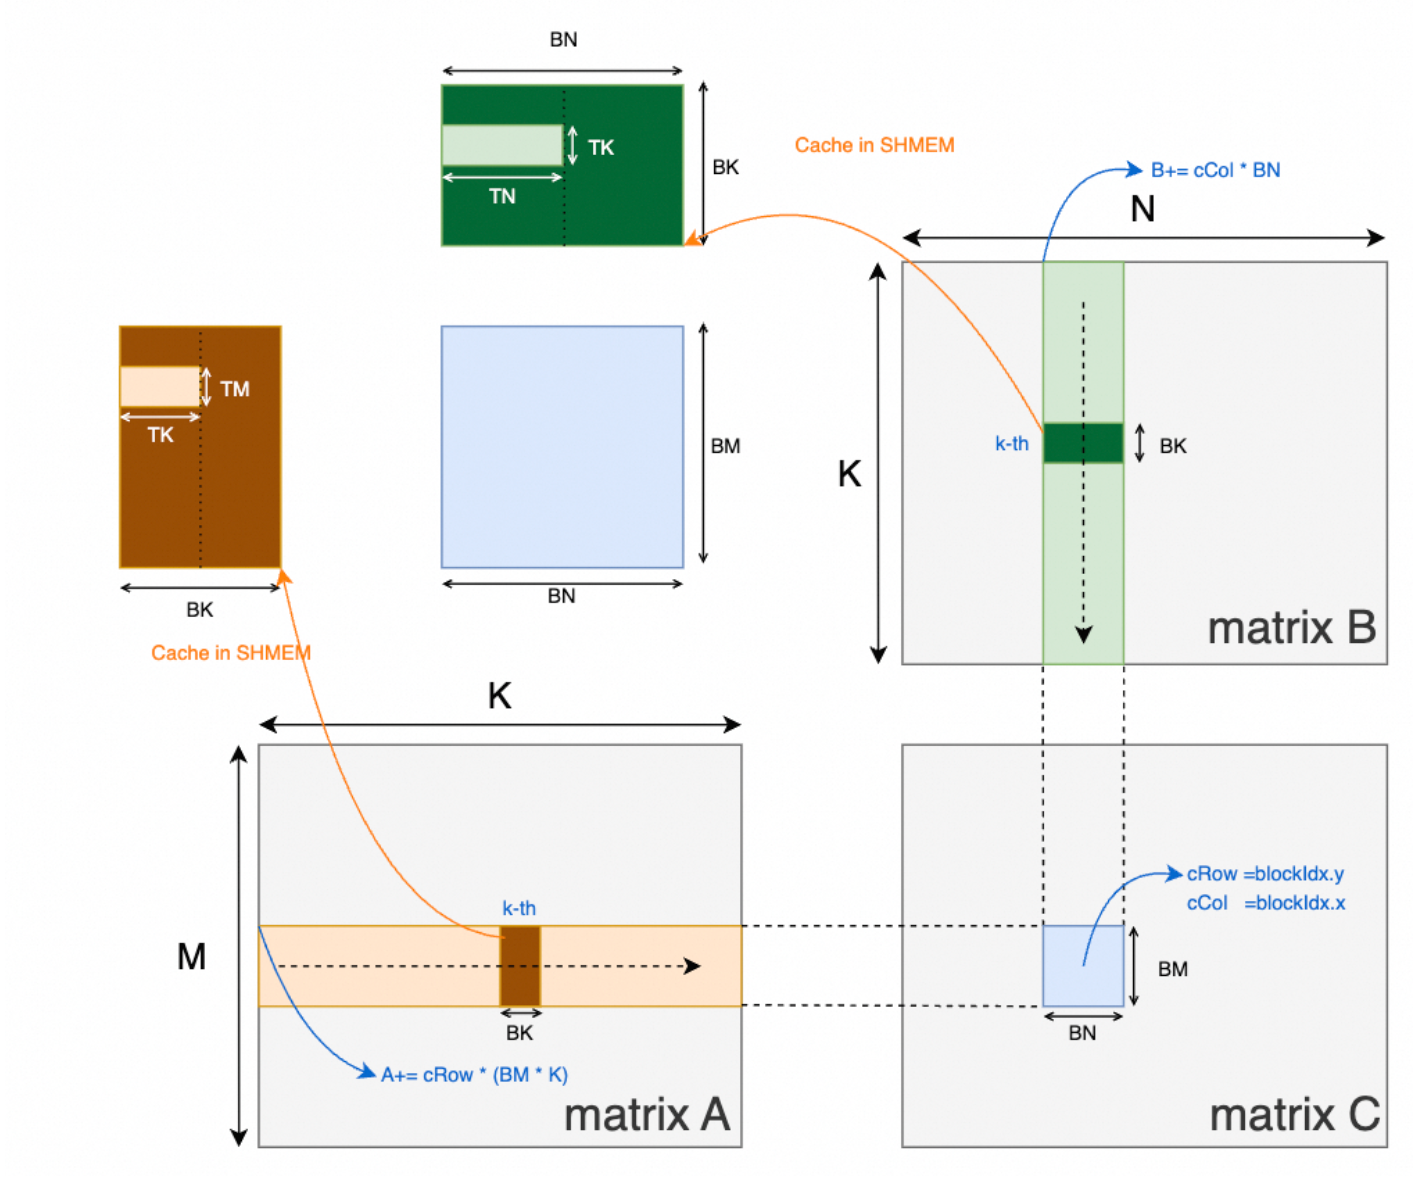
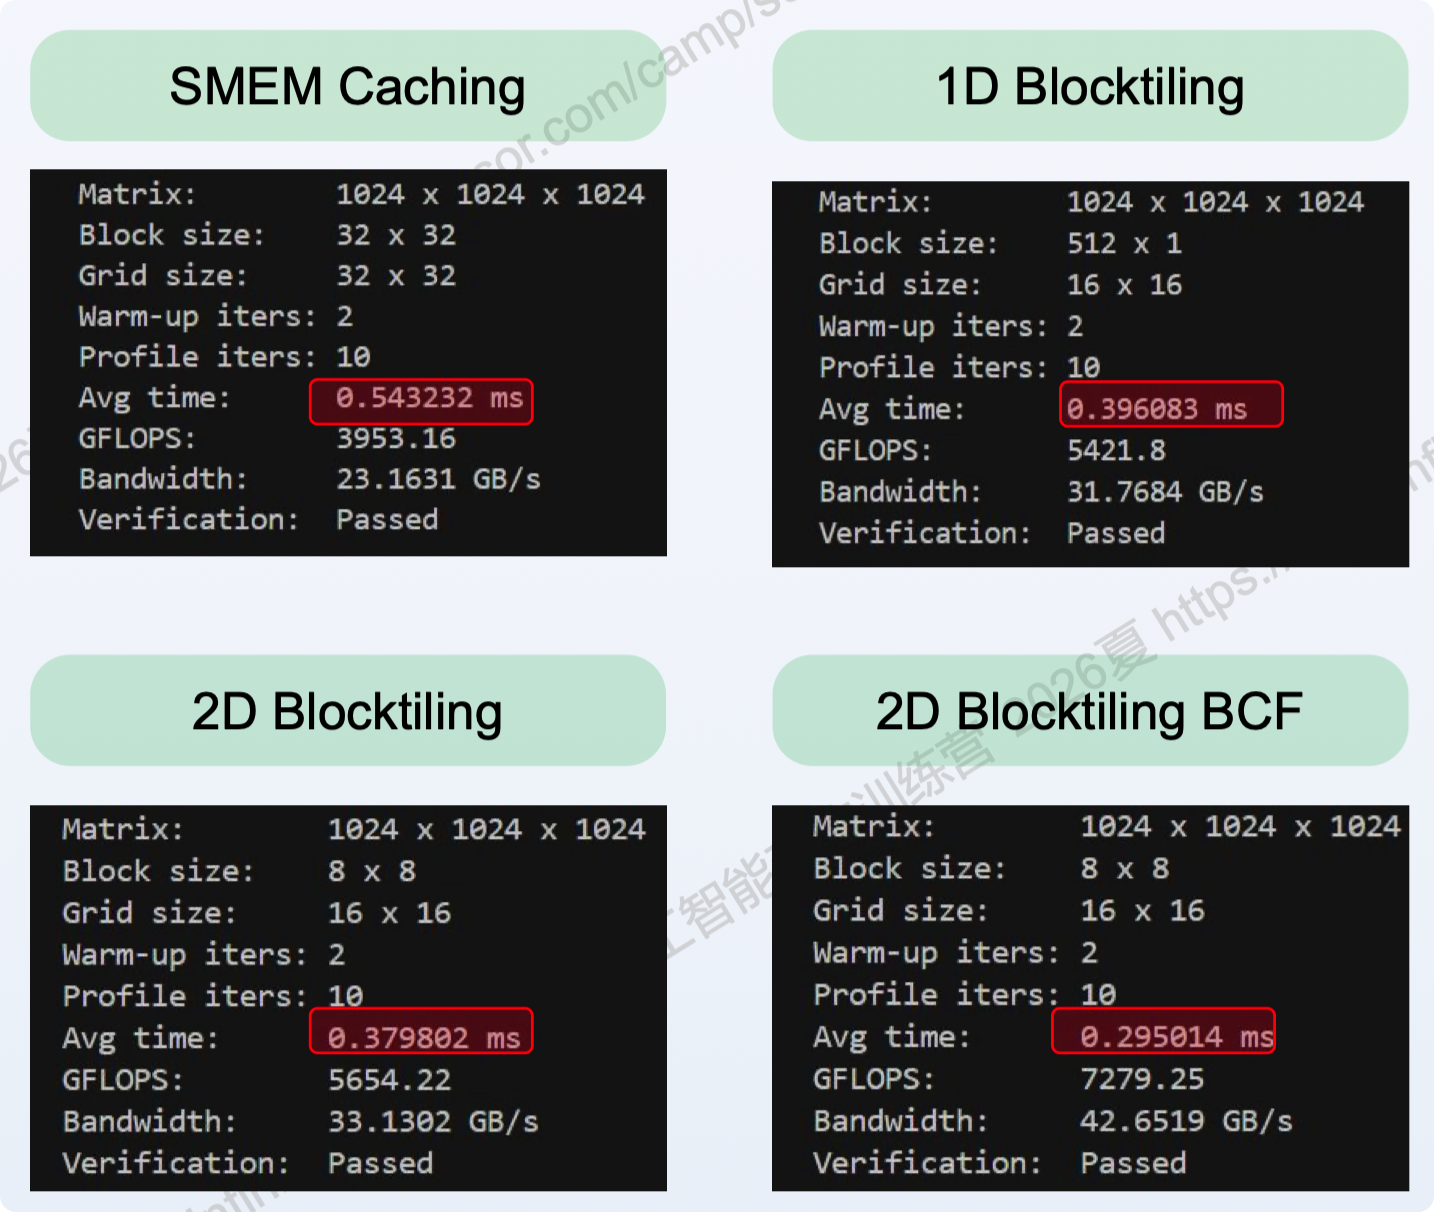
1D Blocktiling
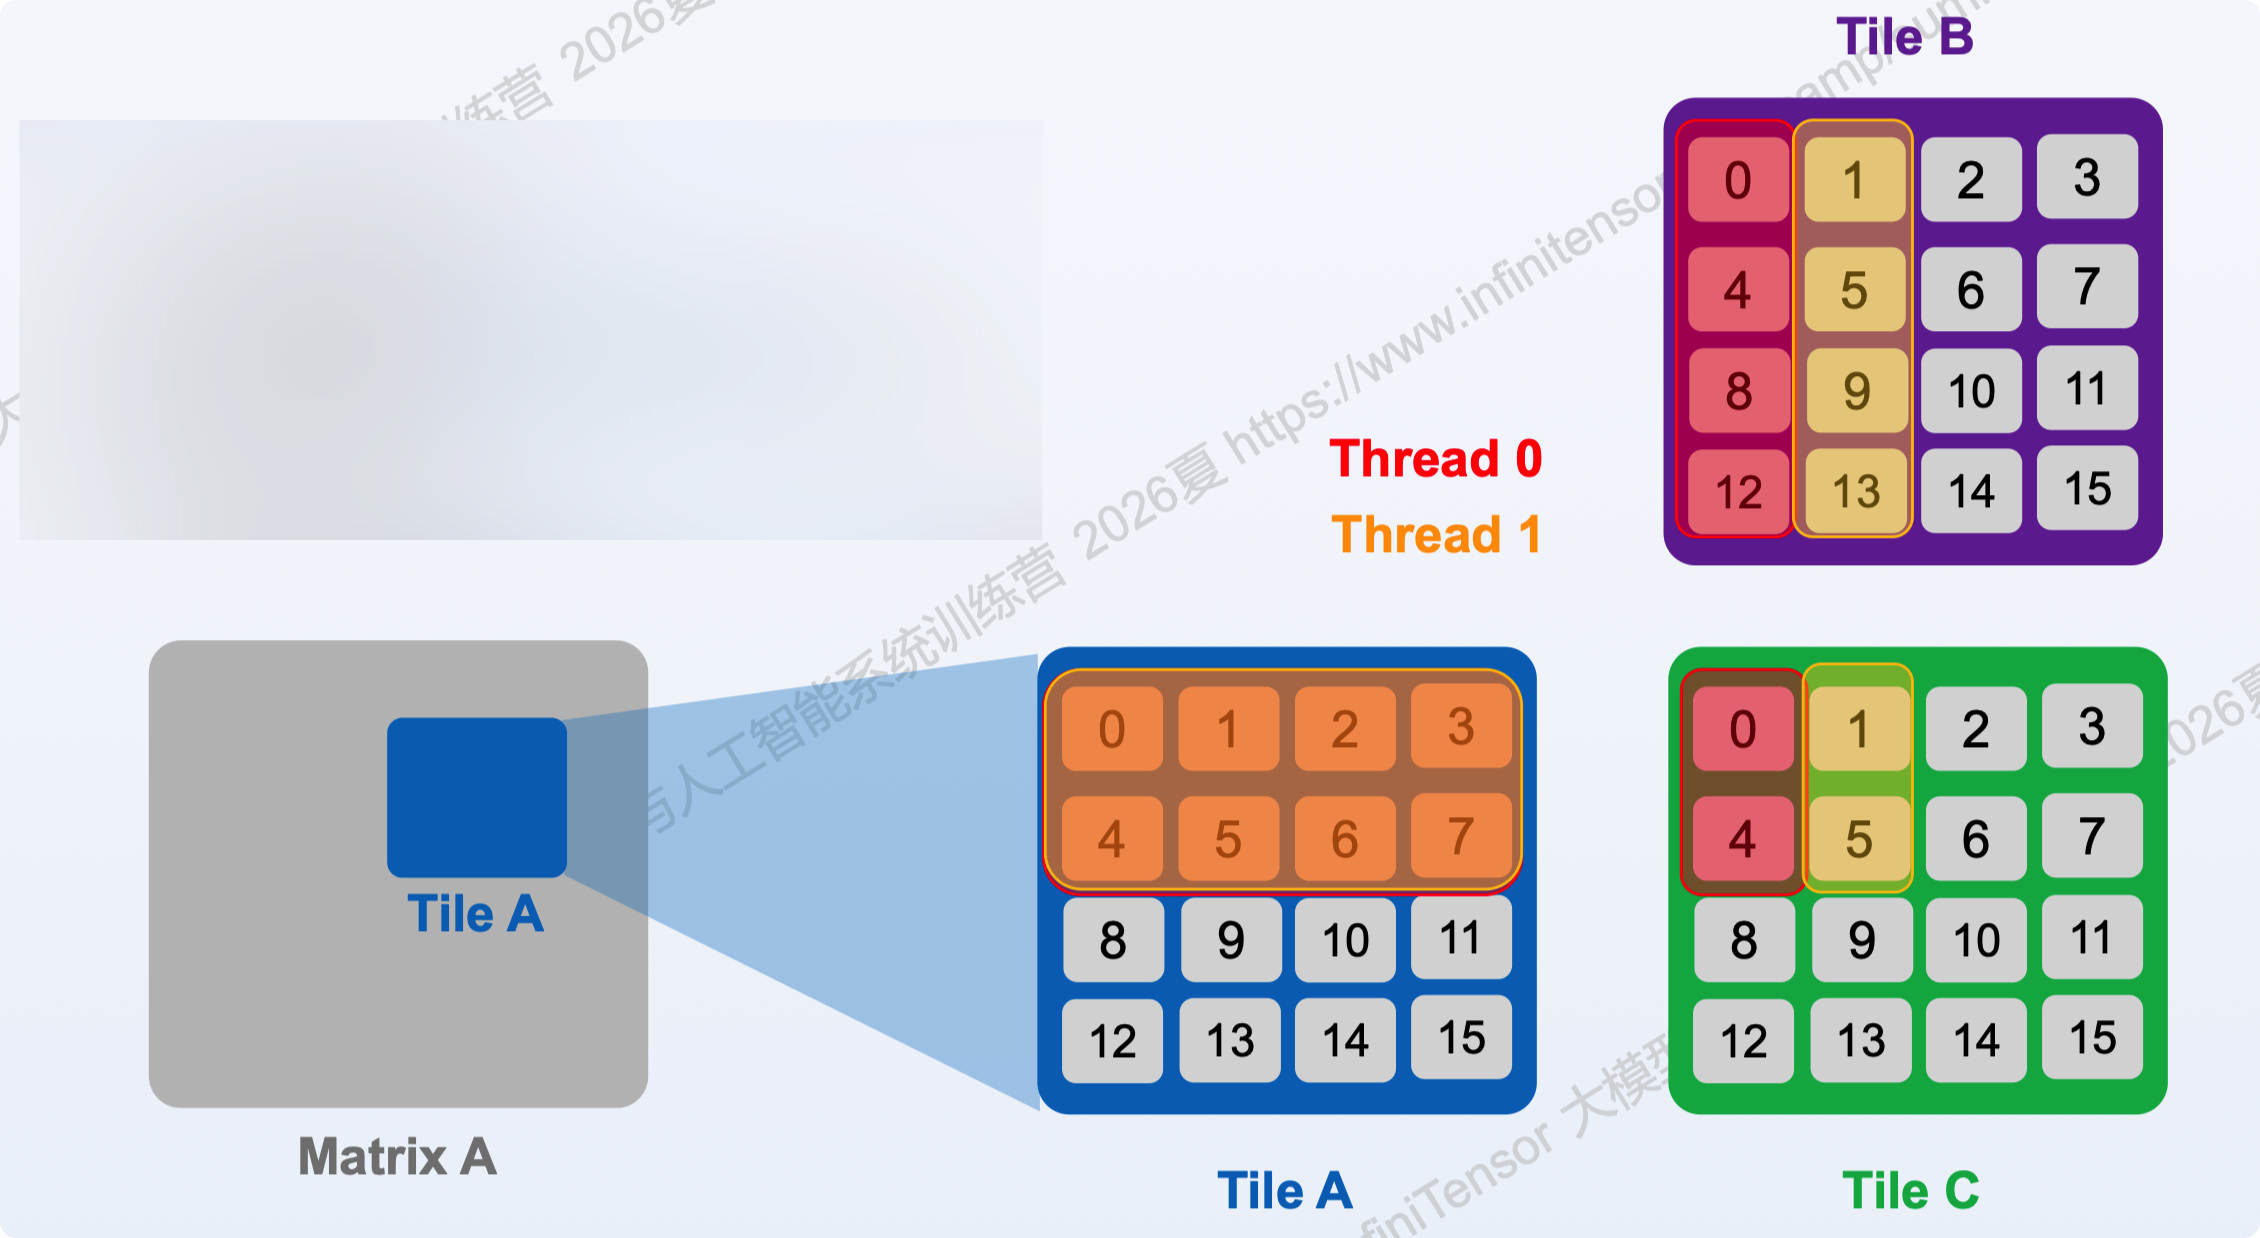
每个线程处理多个同列的 entries → 拓展 M 方向
- 现在的 Thread 0(红色框)负责 Tile C 里同一列的 两个元素(
0和4),Thread 1(黄色框)负责1和5 - 为了计算
0和4,Thread 0 依然只需读Tile B的第一列(0, 4, 8, 12),但它需要读Tile A的第一行和第二行(0,1,2,3 和 4,5,6,7) Tile B读进来的一个数值bVal,可以在寄存器里复用,同时与Tile A的两个不同数值相乘,算出两个 C 的值。大大减少了读取共享内存的次数,缓解了 MIO 压力
// Per-thread accumulation buffer
float accum[THREAD_M] = {[0]=0.0f};

// Loop over tiles in K dimension
for (int kOffset = 0; kOffset < K; kOffset += TILE_K) {
    sharedA[loadRowA * TILE_K + loadColA] = tileA[loadRowA * K + loadColA];
    sharedB[loadRowB * TILE_N + loadColB] = tileB[loadRowB * N + loadColB];
    __syncthreads();

    for (int k = 0; k < TILE_K; ++k) {
        float bVal = sharedB[k * TILE_N + localCol];
        for (int i = 0; i < THREAD_M; ++i) {
            // 多了一个内部循环 (THREAD_M)
            int aRow = localRow * THREAD_M + i;
            float aVal = sharedA[aRow * TILE_K + k];
            accum[i] += aVal * bVal;
        }
    }
    __syncthreads();

    // Advance tiles
    tileA += TILE_K;
    tileB += TILE_K * N;
}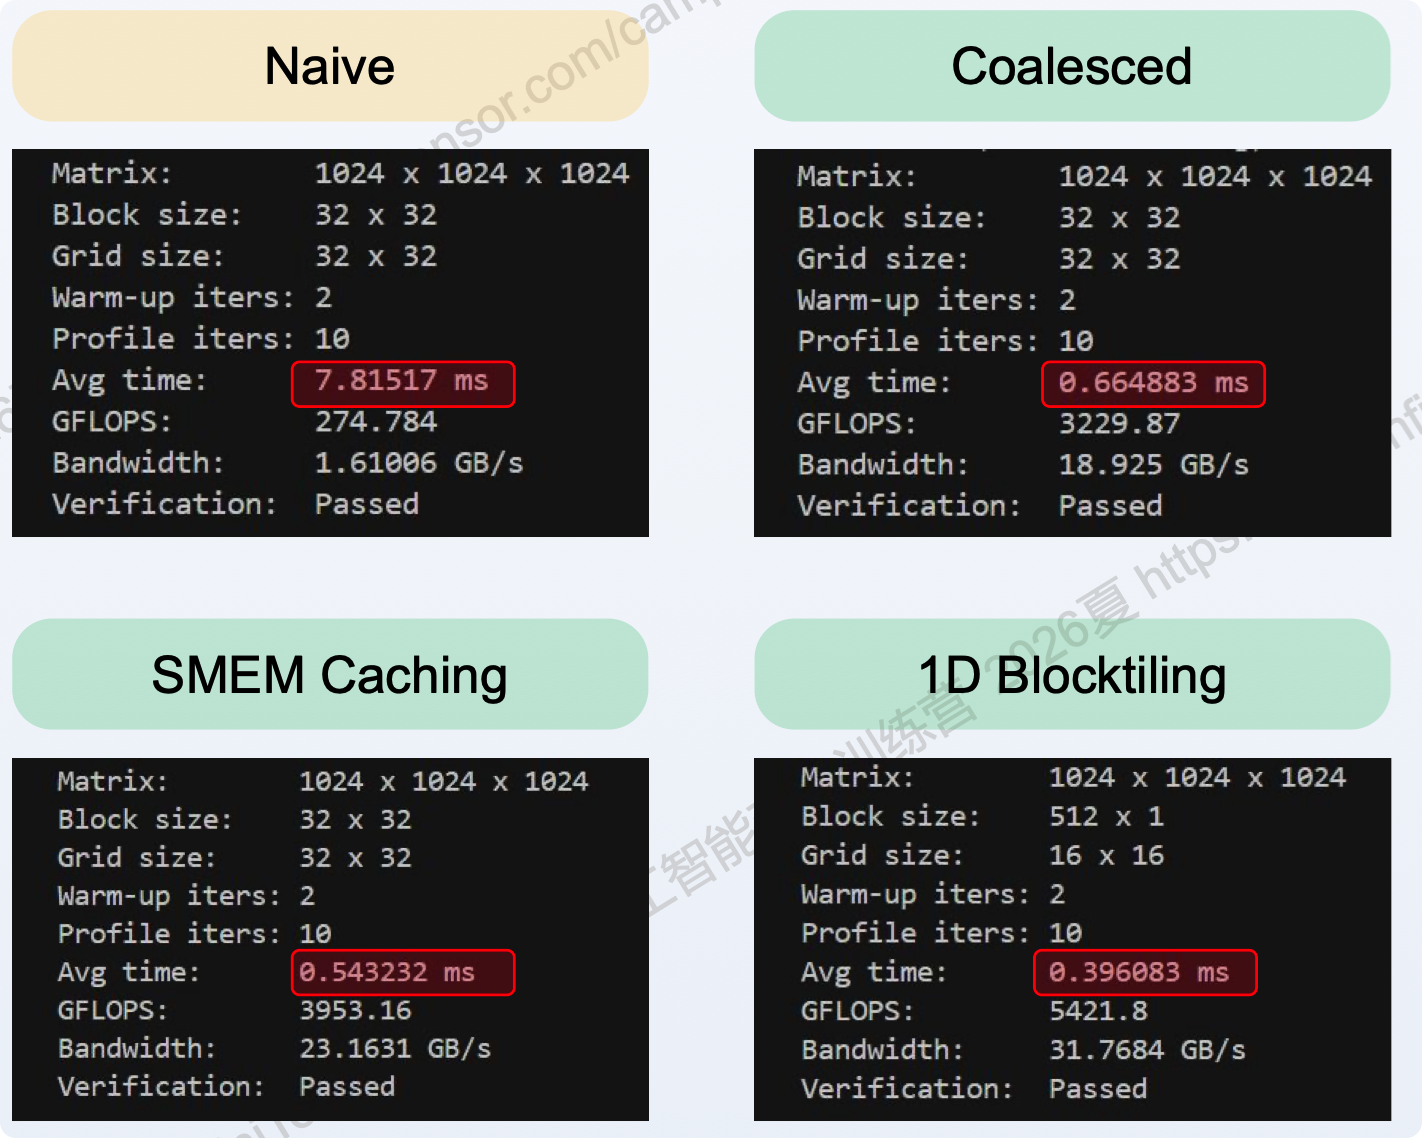
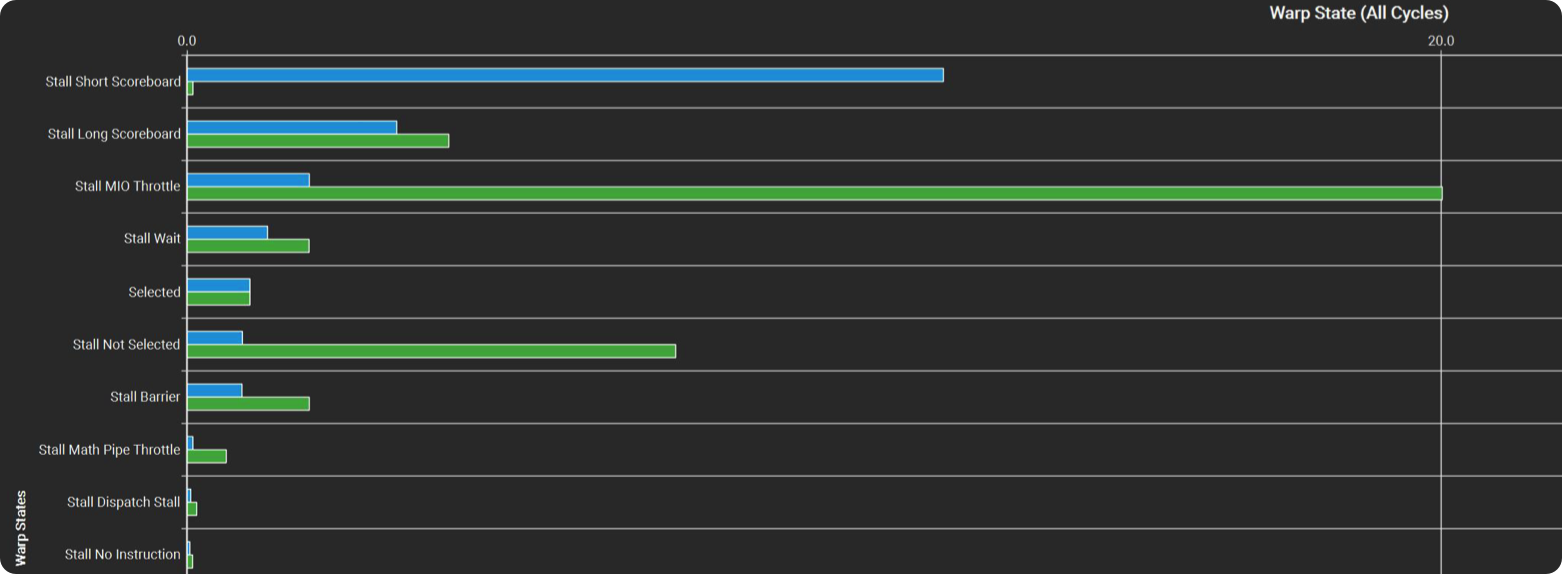
- Stall MIO Throttle 大幅减少,已不再是主要瓶颈
2D Blocktiling
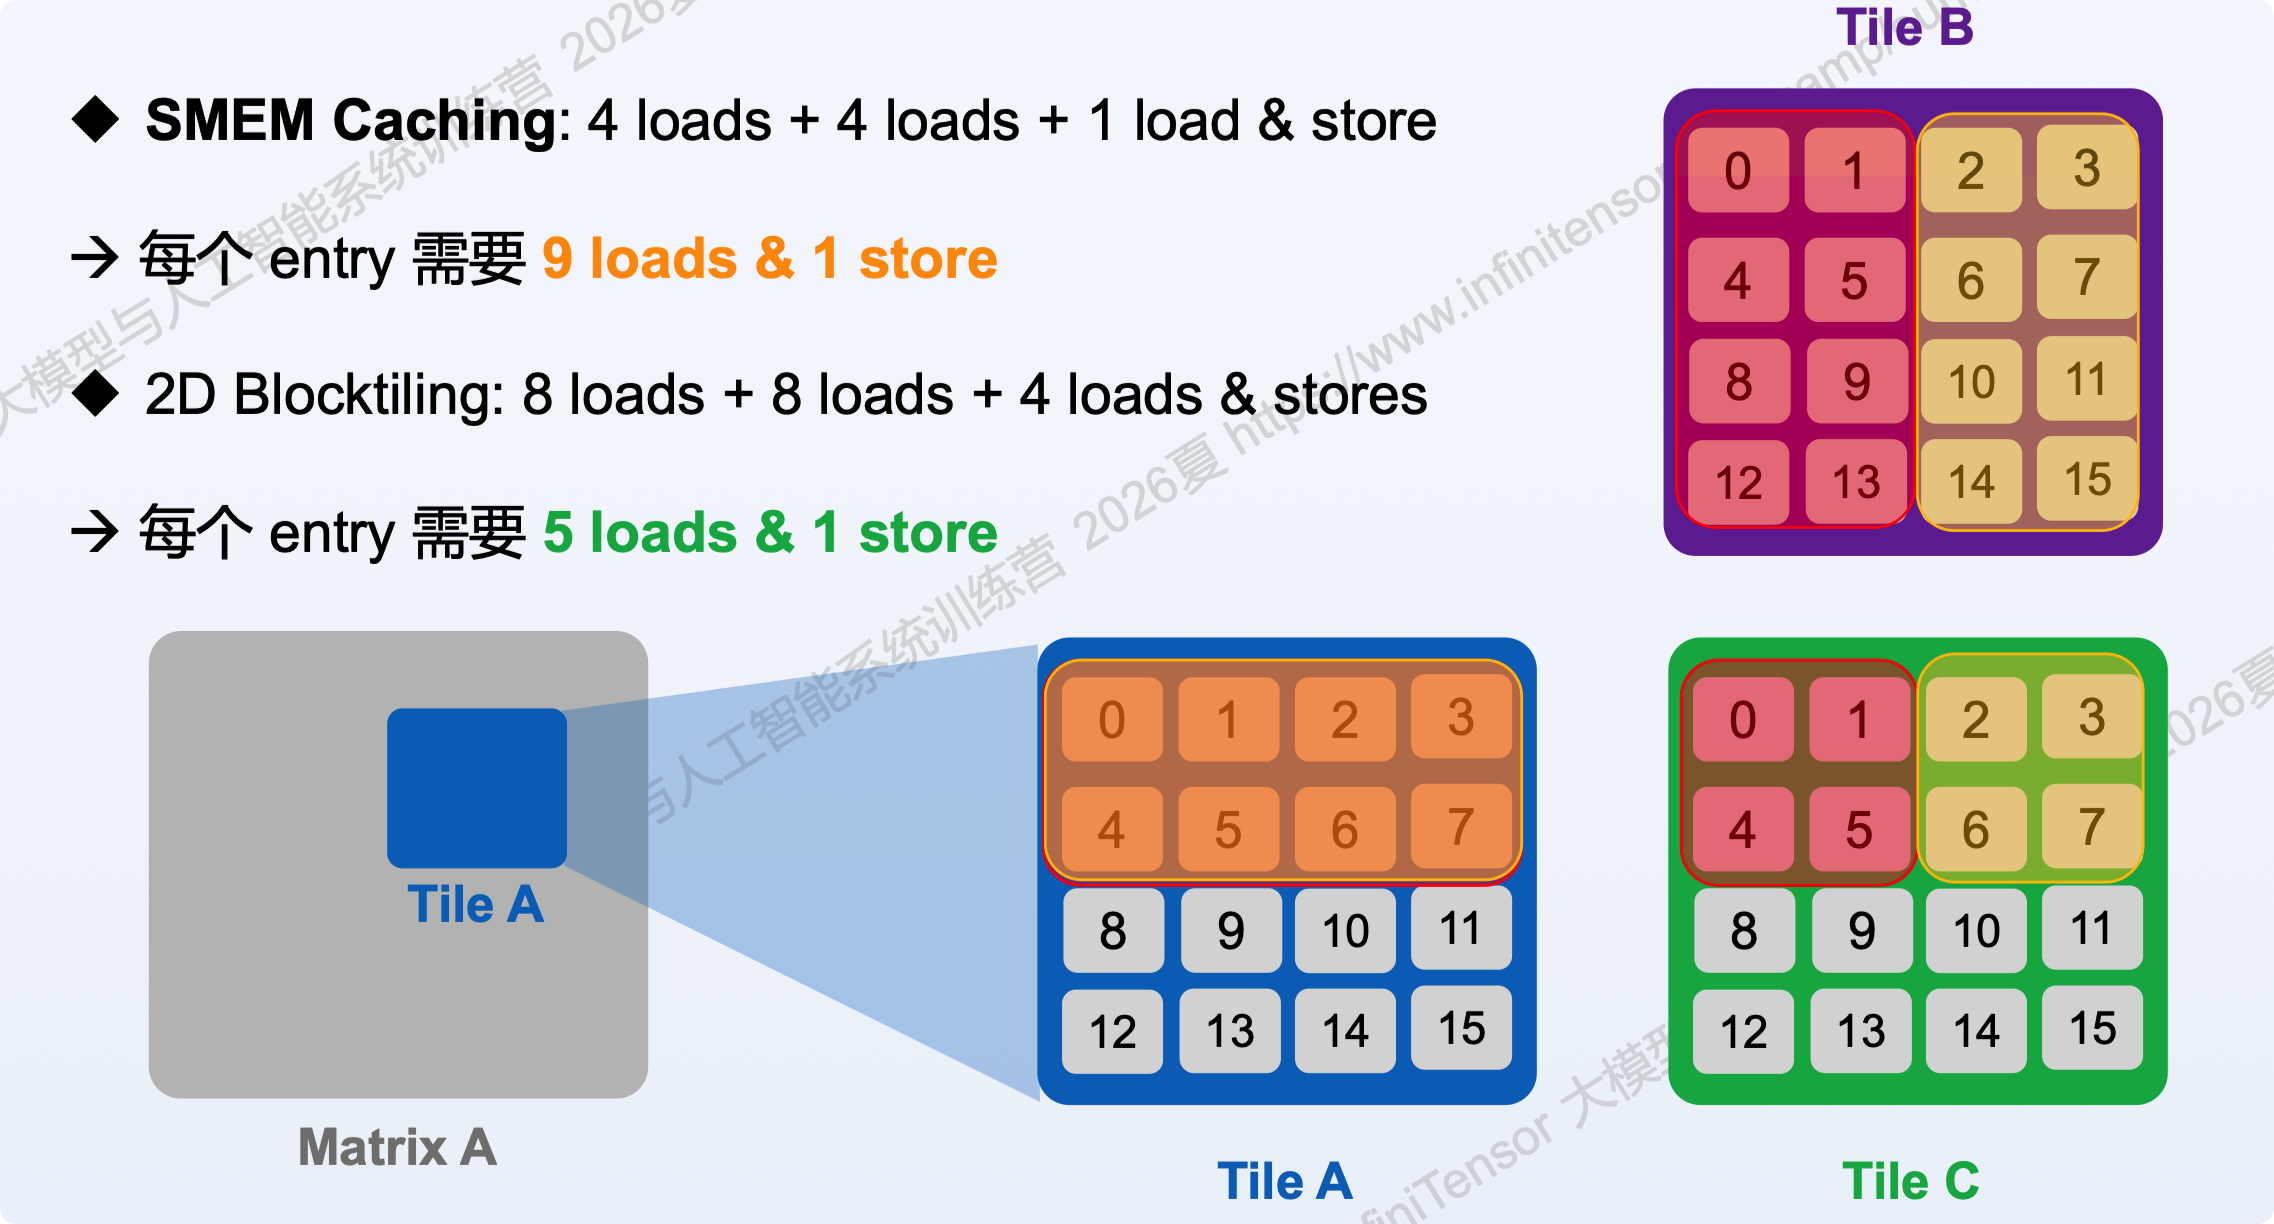
for (int k = 0; k < TILE_K; ++k) {
    // Load thread-specific row segment from Tile A
    float A_reg[THREAD_M];
    for (int i = 0; i < THREAD_M; ++i) {
        A_reg[i] = As[ty * THREAD_M + i][k];
    }

    // Load thread-specific column segment from Tile B
    float B_reg[THREAD_N];
    // 又多了一个内部循环 (THREAD_N)
    for (int j = 0; j < THREAD_N; ++j) {
        B_reg[j] = Bs[k][tx * THREAD_N + j];
    }

    // Outer product accumulation
    for (int i = 0; i < THREAD_M; ++i) {
        for (int j = 0; j < THREAD_N; ++j) {
            thread_accum[i][j] += A_reg[i] * B_reg[j];
        }
    }
}
__syncthreads();- SMEM Cache 累积一个 float;
- 1D Blocktiling 累积一个一维数组
- 2D Blocktiling 累积一个二维数组
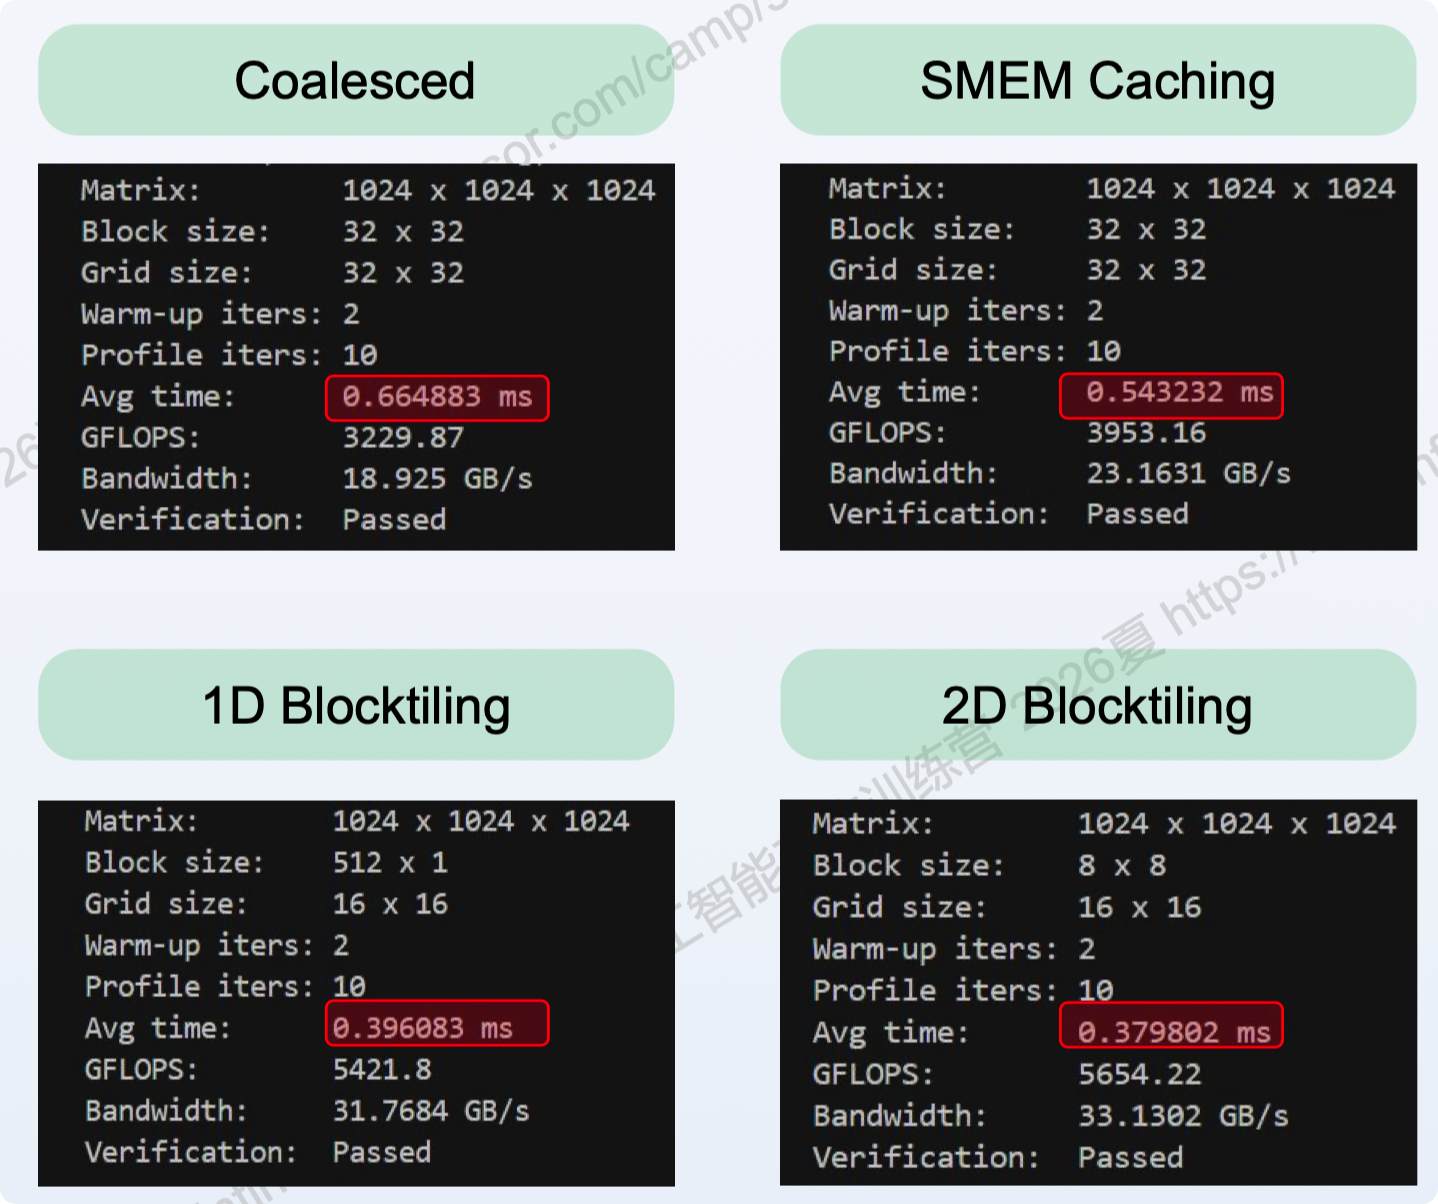
Bank Conflict
gemm_kernel1
__global__ void gemm_kernel1(float *C, const float *A, const float *B, int M, int N, int K) {
    int tx = threadIdx.x;
    int ty = threadIdx.y;
    int bx = blockIdx.x * BLOCK_SIZE;
    int by = blockIdx.y * BLOCK_SIZE;

    __shared__ float As[BLOCK_SIZE][BLOCK_SIZE];
    __shared__ float Bs[BLOCK_SIZE][BLOCK_SIZE];

    float sum = 0.0f;

    for (int k = 0; k < K; k += BLOCK_SIZE) {
        As[ty][tx] = (by + ty < M && k + tx < K) ? A[(by + ty) * K + (k + tx)] : 0.0f;
        Bs[ty][tx] = (k + ty < K && bx + tx < N) ? B[(k + ty) * N + (bx + tx)] : 0.0f;

        __syncthreads();

        for (int i = 0; i < BLOCK_SIZE; ++i) {
            sum += As[tx][i] * Bs[i][ty];
        }

        __syncthreads();
    }

    if (by + ty < M && bx + tx < N) {
        C[(by + tx) * N + (bx + ty)] = sum;
    }
}As[tx][i]:在一个 Warp 中,tx 从 0 变到 31(i 是固定常数)因为 BLOCK_SIZE = 32,As[tx][i] 的物理地址是 tx * 32 + i。由于 32 % 32 = 0,所有线程的地址余数都是 i。这意味着32个线程全都去抢同一个 Bank,发生 32 路冲突
gemm_kernel2(算法/访存模式优化)
__global__ void gemm_kernel2(float *C, const float *A, const float *B, int M, int N, int K) {
    int tx = threadIdx.x;
    int ty = threadIdx.y;
    int bx = blockIdx.x * BLOCK_SIZE;
    int by = blockIdx.y * BLOCK_SIZE;

    __shared__ float As[BLOCK_SIZE][BLOCK_SIZE];
    __shared__ float Bs[BLOCK_SIZE][BLOCK_SIZE];

    float sum = 0.0f;

    for (int k = 0; k < K; k += BLOCK_SIZE) {
        As[ty][tx] = (by + ty < M && k + tx < K) ? A[(by + ty) * K + (k + tx)] : 0.0f;
        Bs[ty][tx] = (k + ty < K && bx + tx < N) ? B[(k + ty) * N + (bx + tx)] : 0.0f;

        __syncthreads();

        for (int i = 0; i < BLOCK_SIZE; ++i) {
            sum += As[ty][i] * Bs[i][tx]; // 修改了读取索引
        }

        __syncthreads();
    }

    if (by + ty < M && bx + tx < N) {
        C[(by + tx) * N + (bx + ty)] = sum;
    }
}As[ty][i]:ty在 Warp 里是固定的,i也是固定的,所以这个 Warp 里所有线程访问的是同一个地址,GPU 硬件触发广播(Broadcast)无冲突Bs[i][tx]:i固定,tx从 0 变到 31。地址是i * 32 + tx。Bank 为(i*32 + tx) % 32 = tx。每个线程刚好访问不同的 Bank,完美合并
gemm_kernel3:内存填充 Padding
__global__ void gemm_kernel3(float *C, const float *A, const float *B, int M, int N, int K) {
    int tx = threadIdx.x;
    int ty = threadIdx.y;
    int bx = blockIdx.x * BLOCK_SIZE;
    int by = blockIdx.y * BLOCK_SIZE;

    __shared__ float As[BLOCK_SIZE][BLOCK_SIZE + 1]; // 核心变化:加了1列 Padding
    __shared__ float Bs[BLOCK_SIZE][BLOCK_SIZE];

    float sum = 0.0f;

    for (int k = 0; k < K; k += BLOCK_SIZE) {
        As[ty][tx] = (by + ty < M && k + tx < K) ? A[(by + ty) * K + (k + tx)] : 0.0f;
        Bs[ty][tx] = (k + ty < K && bx + tx < N) ? B[(k + ty) * N + (bx + tx)] : 0.0f;

        __syncthreads();

        for (int i = 0; i < BLOCK_SIZE; ++i) {
            sum += As[tx][i] * Bs[i][ty]; // 索引恢复,靠 Padding 避免冲突
        }

        __syncthreads();
    }

    if (by + ty < M && bx + tx < N) {
        C[(by + tx) * N + (bx + ty)] = sum;
    }
}
As 的行宽变成了 33。此时 As[tx][i] 的地址是 tx * 33 + i。求余 Bank:(tx * 33 + i) % 32 = (tx + i) % 32。因为 tx 在每个线程各不相同,所以每个线程会落在不同的 Bank 上,完美错开。
gemm_kernel4(Swizzling 地址异或)
__global__ void gemm_kernel4(float *C, const float *A, const float *B, int M, int N, int K) {
    int tx = threadIdx.x;
    int ty = threadIdx.y;
    int bx = blockIdx.x * BLOCK_SIZE;
    int by = blockIdx.y * BLOCK_SIZE;

    __shared__ float As[BLOCK_SIZE][BLOCK_SIZE]; // 无 Padding
    __shared__ float Bs[BLOCK_SIZE][BLOCK_SIZE];

    float sum = 0.0f;

    for (int k = 0; k < K; k += BLOCK_SIZE) {
        // As 写入时进行异或散列
        As[ty][tx ^ ty] = (by + ty < M && k + tx < K) ? A[(by + ty) * K + (k + tx)] : 0.0f;
        Bs[ty][tx] = (k + ty < K && bx + tx < N) ? B[(k + ty) * N + (bx + tx)] : 0.0f;

        __syncthreads();

        for (int i = 0; i < BLOCK_SIZE; ++i) {
            // As 读取时根据异或反推真实位置
            sum += As[tx][i ^ tx] * Bs[i][ty];
        }

        __syncthreads();
    }

    if (by + ty < M && bx + tx < N) {
        C[(by + tx) * N + (bx + ty)] = sum;
    }
}
XOR Swizzling 地址异或
- XOR规则:相同为 0,不同为 1。多位二进制则按位独立计算
- 根据异或运算的自反性(
A ^ B ^ B = A),(col ^ row) ^ row = col
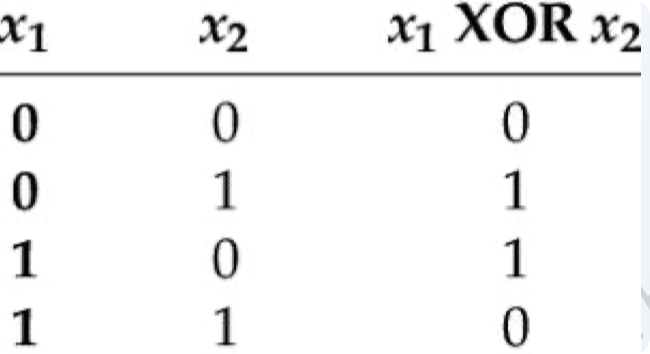
- XOR 运算在二进制集合上构成阿贝尔群
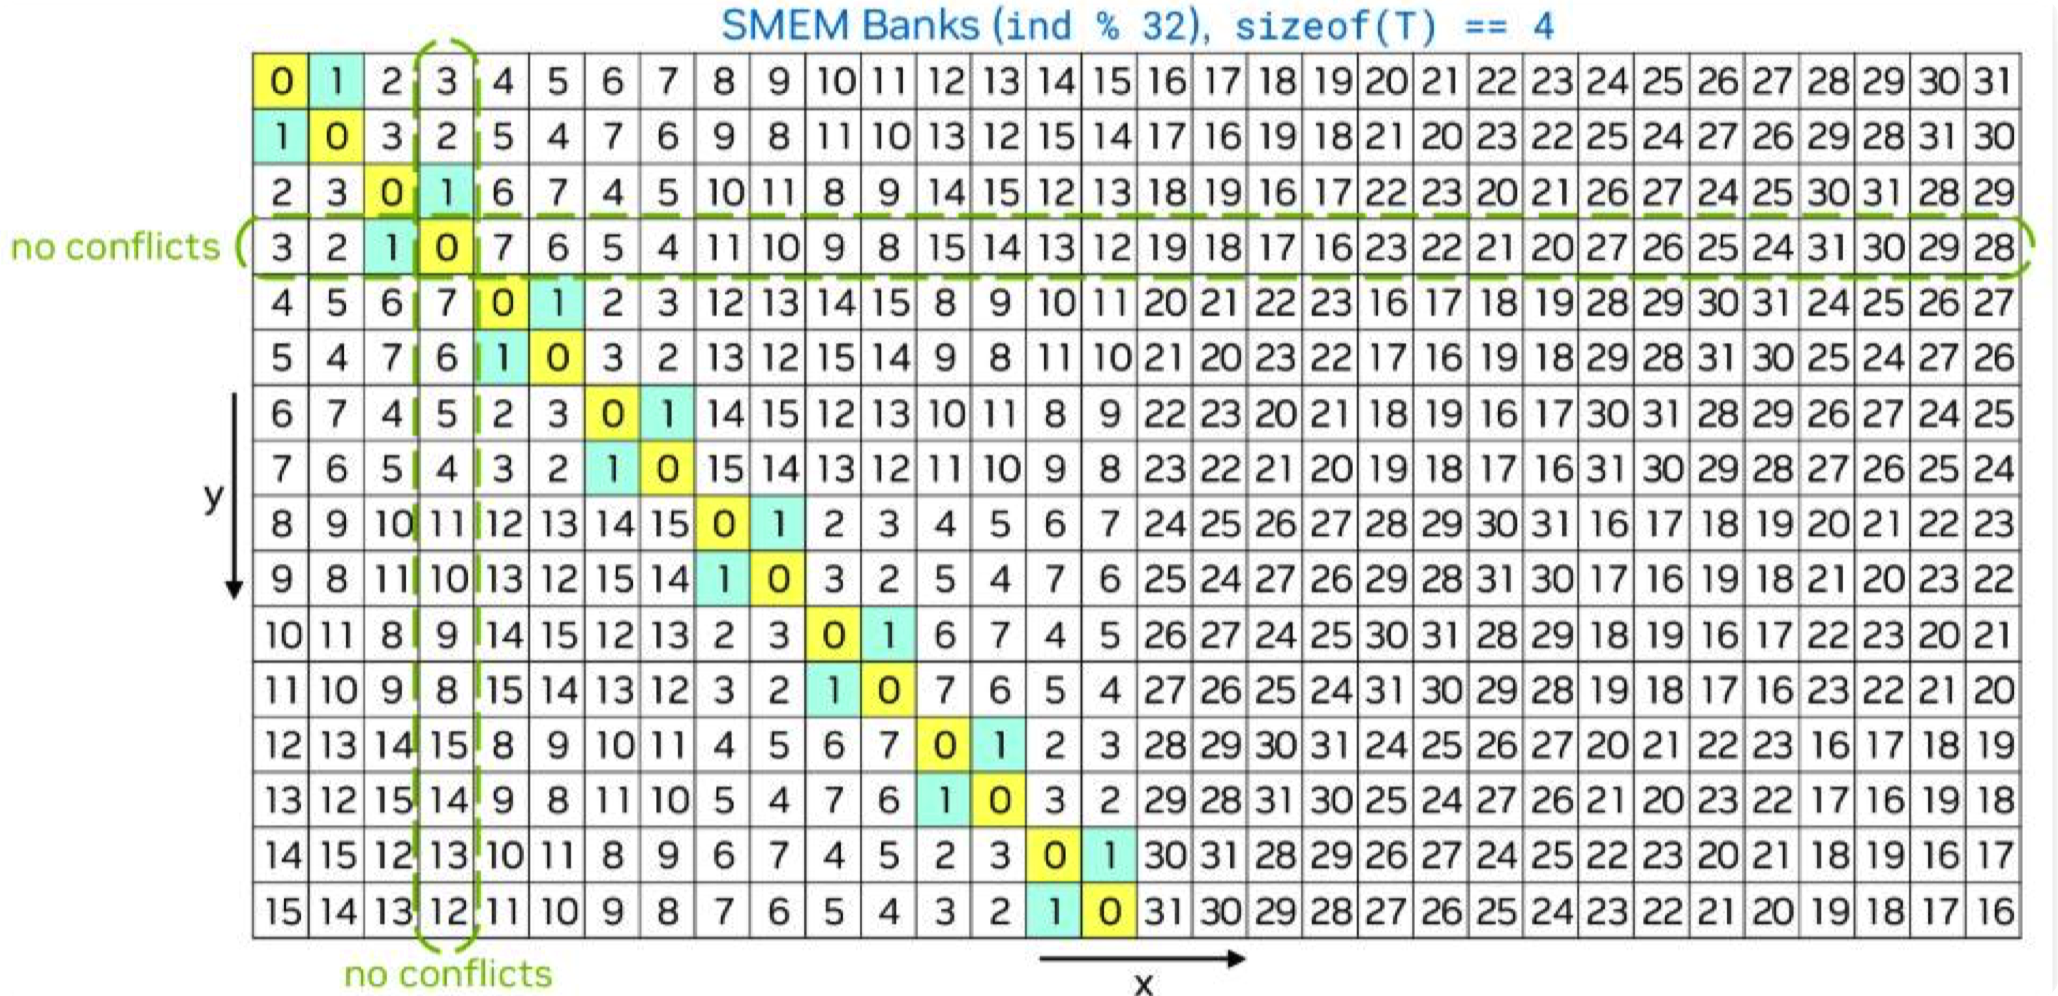
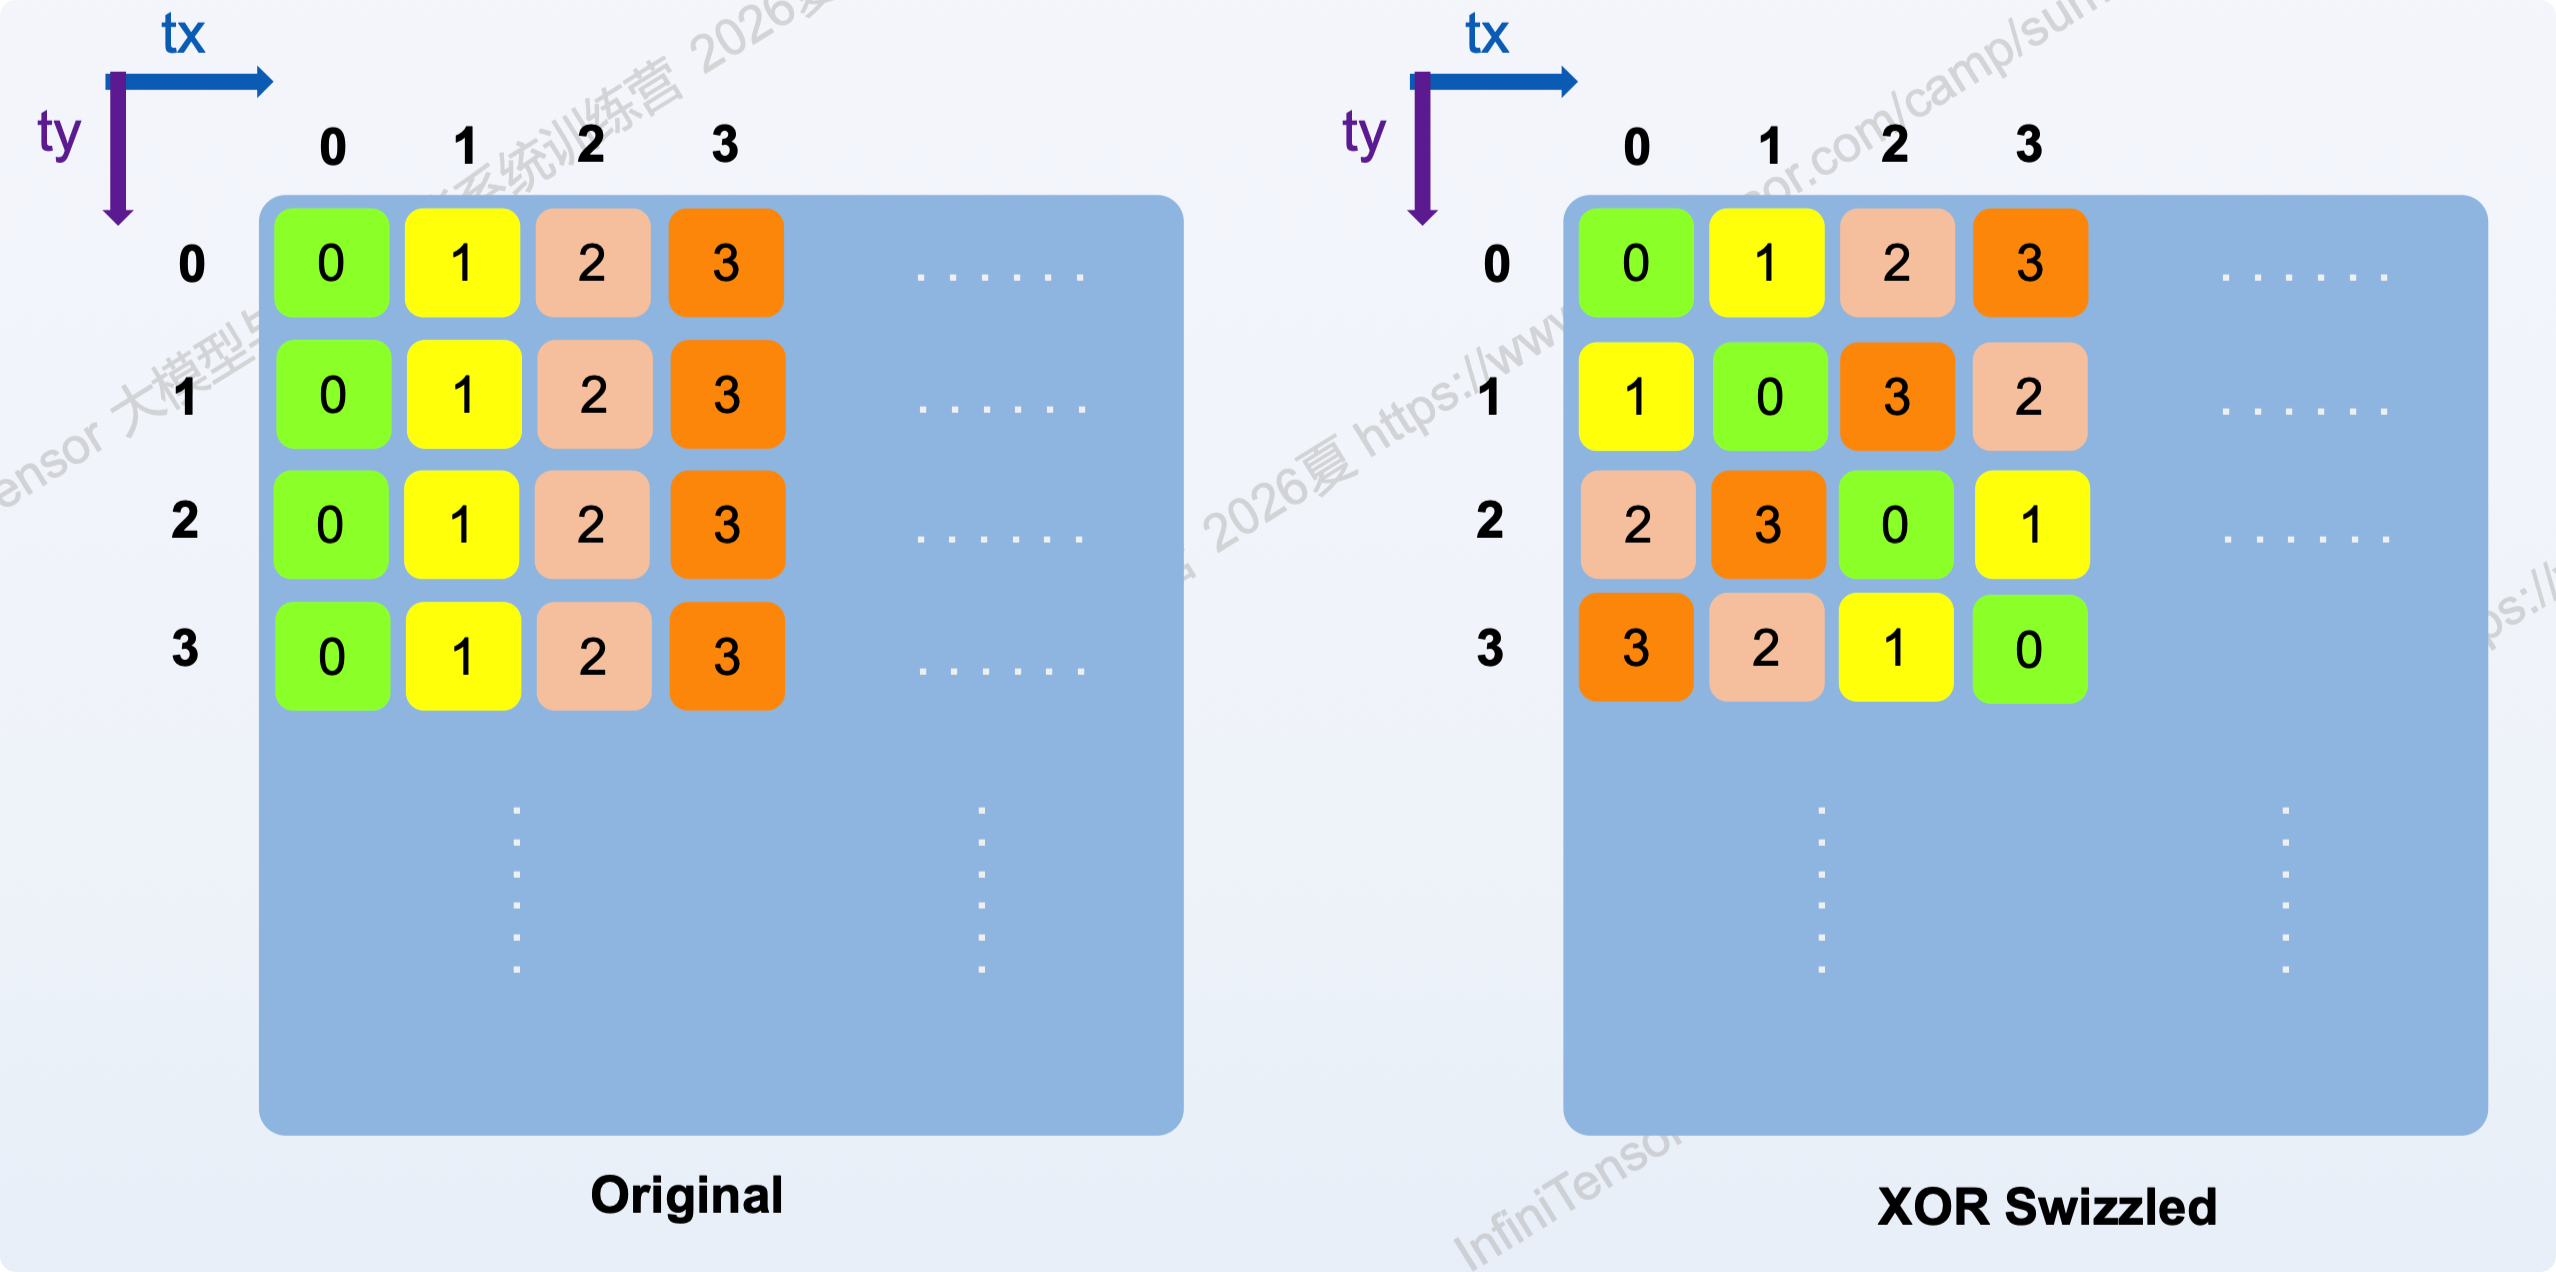
Transpose Swizzling:转置函数使用padding和swizzling的优化效果一致,并且还节省空间
Warptiling
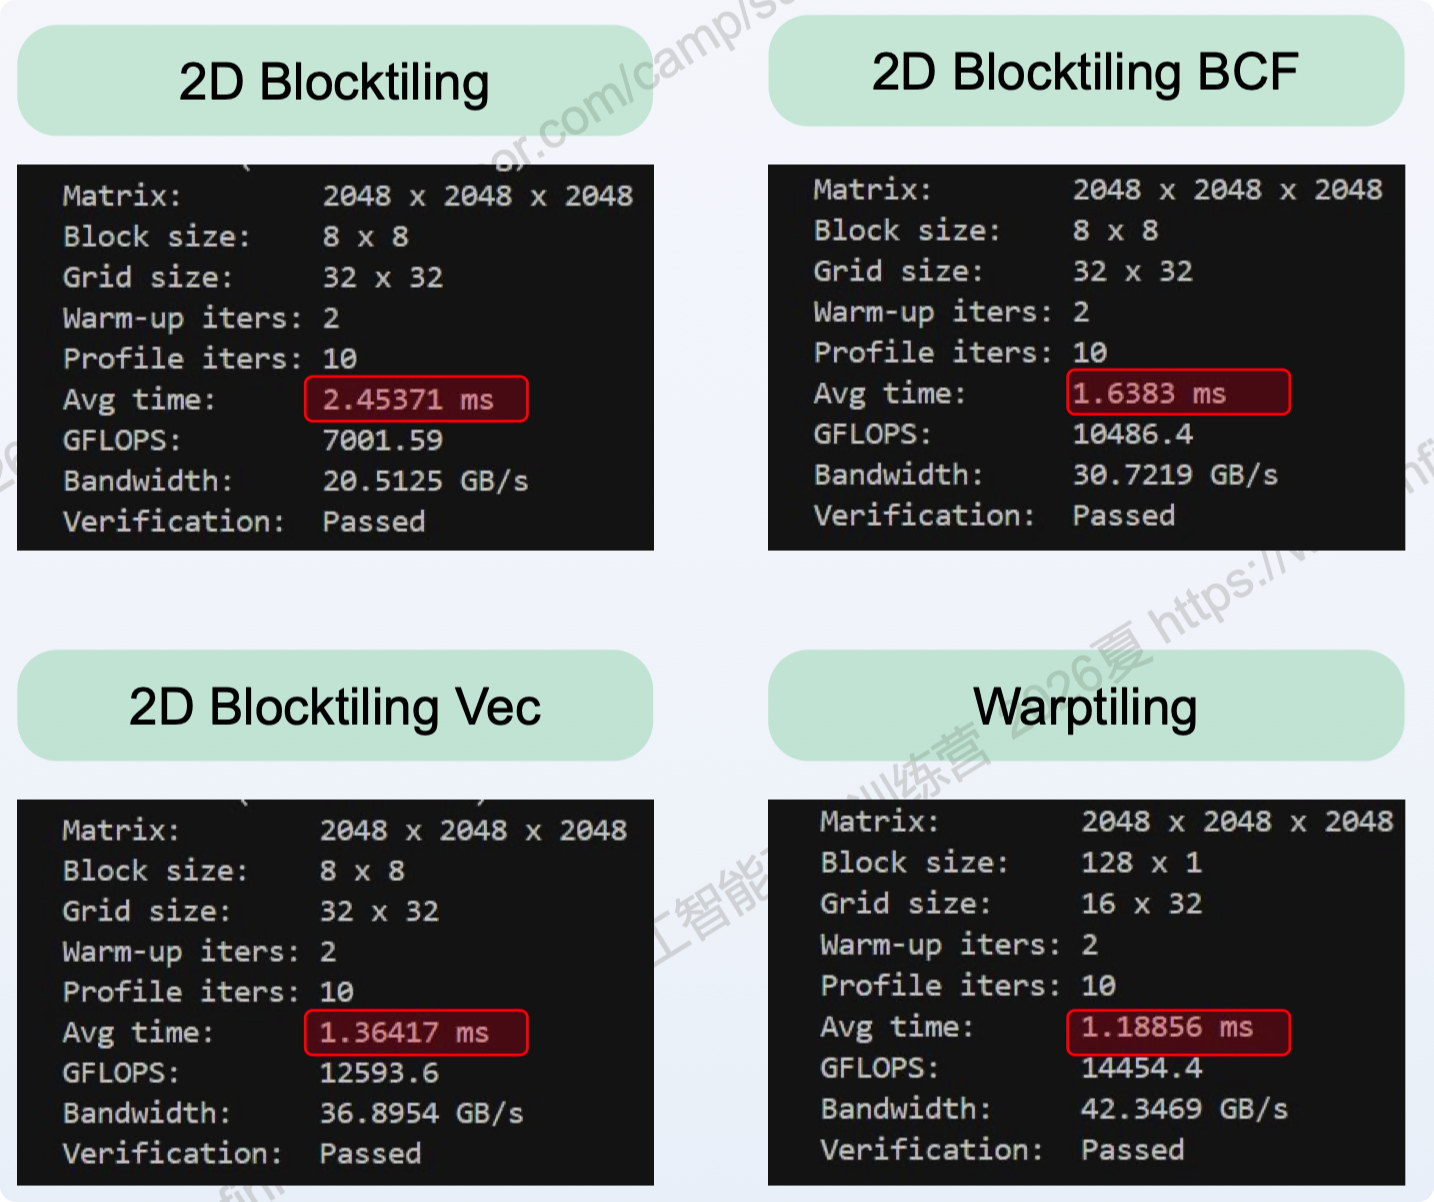
如何衡量现在优化的性能水平?——对比基准
cuBLAS
cuBLAS是英伟达开发的一个主要用于线性代数相关计算的加速库,cuBLAS 代表了在 NVIDIA GPU 上实现矩阵运算的性能上限,属于行业普遍标准,整体已优化的很不错
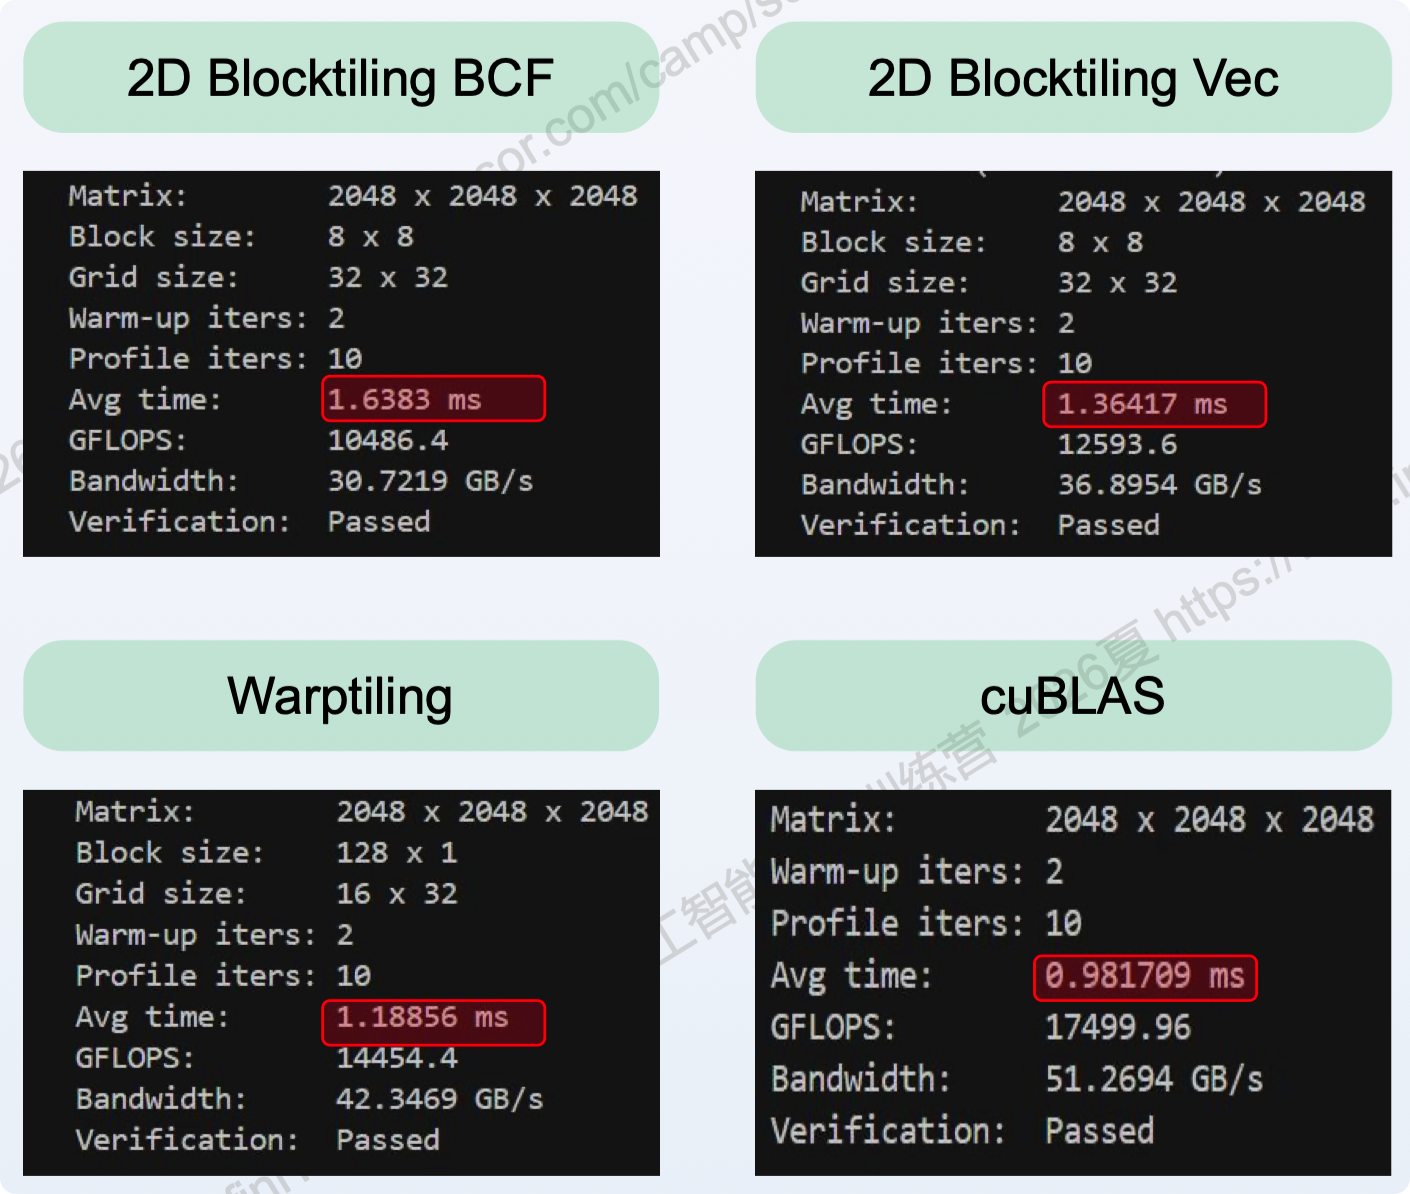

- 五个不同大小/形状,性能范围 0.53x 至 1.28x
- 五个数据点平均性能为 cuBLAS 的 ~70.8%
- 大部分达到 80%+
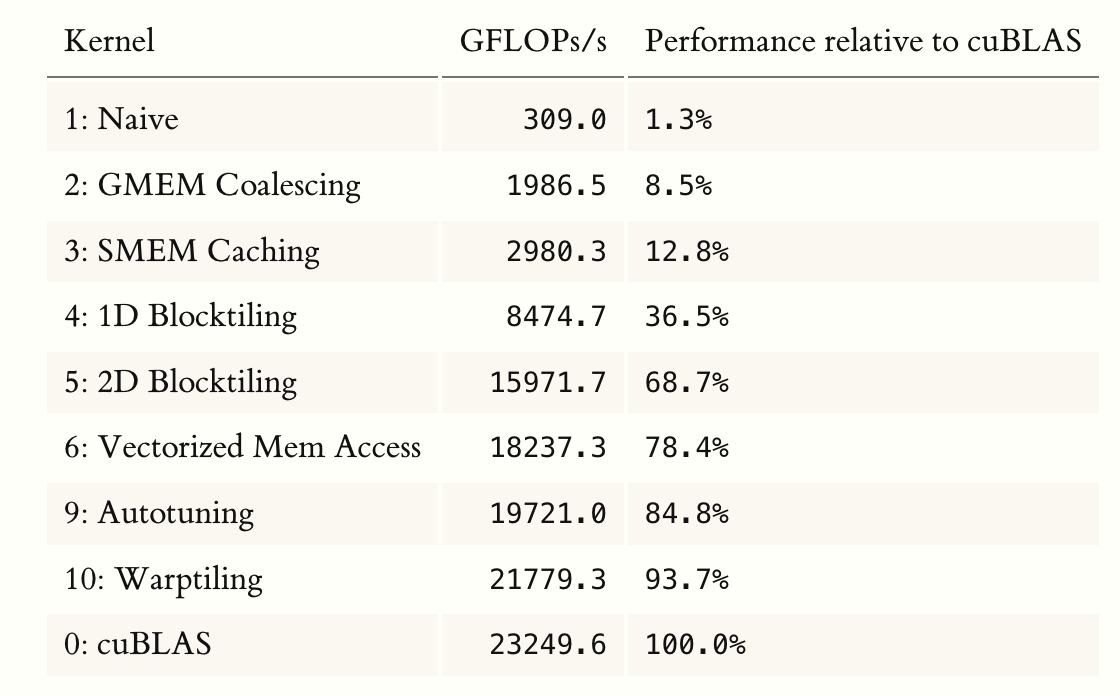
① Global Memory Coalescing
让同一个 warp 中的线程尽量读取连续地址
原来相邻线程可能读取 A 中相隔很远的位置,显存访问效率很差
改完后:
- 每个线程仍然做差不多的工作
- 但相邻线程读取的数据更连续
- GPU 可以把多个小读取合并成一次大读取
它主要改善的是:数据访问方式,并没有减少矩阵乘法的计算量
② Shared Memory Tiling
把 A 和 B 的一小块先搬到共享内存,再让一个线程块里的线程反复使用
- A 的某个元素会被多个输出位置使用
- B 的某个元素也会被多个输出位置使用
如果每次都从显存读取,就浪费了
共享内存相当于 GPU 上的一块小型高速缓存,可以让线程块复用数据
③ 一个线程计算多个结果
之前一个线程只计算一个 C 元素
后面改成一个线程计算多个元素,并把中间结果放在寄存器中
这样做的好处是:
- 减少共享内存读取
- 一个已经加载的数据可以被一个线程重复使用
- 更多计算发生在寄存器里
- 搬一次数据,可以完成更多计算
④ 2D Block Tiling
一个线程不再只沿着一列结果计算,而是计算一个小方块
这样可以同时复用:
- A 的同一行
- B 的同一列
- 共享内存中的数据
所以二维小方块比单独计算一列更划算
这也是为什么性能从大约:
- 1D tiling:8.5 TFLOPs
- 2D tiling:16 TFLOPs
⑤ Vectorized Memory Access
让一次加载操作搬运多个 float,而不是每次只搬一个
这减少了加载指令数量,提高了内存访问效率
⑥ Autotuning
不同的矩阵大小、线程数量、分块大小,最佳参数可能不同
作者让程序尝试多组参数,选择最快的一组
⑦ Warptiling
前面主要考虑:
- block 怎样分块
- thread 怎样计算
最后进一步考虑一个 warp 内的 32 个线程怎样协作
这样可以更好地利用:
- warp 调度器
- 寄存器
- 共享内存
- 指令级并行
最终已经达到 cuBLAS 性能的九成以上
Swizzling——高维映射
硬件物理内存本质是一维的,软件逻辑数据是多维的。在把逻辑数据简单映射到物理内存时,如果简单地按顺序展开,会引发灾难性的 Bank Conflict 和访存效率低下
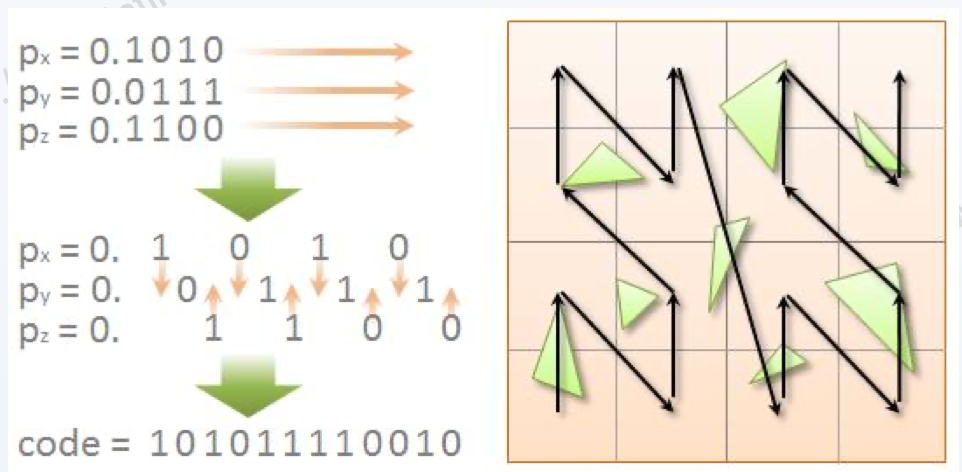
Z-Order Curve(Z序曲线)
Z-Order Curve:将高维数据映射至一维且能保证空间局部性(Spatial Locality)的空间填充曲线
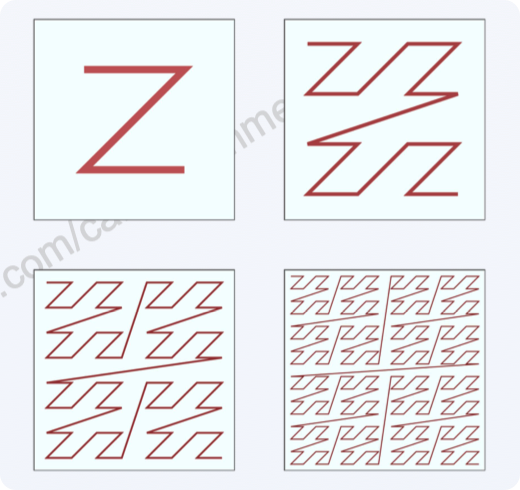
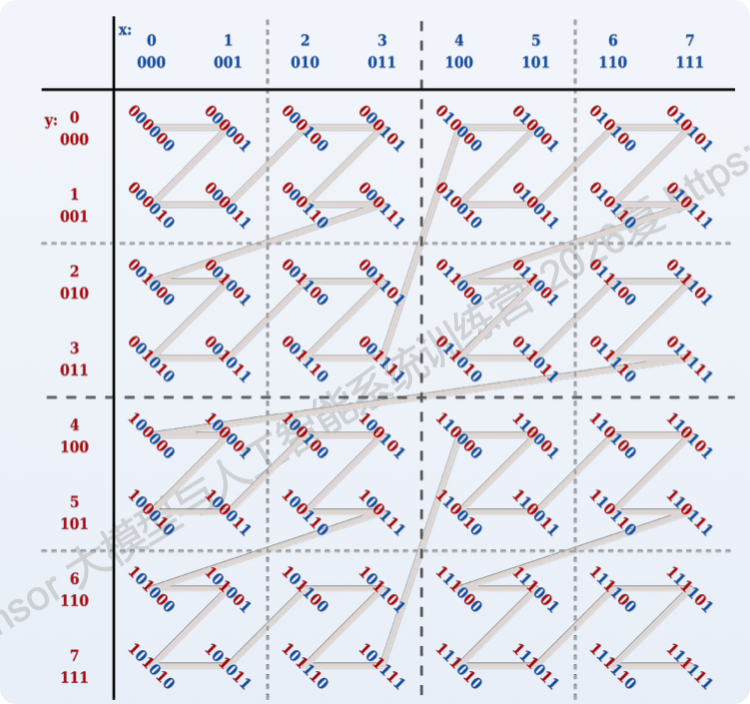
多维空间中相邻的点,在一维曲线上仍保持接近。它不再按行或按列机械地排列,而是像画“Z”字一样递归地将空间划分为4个象限,按照 Z 字形遍历
- 大幅提升缓存命中率(因为相邻节点在内存中也邻近)
- 计算简单,硬件友好(只需位运算)
- 广泛应用于空间数据库和计算机图形学
光线追踪(Ray Tracing)
模拟光线从相机出发,在虚拟场景中反向追踪,计算光线与物体的交互(反射、折射、阴影),生成极其逼真的图像
光线追踪是一种基于光线物理传播原理的高级渲染技术,其中的一项重要工作是计算光线与场景中物体的交点,一般都通过 BVH (Bounding Volume Hierarchy) 来加速
BVH (Bounding Volume Hierarchy) 将场景物体递归地组织成二叉树,每个节点存储一个包围子节点所有物体的包围盒(Bounding Box)
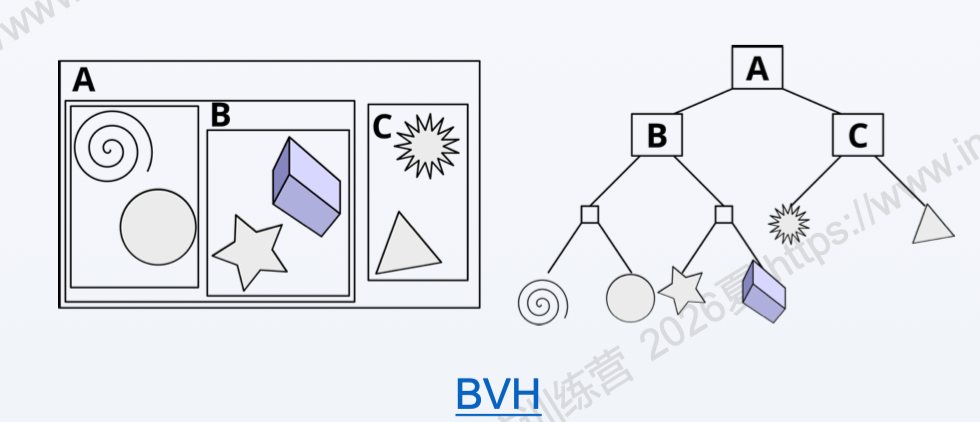
我们希望在 3D 空间中相邻的物体在 BVH 中也相邻,传统基于对比排序的 BVH 构建复杂度是 O(NlogN)
Z-order curve
使用 Z-Order 的 BVH 算法称为 LBVH (Linear Bounding Volume Hierarchy)
- 实现了线性时间构建,复杂度降至 O(N)
- 专为并行设计,非常适合在现代 GPU 等高并发硬件上执行
不规则访存
实际场景中常存在跨步访存(striding)等不规则访问模式,严重影响性能
- 充分利用 SMEM(共享内存) 和缓存进行数据复用
- 如果是访存模式或数据结构本身造成的,尝试改变访存模式
- 合并连续维度
不规则任务
当任务本身充满复杂性和动态性时,传统的 Swizzling 和静态分块等静态优化方法无法保证有效
动态并行:允许 GPU 内核在不经过 CPU 干预的情况下,直接在设备端启动和管理新的子内核
-
可以将处理逻辑写进 GPU 核函数中,动态进行资源分配和处理,完美适应动态和复杂的任务。
-
三种并行模式:
- 批量并行 (bulk):最简单,无依赖关系,无需动态并行
- 嵌套并行 (hierarchical):需要使用动态并行来处理层级关系
- 任务并行 (task):任务独立,使用动态任务队列。主内核消费任务、进行负载探测,遇到子任务时启动子任务(类似于服务器请求处理模式)
COMMENTS
评论