性能模型与逐元素优化
性能瓶颈
H<—>D 耗时多 → CPU<—>GPU通信 → 传输带宽相较于算力更加是瓶颈
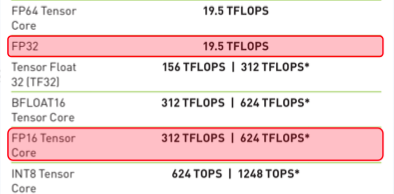
算力指标:TFLOPS(每秒万亿次浮点运算)或 TOPS(每秒万亿次整数运算)
带星号(*):代表稀疏计算,深度学习模型里有大量权重是0,稀疏计算支持跳过这些0不进行计算,理论上算力直接翻倍
GPU Memory显存:举个例子,一个70亿参数的模型(如Llama-7B),用FP16存储大概需要14GB显存。
GPU Memory Bandwidth显存带宽:决定每秒能搬运多少字节进入计算核心

内存墙
- 冯诺伊曼架构:数据必须在处理器和内存之间频繁传输
- 当数据量大或者计算密度低->内存瓶颈
- 算力增速比内存快:计算芯片(晶体管)主要是靠缩小尺寸来提升速度的。我们的工程师可以把晶体管做得越来越小,开关速度越来越快;但是内存芯片(DRAM)是一个电容,需要不断地充电放电来存储数据。电容的物理特性决定了它不能无限缩小,充放电的速度也有物理极限
- 处理器计算速度远快于内存访问速度

量化性能瓶颈
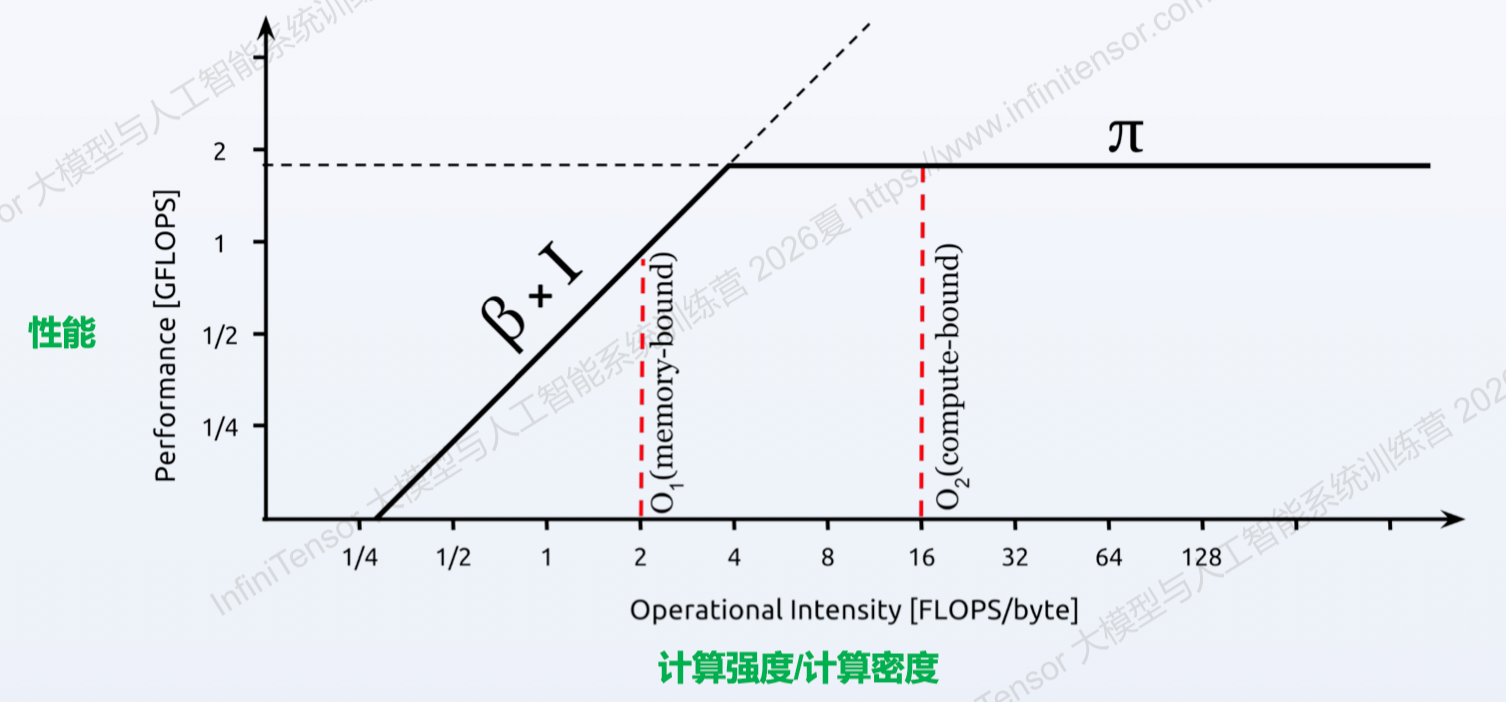
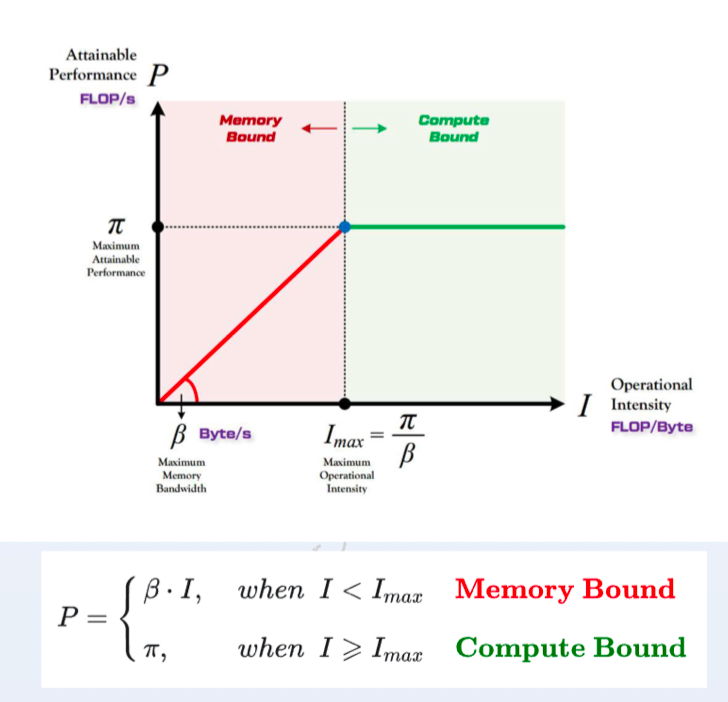
Roofline模型
拐点(ridge point):可达到该硬件理论最高性能的最低计算强度
memory-bound:拐点以左,访存密集型,瓶颈在访存
compute-bound:拐点以右,计算密集型,瓶颈在计算
Float 加法:
A100:
访存密集型算子占大多数,由于内存墙的限制和现在深度学习等领域所需数据量大
Nsight Compute
Nsight Compute (ncu) :英伟达的内核级性能分析工具
(Nsight System :英伟达的系统级性能分析工具)
使用 ncu CLI :ncu --print-details all --nvtvx --call-stack --set full ./add_cuda
导出文件并使用 ncu GUI:sudo ${ncu} --nvtvx --call-stack --set full -f --export add_cuda.ncu-rep ./add_cuda
Details → GPU Speed Of Light Throughput:可以查看roofline分析
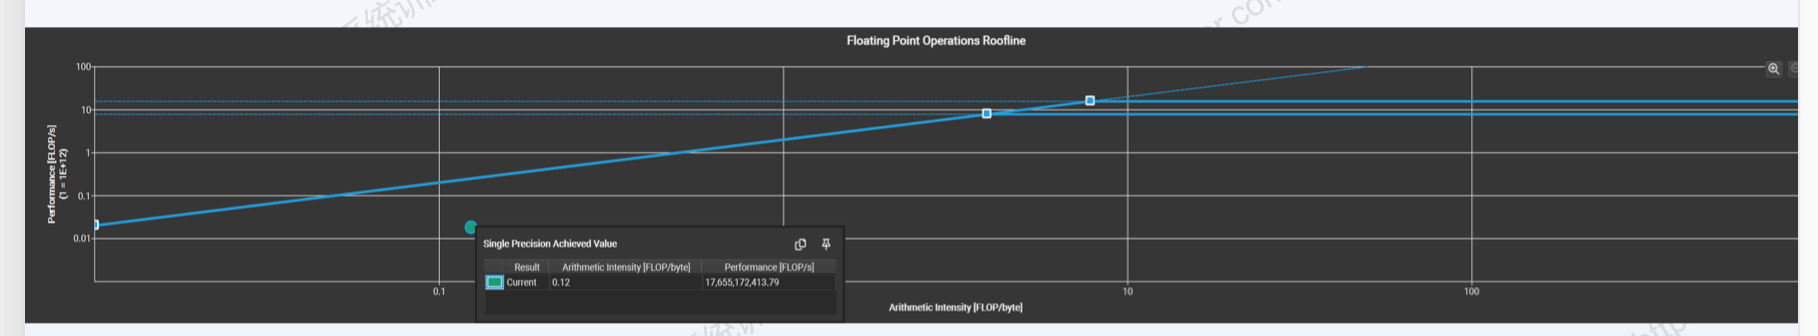
加法的性能瓶颈在内存访问上,因此提升其访存效率
向量化
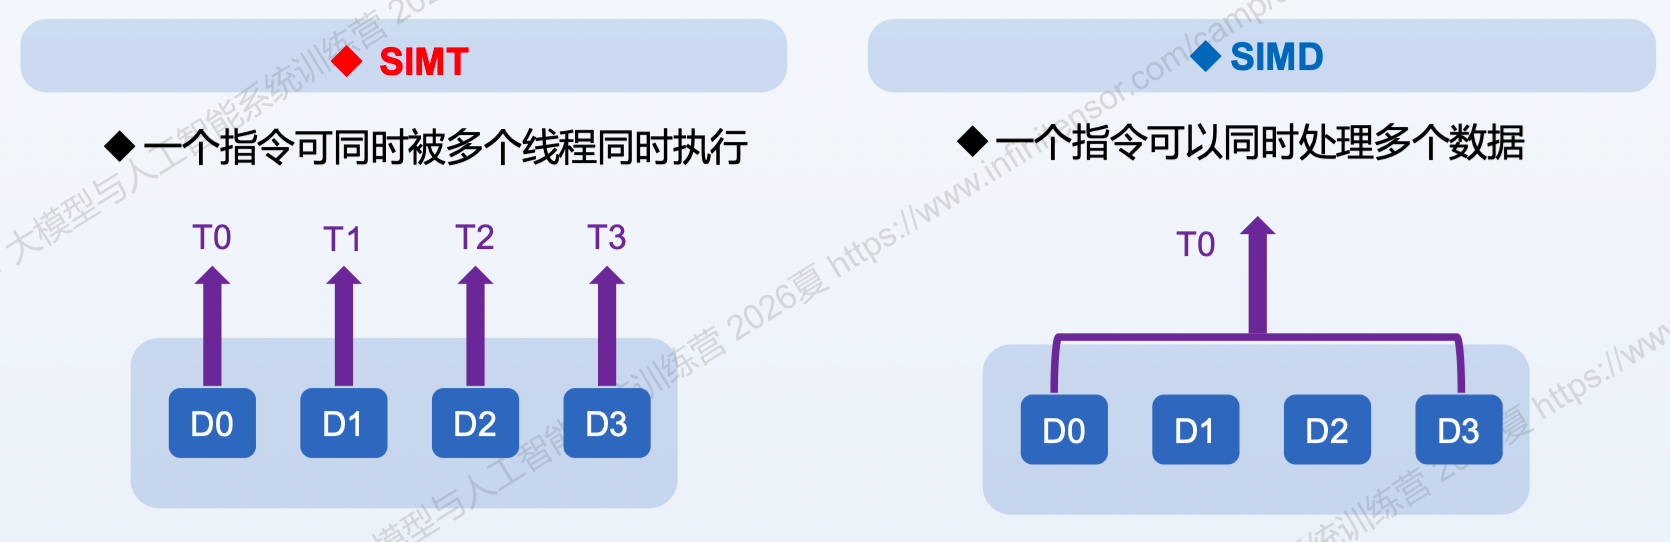
向量化(vectorization):一次同时操作多个标量数据
一次多传输数据:向量化访存,即一次同时传输(读写)多个标量数据→ 提升访存效率
向量化本质是 SIMD (Single Instruction Multiple Data)
SIMD: 同时对一组 (向量) 数据中的每一个分别执行相同的操作从而实现空间上的并行
__device__: 表示这是个仅在 GPU 上运行的函数,CPU调用的是__global__
template <typename T>
__device__ T add(const T &a, const T &b)
template <typename T>
__global__ void add_kernel(T *c, const T *a, const T *b, size_t n, size_t step)
{
size_t idx = blockIdx.x * blockDim.x + threadIdx.x;
for (size_t i = idx; i < n; i += step)
{
c[i] = add(a[i], b[i]);
}
}
template <typename T>
void vector_add(T *c, const T *a, const T *b, size_t n, const dim3 &grid, const dim3 &block)
{
size_t step = grid.x * block.x;
add_kernel<T><<<grid, block>>>(c, a, b, n, step);
}
-
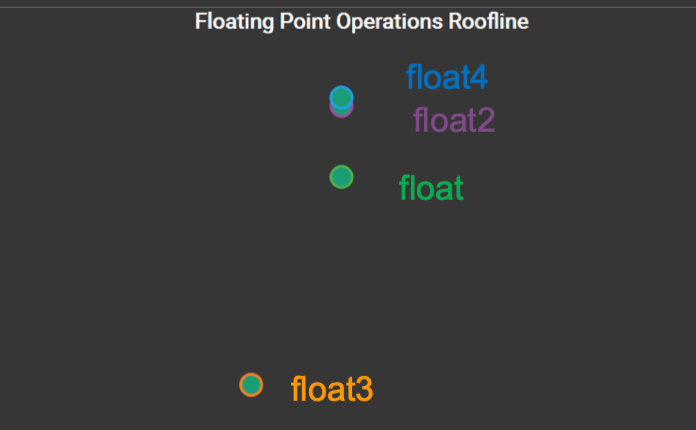
float->float2->float4 计算强度不变,性能提升
- Memory% 上升但 Compute% 下降 → 访存密集型特征
- 向量化访存倍数增加,Memory% 增加
-
float、float2、float4 ALU 的使用均高于 LSU,但 float3 反常明显高于 ALU 位居第一
-
ALU = Arithmetic Logic Unit(算术逻辑单元)
- 算术运算:加减乘除(对应算力指标FLOPS,即每秒浮点运算次数)
- 逻辑运算:与AND、或OR、非NOT、比较大小(比如
if (idx < n)里的判断)
-
LSU = Load/Store Unit(加载/存储单元)
- Load(加载):把数据从内存(显存/缓存)搬到寄存器里,交给ALU去算。
- Store(存储):把ALU算好的结果从寄存器搬回到内存里。
-
表示float3 反常的有更多的读写操作!
-
内存对齐
GPU 全局内存 (DRAM) 访问以内存事务 (transaction) 为单位(总线宽度等硬件设计决定)
→ 即便只需1字节数据,也必须搬运整个对应数据块
因为显存的物理结构就是呈矩阵排列的(行和列)当 LSU 发出一个读取指令时,DRAM 会直接把整行字线上对应的电荷状态读出来(感应放大器阵列被暂存到“扇区/行缓冲区”)拉出来。
- 内存事务的最小粒度通常是 32 bytes(64B,128B),缓存行逻辑上通常是 128 bytes
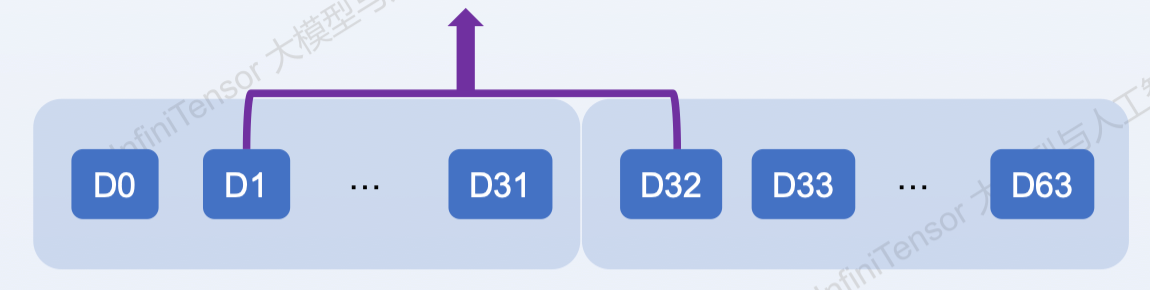
- 内存对齐:事务的起始地址应该对齐到事务大小的整数倍,没有对齐会导致触发两次事务
内存合并
CUDA 线程调度的最小单位为线程束 (warp) (不是每个线程单独调度哦)
→ CUDA 一个 warp 是 32 个线程
- 同一个周期内,一个 warp 中的线程统一执行同一条指令
- 内存合并 (Memory Coalescing):将同一 warp 的多个内存访问合并为少数事务,最大化内存带宽利用率
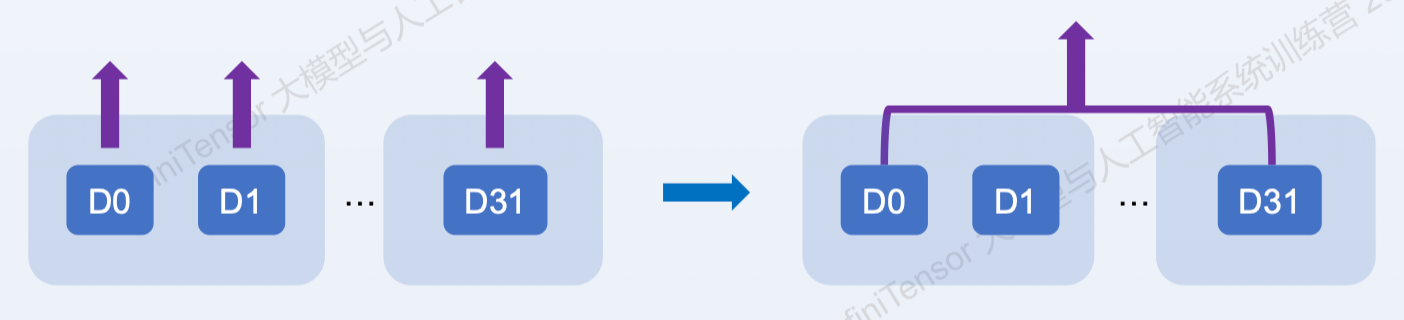
- Warp 中的线程需访问连续的内存地址
- 访问的起始地址必须满足架构对齐要求
- 限定:同 warp

但是用 float3 不能很好的对齐内存,float3 = 12 bytes,不是2的幂次,CUDA硬件只支持 1、2、4、8、16 字节的访问粒度→ 无法合并内存
因此编译器在处理 float3 时,必须将其拆解为三次 4 字节(float 大小)的独立操作来执行
PTX
PTX(Parallel Thread Execution)是 NVIDIA 定义的一种低级的并行线程执行的虚拟指令集(ISA),它位于CUDA C++/C 源代码和GPU 真正的机器码(SASS)之间
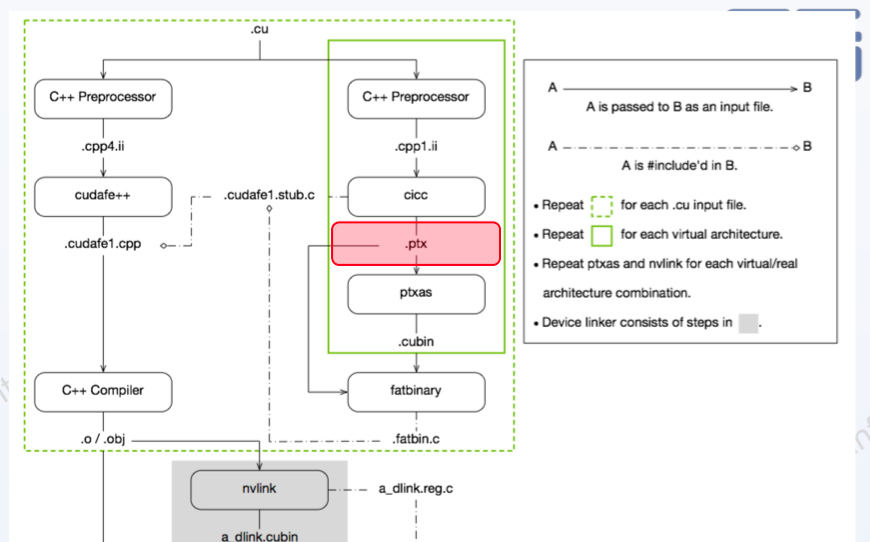
如果用 float4 (16字节),编译器生成的 PTX 指令是 一条:ld.global.v4.f32 (加载 4 个浮点数向量,一条指令拉取 16 字节)这意味着 LSU 只需发起一个事务,完美对齐
如果用 float3 (12字节),因为硬件指令集里根本没有 ld.global.v3.f32 这种一次搬 12 个字节的指令,编译器被迫将其拆解为 三条 标量指令:
ld.global.f32(第一次拉取 4 字节)ld.global.f32(第二次拉取 4 字节)ld.global.f32(第三次拉取 4 字节)
这就导致了三次独立的内存事务,无法合并
性能能否进一步提升?
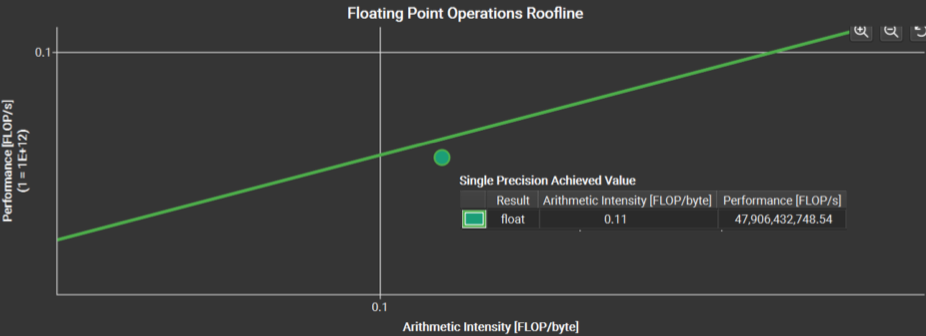
往上的进步空间太小了,那就尝试右移,也就是提高计算强度
𝐴𝐼 = 𝑊/𝑄
-
提高 W + 降低 Q
-
提高 W→ 增加计算量 → 算子融合
-
降低 Q→减少访存压力 → 如果传更少数据
- 半精度 (half)half/float16
- 在代码中需要
include <cuda_fp16.h>以使用CUDA 关于 fp16/half 的相关支持 - half2: CUDA 支持的内置半精度类型
- __hadd2(): SIMD 同时进行两组半精度数加法的内置函数
舍入模式(Rounding Mode)
一些类型转换函数会有不同的舍入模式版本
.rd, .ru, .rn, .rz
RD:Round Down, Round Toward Negative Infinity. E.g., -2.5 → -3.0
RU:Round Up, Round Toward Positive Infinity. E.g., -2.5 → -2.0
RN: Round-to-Nearest-Even, 四舍五入,但中间时会舍入到最近的偶数. E.g., -2.5 → -2.0
RZ: Round Toward Zero,向零方向舍入. E.g., -2.5 → -2.0
IEEE 754 默认 RN
COMMENTS
评论