向量规约
GPU的存储层级
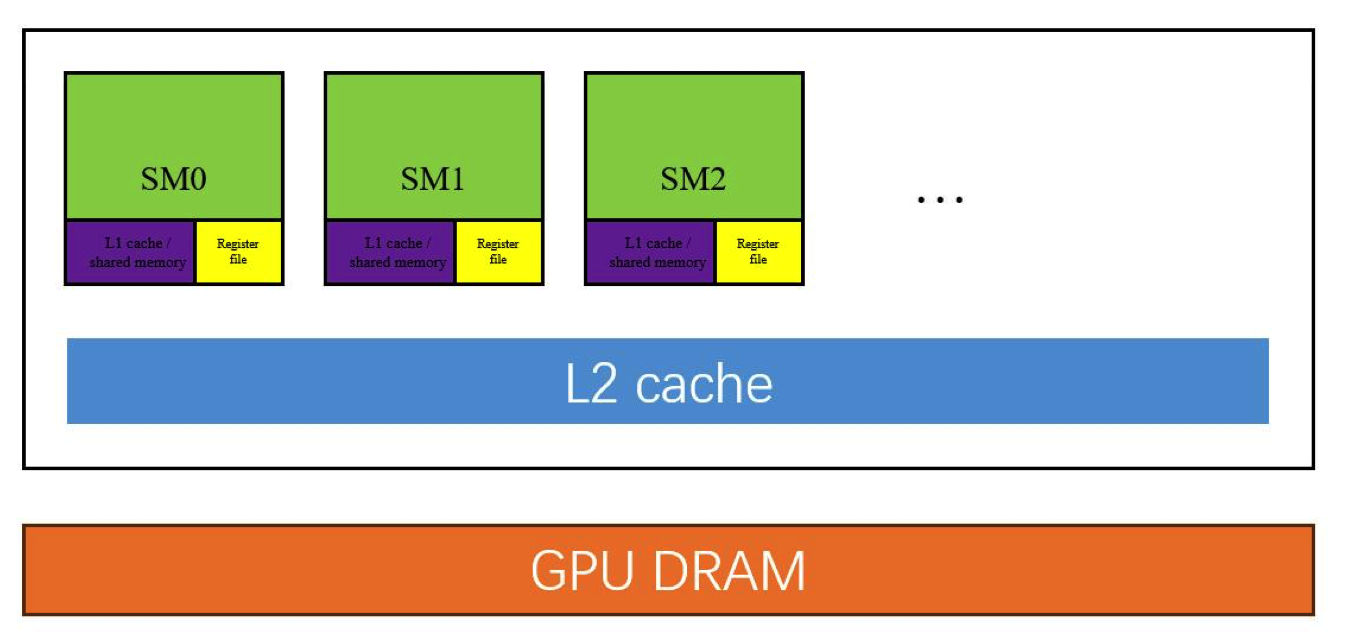
- GMEM: 显存,空间较大,访存较慢
- SMEM: 共享内存,空间较小,一个 Block 中多线程共享,访存较快(kernel优化核心空间)
- RMEM: 寄存器,线程私有,一个线程最多有255个,访存极快
-
GPU 的硬件调度器(GigaThread Engine)会把成千上万个 Block 分配给 SM。一个 Block 必须在一个 SM 上执行,而一个 SM 可以同时运行多个 Block。
- Block:
kernel<<<grid, block>>>Block 是手动划分的一批线程(比如 256 个线程)。它们有共享内存),有__syncthreads()同步机制。 - SM:物理核心,里面有 ALU(算力)、LSU(访存)、寄存器堆、共享内存/L1 缓存、Warp 调度器
- Block:
SM流处理器
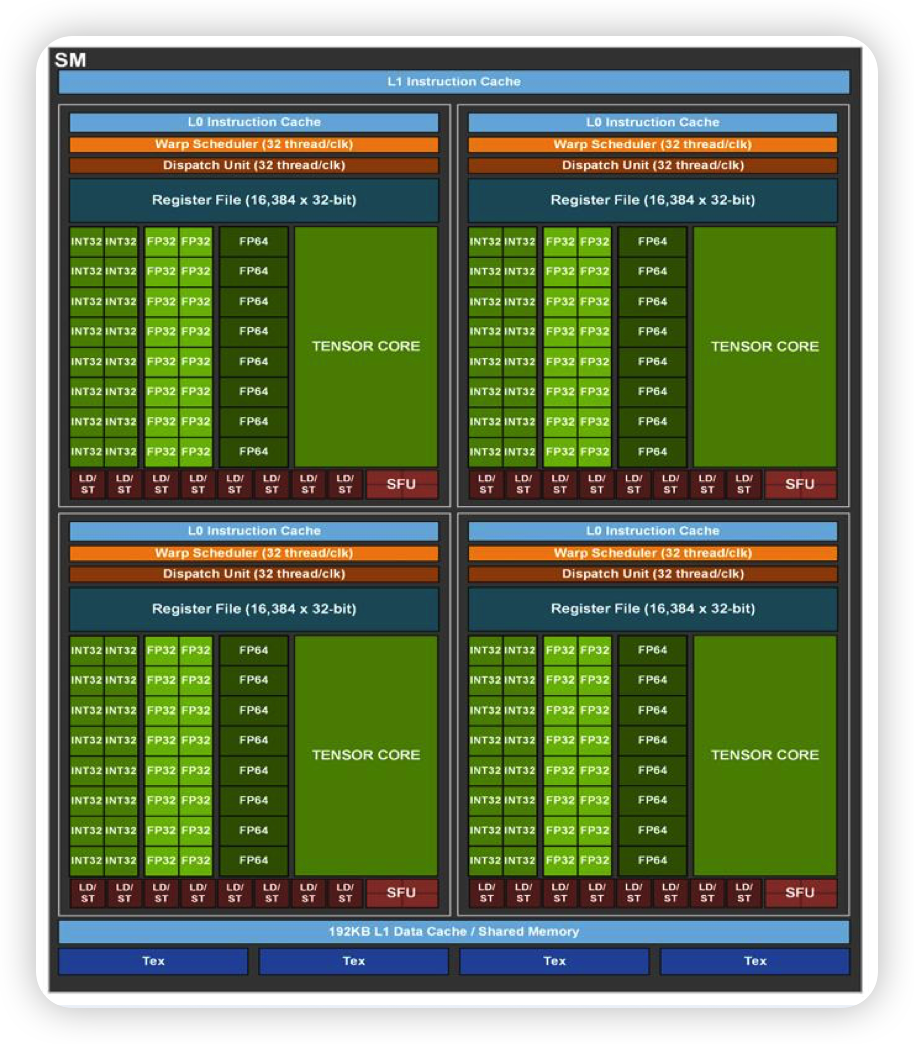
FP32:用于单精度浮点运算的 CUDA Core。这是最核心的算力单元INT32:用于整数运算的 CUDA Core。在 Ampere 架构中,部分 INT32 单元和 FP32 单元是共用硬件资源的,专门处理逻辑判断、循环计数器等FP64:用于双精度浮点运算的 CUDA Core,主要服务于传统科学计算LD/ST:加载/存储单元(LSU),负责数据读写SFU:特殊功能单元,用来算sin、cos、sqrt等超越函数
CUDA Kernel
__global__ 代表在CPU端调用,在GPU执行,不能有返回值
__device__ 在GPU端调用执行
__host__ 在CPU端调用执行
dim3是 CUDA 内置的一个结构体,包含三个无符号整数:x,y,z
dim3 grid(10, 10, 1); // 10x10 的网格,z 维度为 1
dim3 block(16, 16, 1); // 每个块有 16x16 个线程
kernel<<<grid, block>>>();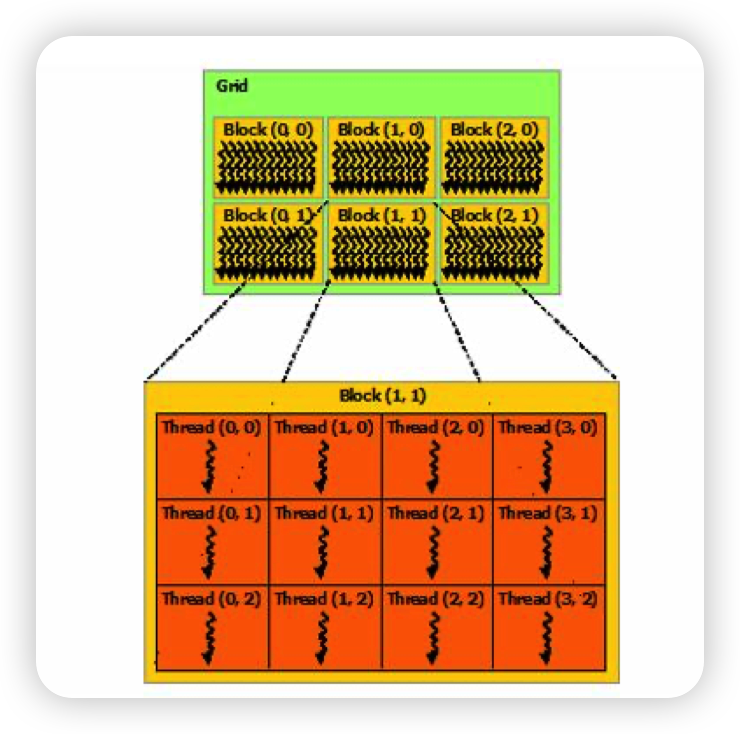
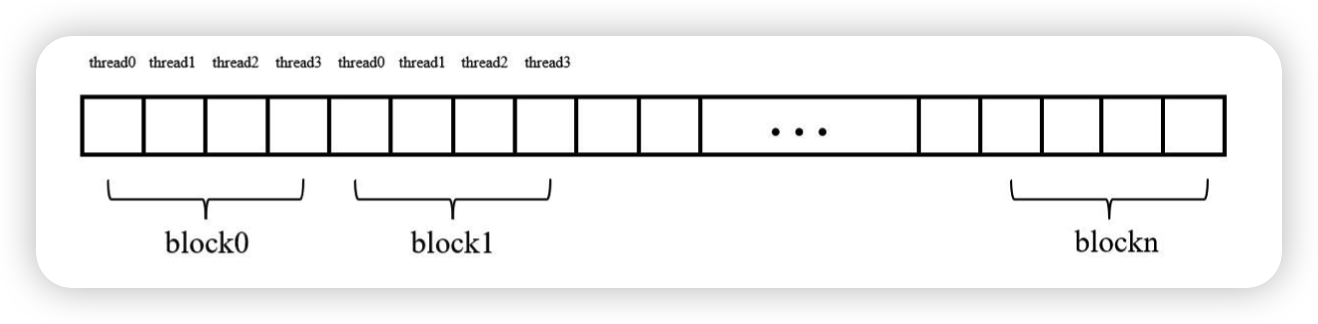
每个线程都有两种id:
- threadIdx:每个线程在所属Block中的id(以0为起始)
- idx:全局id,每个block按顺序排列,idx = blockidx * BLOCKDIM + threadIdx
Vector Add
- 准备显存:通过
cudaMalloc在 GPU 上分配了三个数组d_x,d_y,d_z,并使用cudaMemcpyHostToDevice把主机端(CPU)的数据h_x,h_y拷贝到 GPU 的d_x,d_y。
float *d_x, *d_y, *d_z;
CHECK_CUDA_ERR(cudaMalloc(&d_x, bytes));
CHECK_CUDA_ERR(cudaMalloc(&d_y, bytes));
CHECK_CUDA_ERR(cudaMalloc(&d_z, bytes));

CHECK_CUDA_ERR(cudaMemcpy(d_x, h_x.data(), bytes, cudaMemcpyHostToDevice));
CHECK_CUDA_ERR(cudaMemcpy(d_y, h_y.data(), bytes, cudaMemcpyHostToDevice));- 执行kernel:
block = 256表示每个线程块有 256 个线程grid = (N + block - 1) / block向上取整算法,保证即使 N 不能被 256 整除,也能覆盖所有数据
const int block = 256;
const int grid = (N + block - 1) / block;
vecAddKernel<<<grid, block>>>(d_x, d_y, d_z, N);
核函数定义:核函数中 idx = blockIdx.x * blockDim.x + threadIdx.x 计算全局唯一索引,if (idx < N) 用来防止越界访问(因为 grid 向上取整可能导致最后一个 block 里有空闲线程)
__global__ void vecAddKernel(const float* x, const float* y, float* z, int N) {
    int idx = blockIdx.x * blockDim.x + threadIdx.x;
    if (idx < N) {
        z[idx] = x[idx] + y[idx];
    }
}- 回传结果:使用
cudaMemcpyDeviceToHost把计算结果d_z从 GPU 拷回主机内存h_z_gpu
CHECK_CUDA_ERR(cudaMemcpy(h_z_gpu.data(), d_z, bytes, cudaMemcpyDeviceToHost));Vector Reduction
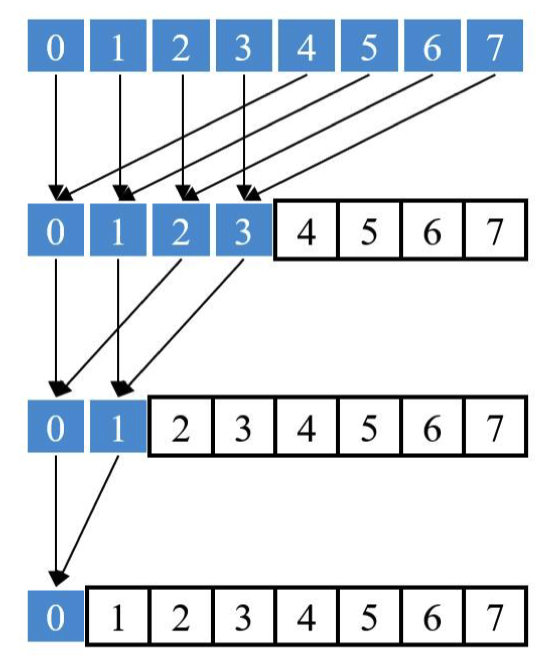
向量规约(Vector Reduction)是指对一个向量的所有元素应用某种二元操作(如加法、乘法、最大值),最终得到一个单一结果的过程。在串行计算中,这通常通过循环累加实现,但在并行计算中,可以利用多个线程同时处理不同元素,从而显著提高性能。
加上每个线程访问一个元素,想得到规约结果,线程之间需要交互信息。
- RMEM 线程私有
- SMEM BLOCK内的线程共享(需要注意BLOCK内同步)
- GMEM 跨BLOCK共享 (不推荐BLOCK之间同步)
Warp Reduction
- SIMT :全称 Single-Instruction, Multiple-Thread(单指令多线程)
- Warp:GPU 最基本的执行单元。一个 Warp 固定包含 32 个并行Thread。这些 Thread 以不同的数据资源,执行相同的指令
- 跨线程通信:通过特定指令,一个线程可以直接拿到同一个 Warp 内其他线程寄存器中的值,无需经过共享内存——
__shfl_down_sync
T __shfl_down_sync(unsigned mask, T val, int delta);mask:参与 shuffle 的线程掩码。一般全 warp 参与时用0xffffffff(32位全 1)val:当前线程要广播 / 传递的寄存器值delta:向下偏移步长。即tid = 当前tid + delta的线程数据传给自己
Block Reduction
先 Warp 内寄存器规约,再共享内存跨 Warp 规约
大幅减少对共享内存的读写次数,消除了 __syncthreads() 的大部分开销,并完美避开了 Bank Conflict
__shared__ float s_sum[BLOCK_SIZE];
s_sum[tid] = reg_sum;
__syncthreads();

for (int s = BLOCK_SIZE / 2; s > 0; s >>= 1) {
    if (tid < s) {
        s_sum[tid] += s_sum[tid + s];
    }
    __syncthreads();
}- 每轮都要读写共享内存并且进行一次全 Block 同步
// Warp 内规约(全在寄存器完成)
__device__ __forceinline__ float warp_reduce_sum(float val) {
    unsigned mask = 0xffffffff;
    for (int delta = 16; delta > 0; delta >>= 1) {
        val += __shfl_down_sync(mask, val, delta);
    }
    return val;
}

const int warp_id = tid / WARP_SIZE;
const int lane_id = tid % WARP_SIZE;

// 步骤1:每个Warp内部独立归约
float warp_sum = warp_reduce_sum(reg_sum);

if (lane_id == 0) {
    // 步骤2:每个Warp的Lane 0将结果写入共享内存
    s_warp_totals[warp_id] = warp_sum;
}

// 步骤3:同步,确保所有Warp都写完了
__syncthreads();

float block_sum = 0.0f;
if (tid < BLOCK_SIZE / WARP_SIZE) {
    // 步骤4:取前几个线程读取共享内存
    block_sum = s_warp_totals[tid];
}
if (warp_id == 0) {
    // 步骤5:第一个Warp再次对跨Warp的结果进行归约
    block_sum = warp_reduce_sum(block_sum);
}
// 最终由 tid==0 线程将 block_sum 原子加或写入全局内存- 每个 Warp 先在自己内部利用
__shfl_down_sync进行全寄存器归约,结果汇聚到各自的 Lane 0 - 每个 Warp 的 Lane 0 把结果写入共享内存
- 同步一次
__syncthreads(); - 第一个 Warp 负责读取这少量数据并再次进行 Warp 归约,得到整个 Block 的总和
COMMENTS
评论